Next best action: что это и как работает
Next best action — метод принятия решений: для одного клиента в один момент он выбирает из набора возможных действий единственный контакт с наибольшей ожидаемой ценностью, после того как правила и лимиты контактов отсеяли недопустимые варианты.
Next best action (NBA) — метод, который для каждого клиента в каждый момент выбирает один контакт, самый стоящий из возможных. Сначала он убирает действия, которые этому клиенту предлагать нельзя, затем оценивает остальные по вероятности отклика и ценности, а перед отправкой проверяет лимиты контактов. Лучшие системы оценивают изменение, которое вызывает само действие, а не только вероятность отклика.
- Автор
- Практика CRM и систем принятия решений; единого автора нет (общую схему описывают Pega и Salesforce), общепринятой даты нет
- Уровень
- 401 · Экспертный
- Подходит
- корпорация
- Время на внедрение
- две-четыре недели на первую версию из правил и ценности по одному каналу
- Что понадобится
- список действий, которые вы можете предпринять, у каждого — ответственный · данные о клиентах, по которым можно проверить допустимость действия · журнал откликов: что показали каждому клиенту и что он сделал дальше · холдаут — группа, которой не пишут и не звонят, даже если тест небольшой
Next best action (NBA) — метод, который для одного клиента в один момент выбирает единственный контакт, самый стоящий из возможных. Он вырос из практики CRM и машинного обучения, а не из работы одного автора, поэтому общепринятых автора и даты нет. Есть документация вендоров, и она описывает одну и ту же схему: Customer Decision Hub от Pega и Einstein Next Best Action от Salesforce превращают длинный список возможных действий в одну или несколько подсказок. Дальше решение разобрано по порядку, а в конце — два направления исследований, которые его улучшают.
Как принимается решение в next best action?
Решение проходит четыре этапа. Правила убирают действия, которые клиенту нельзя предлагать. Модель оценивает, насколько вероятно, что каждое из оставшихся сработает. Ценность превращает эту вероятность в рейтинг. Лимиты контактов решают, можно ли отправлять победителя. Порядок показан на схеме.
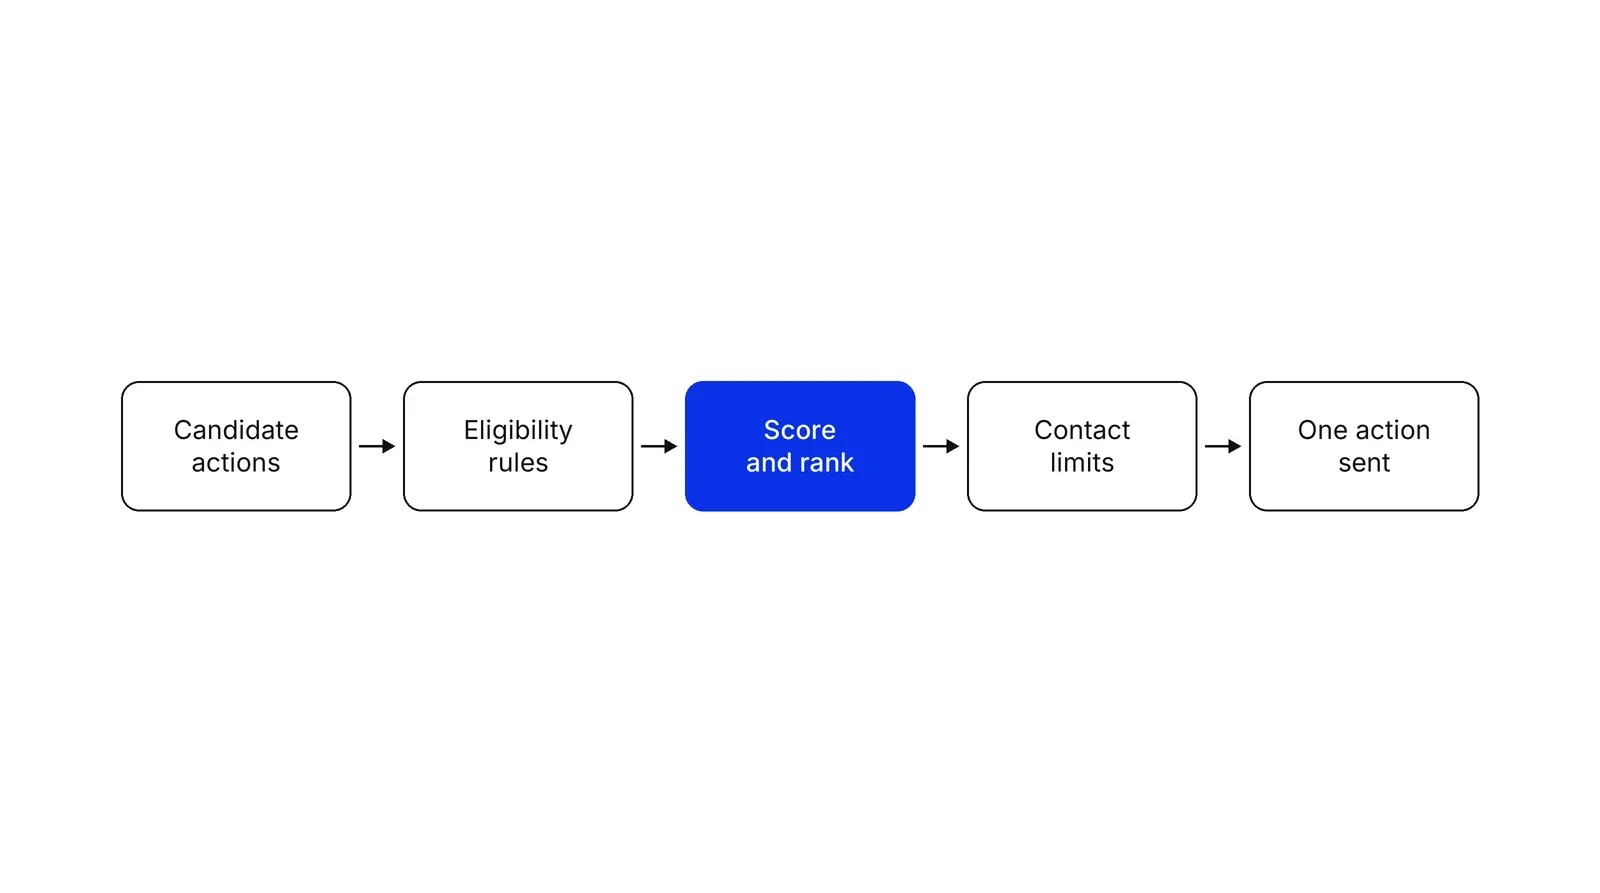
Место лимитов контактов в разных продуктах отличается, так что считайте этот порядок общей логикой, а не стандартом. Каждый этап разобран ниже.
Допустимость: что можно предложить этому клиенту?
Допустимость (eligibility) — набор жёстких правил, которые определяют, что клиенту вообще можно предложить. Учебные материалы Pega называют их строгими правилами о том, что законно и даже возможно предложить, например минимальный возраст для кредитной карты.
Pega делит политики взаимодействия на три слоя и применяет их в строгом порядке:
| Слой | Вопрос | Пример из Pega |
|---|---|---|
| Допустимость (Eligibility) | Это разрешено и возможно? | Gold Card — только с 18 лет |
| Применимость (Applicability) | Есть ли в этом смысл, учитывая то, что у клиента уже есть? | У клиента уже есть Platinum Card |
| Уместность (Suitability) | Подходит ли это именно этому человеку? | Отношение долга к доходу ниже порога |
Разделение важно, потому что слои ломаются по-разному. Ошибка допустимости — проблема соответствия закону. Ошибка уместности — раздражённый клиент. Держите все три слоя вне шага оценки, чтобы никакое большое число не могло перебить правило.
Склонность, ценность и арбитраж
Склонность (propensity) — предсказанная вероятность, что клиент откликнется на действие положительно; это число от 0 до 1. В Pega её считают адаптивные модели, которые обновляются по мере поступления исходов, по байесовскому методу или градиентным бустингом.
Ценность — сколько стоит успешный исход в деньгах за вычетом затрат. Одной вероятности мало: совет с шансом 30% и ценностью 50 ₽ проигрывает апгрейду с шансом 4% и ценностью 4000 ₽.
Арбитраж — шаг, который собирает всё это в один рейтинг. Формула Pega перемножает склонность (P), вес контекста (C), ценность для бизнеса (V) и управляющие коэффициенты (L) и выбирает наибольшее произведение. Вес контекста поднимает действие, которое подходит моменту, например удержание, когда клиент звонит закрыть счёт. Через управляющие коэффициенты бизнес сдвигает выбор к своей цели. Salesforce идёт другим путём: его стратегии фильтруют и сортируют записи с рекомендациями элементами Flow Builder, так что правило ранжирования вы пишете сами.
Политика контактов: когда лучше промолчать
Политика контактов ограничивает, как часто клиент о вас слышит. Pega выделяет два типа. Лимиты контактов задают потолок: сколько действий клиент получит по каналу за период, например два рекламных письма в месяц. Политики подавления откладывают действие после повторных исходов: если клиент дважды за 30 дней проигнорировал рекламу карты, действие приостанавливают на следующие 60.
Благодаря этим ограничениям NBA умеет отвечать «ничего не делать». Триггерная цепочка срабатывает каждый раз, когда происходит её событие. Система NBA видит все действия, которые претендуют на одного клиента, и может отложить их все.
Одной склонности мало: проблема аплифта
Склонность показывает, кто совершит действие. Она не показывает, кто совершит его из-за вашего контакта. Николас Рэдклифф и Патрик Сарри в 2011 году утверждали, что большая часть таргетированного маркетинга нацелена неинкрементальными моделями, хотя результат оценивают по инкрементальности. Моделирование аплифта (uplift) оценивает изменение, которое вызывает контакт, и для этого нужна контрольная группа.
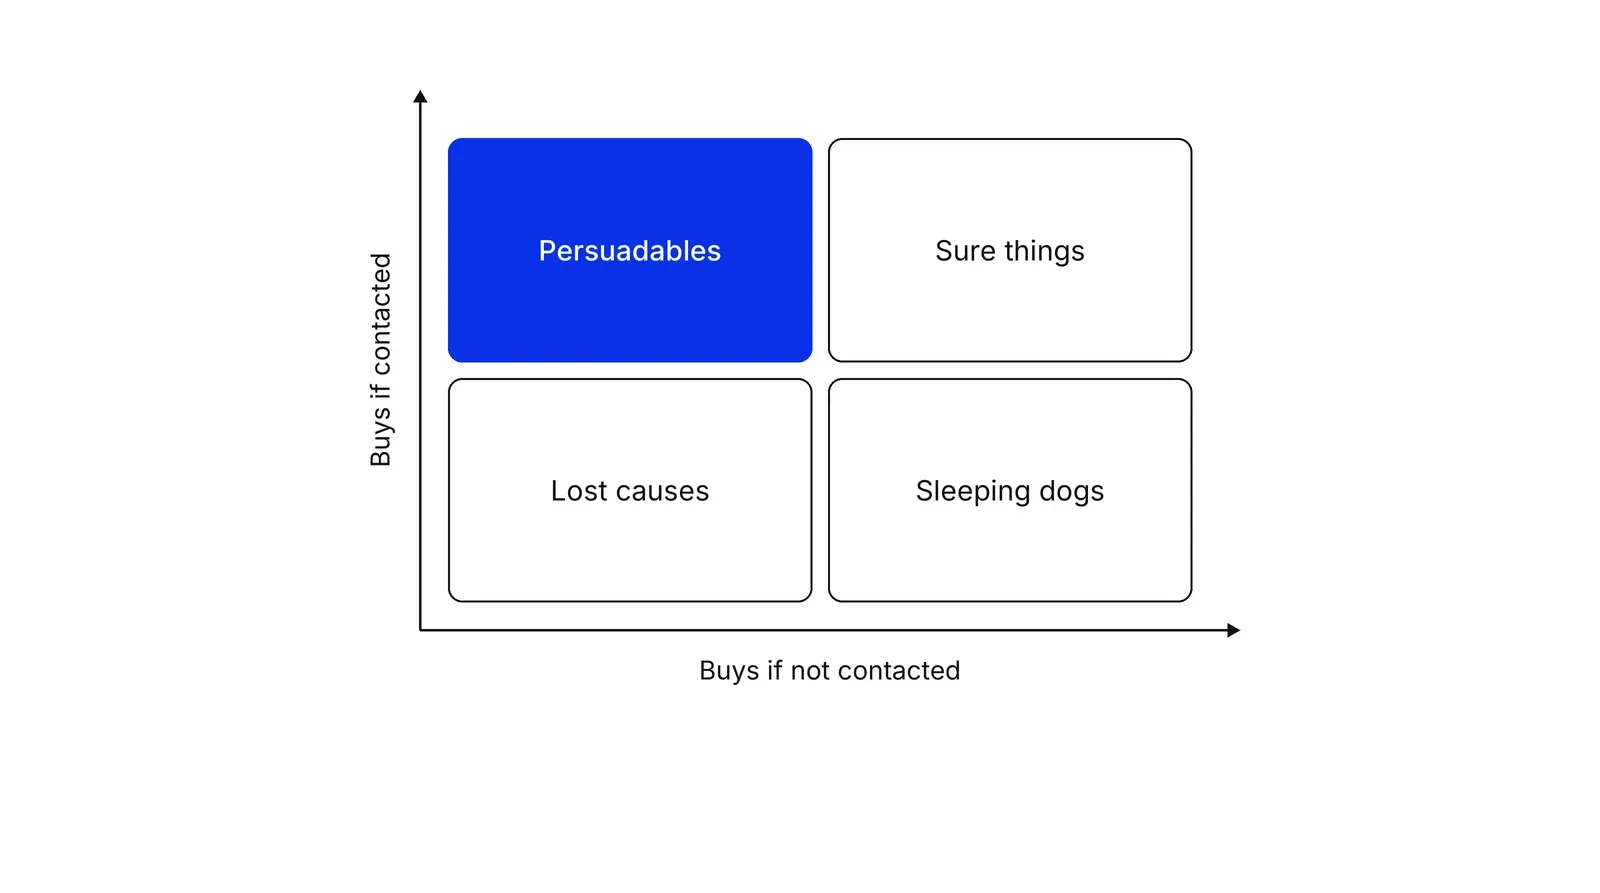
Таблица показывает почему. «Верные покупатели» (sure things) купят и так, «безнадёжные» (lost causes) не купят никогда, а «спящие собаки» (sleeping dogs) после контакта покупают меньше. Рэдклифф и Сарри отмечают, что работа с удержанием может обернуться против некоторых клиентов, а модель склонности этого не видит. В той же статье есть практическое правило для размера выборки: произведение общего аплифта на размер каждой группы должно быть не меньше 500, так что для аплифта 0,1% нужно по 500 000 клиентов и в тестовой, и в контрольной группе.
Исследования в маркетинге ведут к тому же. Ева Аскарса обнаружила на полевых данных оператора беспроводной связи и организации с членством, что таргетинг по приросту (lift) снижал отток сильнее, чем таргетинг по риску ухода. Лемменс и Гупта добавили прибыль клиента в функцию потерь и в двух полевых экспериментах получили более прибыльные кампании, чем у конкурирующих моделей. По методам: Гутьеррес и Жерарди делают обзор литературы по аплифту, а Хитч, Мисра и Чжан в тесте с почтовой рассылкой каталогов показали, что прямые оценки эффекта воздействия точнее непрямых Как вообще измерить эффект, рассказывает страница о тестах инкрементальности.
Контекстные бандиты: учиться, пока решаешь
Контекстный бандит — алгоритм, который выбирает одно действие с учётом того, что известно о клиенте, смотрит на результат и обновляется, балансируя между пробой новых действий и повтором лучшего. Для NBA он подходит, потому что система должна продолжать выбирать, пока учится.
Ли, Чу, Лэнгфорд и Шапире применили его к новостным статьям на главной странице Yahoo и сообщили о приросте кликов на 12,5% относительно бандита без контекста на выборке больше 33 миллионов событий. Шварц, Брэдлоу и Фейдер запустили бандита в медийной кампании банка на 750 миллионов показов и подняли привлечение на 8% против контроля. Они же подсчитали, что оптимизация по кликам вместо конверсий снизила бы привлечение примерно на 10%, — это предупреждение тем, кто выбирает целевой исход. Перед запуском команда может проверить политику на сохранённых данных с помощью оценки повторным воспроизведением или дважды робастных оценок.
Чем NBA отличается от соседних методов
| Метод | Что решает | Что нужно |
|---|---|---|
| RFM-анализ | Какие клиенты самые ценные | История покупок |
| Триггерные письма | Что отправить после события | Событие и сообщение |
| Маркетинг жизненного цикла клиента | Что нужно каждому этапу | Модель этапов |
| Next best action | Какое одно действие сейчас, из многих | Правила, оценки, ценности, лимиты |
NBA не заменяет остальные методы. Этапы жизненного цикла и сегменты RFM дают полезные входные данные для оценки, а триггеры часто входят в число кандидатов. План Growth Lab начинается с действий и правил, потому что модель — самая лёгкая часть.
Как применять: Next best action: что это и как работает по шагам
- Перечислите действия и правила. Запишите всё, что компания могла бы сделать с клиентом: звонок по продлению, скидка, совет по сервису, отсутствие контакта. Для каждого действия задайте жёсткое правило, кому его можно предлагать: возраст, согласие, продукт, который уже есть у клиента. Результат: каталог, где у каждого действия есть собственная проверка допустимости.
- Выберите один исход и оцените склонность. Для каждого действия определите исход, который важен, например принятие предложения в течение семи дней. Оцените для каждого клиента, насколько он вероятен. Для старта хватит простой модели на прошлых откликах. Результат: вероятность от 0 до 1 для каждой пары «клиент — действие».
- Назначьте каждому действию ценность. Оцените успешный исход в деньгах за вычетом стоимости самого действия. Продление на 4000 ₽ и совет на 50 ₽ нельзя ранжировать только по вероятности. Результат: одно число ожидаемой ценности на каждое действие.
- Проверьте инкрементальный эффект. Оставьте случайную долю клиентов без каждого действия и сравните исходы. Где получится, замените сырую склонность измеренной разницей. Результат: подтверждение, что действие меняет поведение, и список клиентов, на которых оно не действует.
- Задайте правило арбитража и лимиты контактов. Решите, как оценки складываются в один рейтинг, затем ограничьте, как часто можно связываться с одним клиентом и на какой срок откладывать действие, которое игнорируют. Результат: письменное правило, которое в любой день для любого клиента возвращает одно действие или ни одного.
- Запустите, ведите журнал и держите холдаут. Отправьте победителя, запишите, что произошло, и пересчитайте оценки на новых данных. Оставьте постоянный холдаут, чтобы измерять всю систему против варианта «ничего не делать». Результат: система принятия решений, которая может показать собственную пользу.
Примеры
Стоматология: кому позвонить в первую очередь
Иллюстративный пример. У администратора есть время на 40 звонков в день. Кандидаты: напоминание пациенту, который просрочил профилактический осмотр, контрольный звонок после установки пломбы и напоминание об оплате. Проверка допустимости убирает пациентов, отказавшихся от звонков. Оценка ранжирует остальных по шансу, что звонок приведёт к записи, умноженному на ценность этого приёма. Правило контактов не даёт звонить одному пациенту дважды за неделю. Администратор видит ранжированный список вместо таблицы.
Финтех-приложение выбирает одно из трёх сообщений
Иллюстративный расчёт. Предложение A, совет по накоплениям: вероятность принятия 10%, ценность 1000 ₽, ожидаемая ценность 100 ₽. Предложение B, апгрейд до премиальной карты: вероятность 4%, ценность 4000 ₽, ожидаемая ценность 160 ₽. Предложение C, напоминание о лимите по карте: вероятность 30%, ценность 50 ₽, ожидаемая ценность 15 ₽. Если ранжировать по вероятности, победит C. Если по ожидаемой ценности — B, пока такое правило, как проверка кредитной истории, не сделает клиента недопустимым для B: тогда выигрывает A.
Когда применять
Применяйте, когда есть несколько возможных контактов, хороший журнал откликов и столько клиентов, что выбирать вручную невозможно. Метод подходит банкам, операторам связи, страховщикам, клиникам с программами повторных визитов и подписочным продуктам, где одному клиенту можно отправить много разных сообщений.
Когда не применять
Не берите его, если у вас один продукт, один канал или несколько сотен клиентов: хватит цепочки триггерных писем или списка сегмента. Не берите там, где закон определяет, кому и когда нужно писать. Без журнала откликов и холдаута шагу оценки не на чем учиться.
Частые ошибки
- Ранжируют только по склонности. Клиент, который купил бы и так, получает высокий балл и скидку впустую. Где можно измерить, ранжируйте по инкрементальному эффекту, умноженному на ценность.
- Принимают правило за оценку. Допустимость — это «да» или «нет», и проверять её нужно до ранжирования. Если смешать юридические правила и согласие с взвешенной оценкой, большое число может их перебить.
- Не задают лимиты контактов. Каждое действие по отдельности выглядит хорошо, а вместе они заваливают клиента. Ограничьте число контактов по каналу и откладывайте действия, которые игнорируют.
- Никогда не пробуют новое. Модель, которая всегда отправляет текущего лучшего, так и не узнает, не лучше ли новое. Выделите небольшую долю контактов под проверку.
- Пропускают холдаут. Без группы, которой ничего не отправляют, нельзя понять, даёт ли система что-то сверх прежнего календаря рассылок.
Вопросы и ответы
Что такое next best action в маркетинге?
Next best action — метод, который решает, какой один контакт с клиентом сделать прямо сейчас. Он проверяет, какие действия клиенту можно предлагать, оценивает их по вероятности и ценности, применяет лимиты контактов и возвращает победителя. Это может быть предложение, сервисное сообщение, звонок или отсутствие контакта вовсе.
По какой формуле считают next best action?
Универсальной формулы нет. В документации Pega перемножают четыре числа: склонность, вес контекста, ценность для бизнеса и управляющие коэффициенты, а побеждает наибольшее произведение. Salesforce формулу не предписывает: его стратегии фильтруют и сортируют записи с рекомендациями по правилам, прогнозным моделям и другим данным, а порядок задаёте вы.
Что подсказывает менеджеру функция next best action?
В момент разговора с клиентом она показывает короткий список рекомендованных действий. В Salesforce у каждой рекомендации есть описание, текст кнопки и связанный сценарий (flow), а пользователь может принять её или отклонить. Ответ попадает в журнал и может вернуться в оценку, так что подсказки со временем улучшаются.
Чем склонность отличается от аплифта?
Склонность — вероятность, что клиент сделает что-то, например купит. Аплифт (uplift) — изменение этой вероятности, вызванное контактом. У клиента со склонностью 60%, который купит и так, аплифт почти нулевой. Для оценки аплифта нужна контрольная группа: одного и того же клиента нельзя увидеть и с контактом, и без него.
Как контекстные бандиты связаны с next best action?
Контекстный бандит — алгоритм, который выбирает одно действие с учётом контекста клиента, смотрит на результат и обновляется, балансируя между пробой новых действий и повтором лучшего из известных. Это способ вести шаг оценки так, чтобы он продолжал учиться; исследования новостной и медийной рекламы показывают, что бандит может обгонять фиксированные правила.
Источники
- Pega Academy, Action arbitration
- Pega Academy, Customer engagement policies
- Pega Academy, Contact policy types
- Pega Academy, Adaptive models
- Salesforce Help, Suggest Options with Recommendation Strategies
- Salesforce Help, Get Started with Einstein Next Best Action
- Nicholas J. Radcliffe, Patrick D. Surry, Real-World Uplift Modelling with Significance-Based Uplift Trees, Stochastic Solutions, 2011
- Pierre Gutierrez, Jean-Yves Gérardy, Causal Inference and Uplift Modelling: A Review of the Literature, PMLR 67, 2017
- Piotr Rzepakowski, Szymon Jaroszewicz, Decision trees for uplift modeling with single and multiple treatments, Knowledge and Information Systems, 2012
- Susan Athey, Guido Imbens, Recursive Partitioning for Heterogeneous Causal Effects, arXiv 1504.01132
- Sören Künzel, Jasjeet Sekhon, Peter Bickel, Bin Yu, Meta-learners for Estimating Heterogeneous Treatment Effects using Machine Learning, arXiv 1706.03461
- Eva Ascarza, Retention Futility: Targeting High-Risk Customers Might Be Ineffective, Journal of Marketing Research, 2018 (American Marketing Association award notice)
- Aurélie Lemmens, Sunil Gupta, Managing Churn to Maximize Profits, Marketing Science 39(5), 2020
- Günter Hitsch, Sanjog Misra, Walter Zhang, Heterogeneous treatment effects and optimal targeting policy evaluation, Quantitative Marketing and Economics 22(2), 2024
- Lihong Li, Wei Chu, John Langford, Robert Schapire, A Contextual-Bandit Approach to Personalized News Article Recommendation, WWW 2010
- Lihong Li, Wei Chu, John Langford, Xuanhui Wang, Unbiased Offline Evaluation of Contextual-bandit-based News Article Recommendation Algorithms, WSDM 2011
- Olivier Chapelle, Lihong Li, An Empirical Evaluation of Thompson Sampling, NIPS 2011
- Daniel Russo and others, A Tutorial on Thompson Sampling, Foundations and Trends in Machine Learning, 2018
- Shipra Agrawal, Navin Goyal, Thompson Sampling for Contextual Bandits with Linear Payoffs, arXiv 1209.3352
- Aleksandrs Slivkins, Introduction to Multi-Armed Bandits, Foundations and Trends in Machine Learning, 2019
- Miroslav Dudík, John Langford, Lihong Li, Doubly Robust Policy Evaluation and Learning, ICML 2011
- Eric Schwartz, Eric Bradlow, Peter Fader, Customer Acquisition via Display Advertising Using Multi-Armed Bandit Experiments, Marketing Science 36(4), 2017
Обновлено 20 октября 2026

Маркетинговое агентство или система роста: что нужно на каждом этапе масштабирования
Агентство подходит, пока фаундер сам ведёт большую часть процессов. Когда бизнес начинает копировать себя в новые точки и регионы, нужна система, которая ставит цели, проверяет гипотезы и отвечает за результат.
Агентство медицинского маркетинга: почему работа с клиникой буксует и какую модель используем мы
Большинство агентств отвечают за клик, а за регистратуру не отвечает никто. Как мы строим маркетинг клиники в трёх горизонтах, на каких исследованиях это основано и что дал один год работы.
Тестирование рекламных каналов: почему тест затухает на третьем месяце
Большинство тестов нового рекламного канала заканчиваются не решением. Они заканчиваются, когда кончился бюджет, поменялась атрибуция или все тихо перестали открывать дашборд.