Статистическая значимость: что это и как проверить
Статистическая значимость — вывод о том, что измеренная разница слишком велика, чтобы объяснять её одной случайностью. Обычно это значит, что p-value ниже порога, заданного заранее, чаще всего 0,05.
Статистическая значимость означает: измеренная разница, например более высокая конверсия в варианте B, была бы необычной, если бы настоящей разницы между вариантами не было. Её объявляют, когда p-value ниже порога, выбранного до теста, чаще всего 0,05. О размере разницы, о её ценности для бизнеса и о вероятности того, что результат верен, значимость ничего не говорит.
- Автор
- Рональд Фишер (тесты значимости); Ежи Нейман и Эгон Пирсон (частота ошибок и правила решения), 1925; с 1928
- Уровень
- 201 · Инструмент
- Подходит
- малый и средний бизнес, растущая компания
- Время на внедрение
- 30 минут, чтобы записать правило решения перед следующим тестом
- Что понадобится
- тест с основной метрикой и заранее рассчитанным размером выборки · порог: наименьший прирост, который изменил бы решение · сырые счётчики по обоим вариантам, а не только вердикт из дашборда
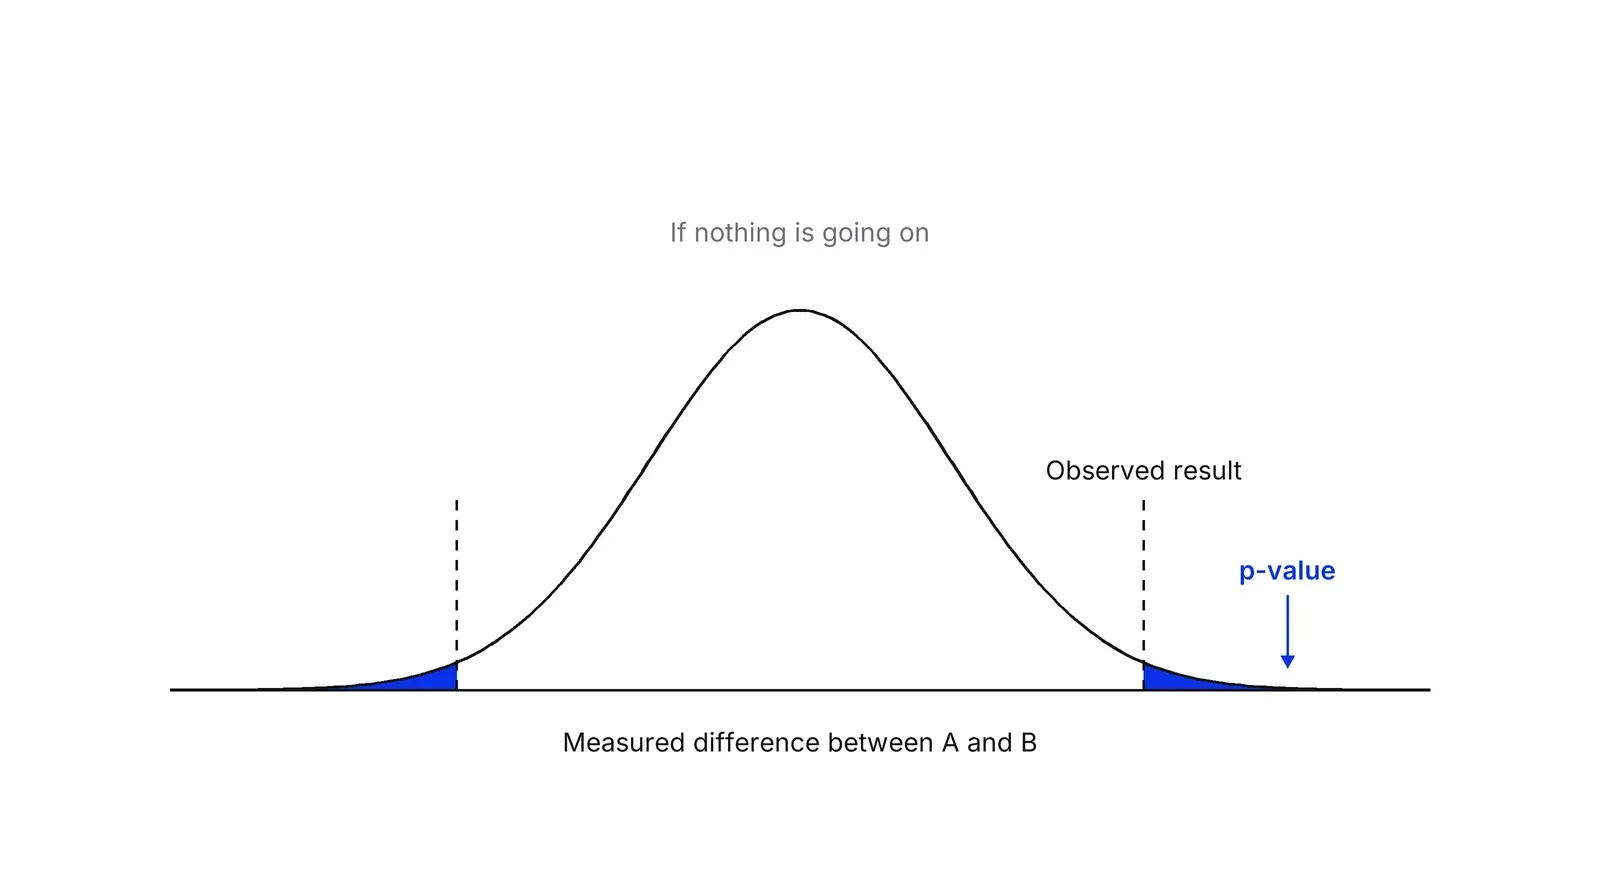
Статистическая значимость — это отметка для результата, который был бы необычен, если бы настоящей разницы не было. В A/B-тесте вы сначала допускаете, что варианты работают одинаково, а потом спрашиваете: как часто один лишь случай даёт разрыв не меньше того, что вы увидели? Эта доля называется p-value. Если она ниже порога, выбранного заранее (обычно 5%), результат считают значимым. Отметка отвечает на один узкий вопрос, а большинство ошибок возникает, когда от неё ждут ответа ещё на три: насколько велик эффект, важен ли он и верен ли он.
Откуда взялась граница 0,05
Граница в 5% — договорённость, и пришла она из двух школ, которые позже смешали. В книге «Статистические методы для научных работников» (1925) Рональд Фишер показал, что отклонение примерно в два стандартных отклонения оставляет шанс 1 из 20, и написал, что этот порог «удобно принять за предел». Для Фишера p-value было мерой свидетельства против нулевой гипотезы, то есть допущения, что разницы нет.
Ежи Нейман и Эгон Пирсон с 1928 года построили другой метод. В нём заранее фиксируют уровень значимости (альфа) и мощность, называют альтернативную гипотезу и рассматривают тест как правило решения с известной долей ошибок на длинной дистанции. В обучающей статье 2015 года Хосе Перезгонсалес разбирает оба подхода и называет сегодняшнюю проверку нулевой гипотезы (NHST) их смесью.
| Фишер | Нейман и Пирсон | Типичная практика A/B-тестов | |
|---|---|---|---|
| Роль p-value | Свидетельство против нулевой гипотезы | Сравнивается с заранее заданной альфой | И то и другое, часто вперемешку |
| Альтернативная гипотеза | Только подразумевается | Явная, с размером эффекта | Часто пропускается |
| Мощность | Не используется | Планируется заранее | Планируется, если команда считает размер тестов |
| Результат | Градуированная сила свидетельства | Отвергнуть или не отвергнуть | Зелёный или красный значок |
Что p-value говорит и чего не говорит
p-value — это вероятность увидеть данные не менее экстремальные, чем ваши, если нулевая гипотеза и все остальные допущения модели верны. В документации Statsig это формулируют так: насколько удивительным был бы результат, если бы изменение ничего не делало.
В марте 2016 года Американская статистическая ассоциация выпустила заявление о p-value; правление впервые высказалось по таким вопросам. В шести принципах сказано, что p-value не измеряет вероятность истинности гипотезы, что решения нельзя принимать только по тому, прошло ли p-value порог, и что p-value не измеряет ни размер эффекта, ни его важность. Сандер Гринланд с коллегами перечисляют 25 неверных прочтений. Первое из них — убеждение, что p-value есть вероятность истинности проверяемой гипотезы.
Поэтому p = 0,03 не означает 97% шансов на то, что вариант B лучше. Некоторые инструменты, например «шанс на победу» в GrowthBook, действительно показывают вероятность того, что B обгоняет A. Но она берётся из байесовской модели, о которой рассказано на странице про последовательное и байесовское тестирование.
Значимо не значит «стоит выкатывать»
Значимый результат говорит, что эффект, вероятно, существует. Достаточно ли он велик, чтобы действовать, он не говорит. Совет Statsig: по p-value решать, есть ли эффект, а по доверительному интервалу — насколько он велик. Кохави с коллегами тоже рекомендуют указывать рядом с результатом теста доверительный интервал для эффекта.
На рисунке ниже — арифметика трёх иллюстративных тестов страницы оплаты с базовой конверсией 5% и предполагаемым наименьшим приростом, который стоит выкатывать, в 0,2 пункта.
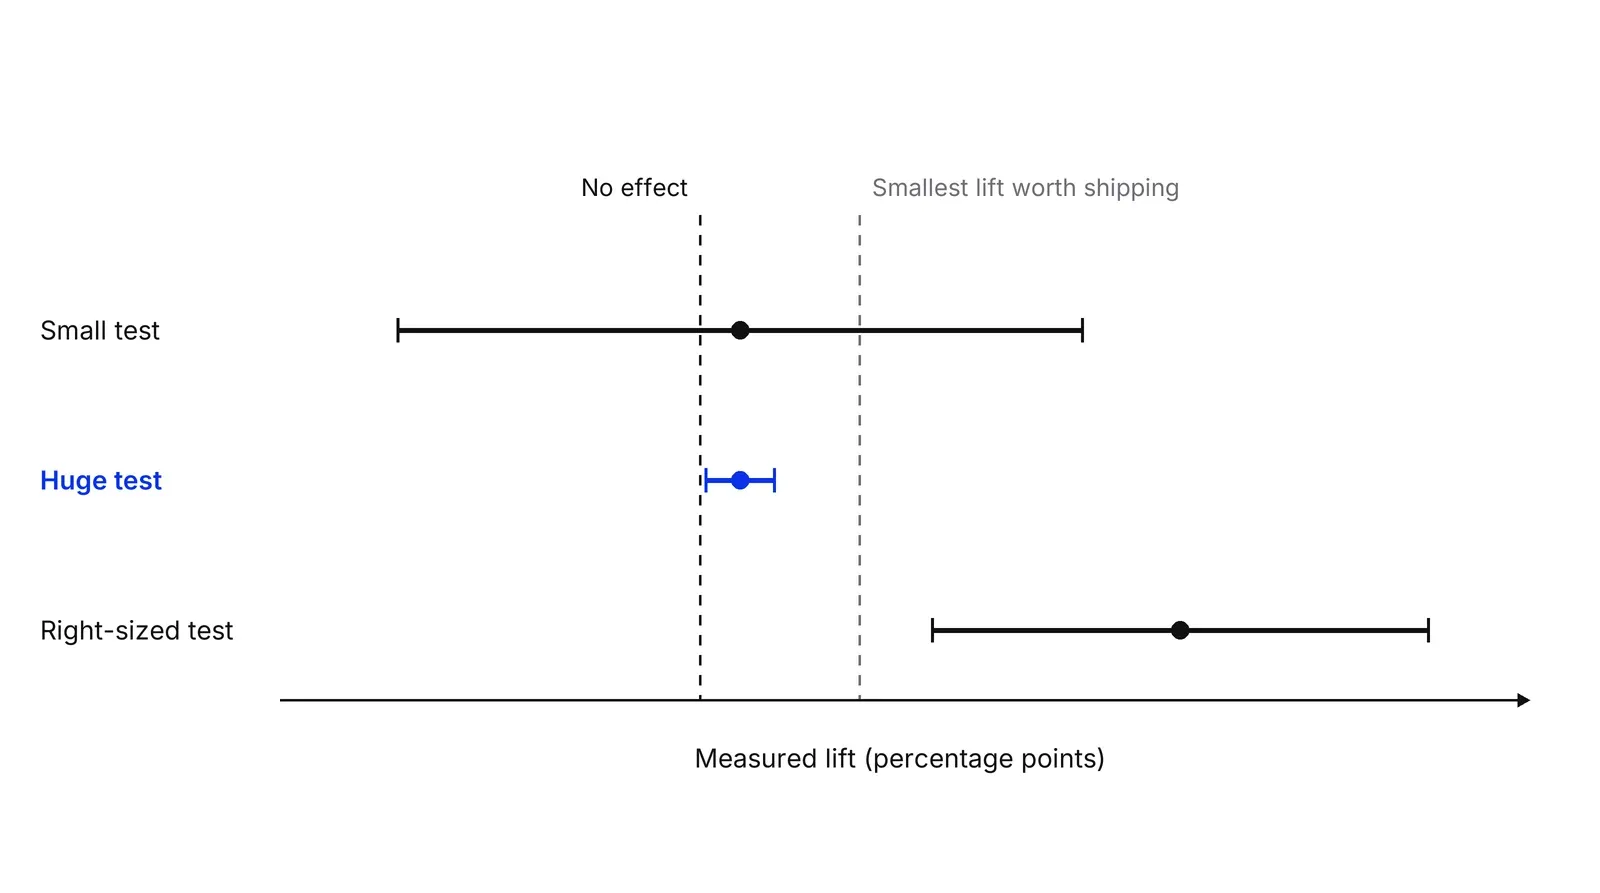
У маленького теста (20 000 пользователей на вариант, 5,00% против 5,05%) p = 0,82, а интервал — от −0,38 до +0,48 пункта. Он не исключает ни полезный прирост, ни потерю. У огромного теста (2 000 000 на вариант, та же наблюдаемая разница) p = 0,022, интервал — от 0,007 до 0,093 пункта. Он значим и всё равно слишком мал, чтобы иметь значение. У теста правильного размера (40 000 на вариант, 5,0% против 5,6%) p = 0,0002, интервал — от 0,29 до 0,91 пункта, то есть правее обеих линий. Как планировать размер теста под наименьший важный прирост, рассказано на странице про минимальный детектируемый эффект и размер выборки.
Как часто значимый результат неверен
Чаще, чем в 5% случаев. Пять процентов относятся к проверке идей, которые ничего не меняют, а сколько таких идей у вас, никто не знает. Доля ложных срабатываний среди значимых результатов зависит от доли настоящих идей среди проверенных. Бенджамин с коллегами дают формулу: альфа × доля истинных нулевых гипотез, делённая на то же слагаемое плюс мощность × доля настоящих эффектов. Наш расчёт при мощности 80%:
| Доля настоящих идей среди проверенных | Ошибочных среди значимых при 0,05 | При 0,005 |
|---|---|---|
| 50% | 5,9% | 0,6% |
| 20% | 20% | 2,4% |
| 10% | 36% | 5,3% |
Бенджамин с коллегами приходят к тому же: при априорных шансах 1:10 доля ложных срабатываний выше 33%. Они предлагают для новых открытий сдвинуть порог по умолчанию до 0,005, а результаты между 0,005 и 0,05 называть «наводящими на мысль». Цена такого решения — выборки примерно на 70% больше при той же мощности. Дэвид Колкхун с разных сторон доказывал, что при p = 0,05 доля ложных открытий не ниже 30%. Джон Иоаннидис ещё в 2005 году привёл общий довод: маленькие выборки, маленькие эффекты и множество проверяемых связей делают ложные находки более вероятными.
Новый единый порог принимают не все. Большая группа исследователей ответила в том же журнале статьёй «Justify your alpha», а в комментарии Nature 2019 года Амрхайн, Гринланд и Макшейн при поддержке более 800 подписантов призвали прекратить раздутые заявления и отбрасывание эффектов, которые могут иметь значение. Для команды роста вывод практический: выбирайте альфу по цене ошибки, записывайте её до запуска и ведите журнал прошлых тестов, чтобы знать собственную долю настоящих побед. Как это устроено, описано на странице про программу экспериментов.
Много метрик, много сегментов, много просмотров
Каждое лишнее сравнение — ещё один шанс, что шум перейдёт черту. При 20 независимых сравнениях и пороге 5% вероятность хотя бы одного ложного срабатывания равна 1 − 0,95^20, то есть 64% (наш расчёт). В работе 2011 года Симмонс, Нельсон и Симонсон показали, что свобода выбора метрик и момента остановки может сделать ложный результат более вероятным, чем верный. Одно средство — контроль доли ложных открытий, как в методе Бенджамини и Хохберга 1995 года. Более простое — назвать одну основную метрику до запуска. Повторные проверки идущего теста ломают гарантию по похожей причине; Джохари, Пекелис и Уолш решают это «всегда валидными» p-value.
Есть ещё две частые ловушки. Гельман и Стерн отметили: разница между «значимо» и «незначимо» сама по себе не значима. Поэтому сегмент, перешедший 0,05, рядом с сегментом, не перешедшим, ничего не доказывает о разрыве между ними. И результат, который выглядит слишком хорошо, надо подозревать: Кохави и Томке описывают тест заголовка в Bing, который поднял выручку на 12% и сработал на сигнал «слишком хорошо, чтобы быть правдой». Команда Кохави также рекомендует непрерывные A/A-тесты: они должны оказываться незначимыми в 95% случаев. Кроме того, нужно проверять, что пользователи разделены в запланированных пропорциях.
Что указывать вместо значка
Указывайте оценку, её интервал и решение, а p-value считайте одним из входных данных. В редакционной статье 2019 года в The American Statistician Вассерстайн, Ширм и Лазар пошли дальше и призвали исследователей вовсе отказаться от выражения «статистически значимо». В бизнесе тот же совет превращается в привычку: сводка теста «+0,6 пункта, интервал 0,29–0,91, p = 0,0002, выкатываем» несёт больше, чем зелёная галочка. План Growth Lab начинается с такого же правила решения, записанного до первого теста.
Как применять: Статистическая значимость: что это и как проверить по шагам
- Запишите правило решения до запуска. Зафиксируйте уровень значимости (обычно 5%), основную метрику и наименьший прирост, ради которого стоит выкатывать изменение. Под этот прирост рассчитайте размер теста. Результат: одно предложение о том, какой исход означает «выкатываем», «останавливаем» или «запускаем заново».
- Проверьте, что тест исправен. Убедитесь, что трафик разделился в запланированных пропорциях и что настройка проходит A/A-тест: в нём значимая разница должна появляться примерно в 5% случаев. Результат: ответ «да» или «нет» на вопрос, можно ли вообще доверять цифрам.
- Смотрите на интервал, а не только на p-value. Возьмите доверительный интервал для разницы и сравните его целиком с наименьшим приростом, который стоит выкатывать. Результат: диапазон правдоподобных эффектов вместо печати «прошёл» или «не прошёл».
- Посчитайте, что вы сравнивали. Выпишите все метрики, сегменты и просмотры данных, на которых держится решение. Если вы проверили 20 сегментов, ждите ложного срабатывания среди них. Результат: честное число сравнений и либо более строгий порог, либо чётко помеченная гипотеза для всего, что выходит за основную метрику.
- Запишите вердикт из трёх частей. Укажите оценку с интервалом, p-value и решение. Добавьте, что заставило бы вас передумать. Результат: абзац для журнала экспериментов.
Примеры
Кнопка онлайн-записи в клинике
Иллюстративный пример. Стоматологическая клиника тестирует новую кнопку записи на 20 000 посетителей в каждом варианте. Конверсия в запись — 5,00% и 5,05%, p = 0,82, интервал для прироста — от −0,38 до +0,48 процентного пункта. Тест не значим, но и слишком мал, чтобы что-то показать: интервал всё ещё допускает прирост, ради которого стоит работать. Решение — повторить тест с выборкой, рассчитанной под наименьший полезный прирост.
Оплата в платёжном сервисе и огромный тест
Иллюстративный пример. Платёжный сервис тестирует изменение в оплате на 2 000 000 пользователей в каждом варианте. Конверсия растёт с 5,00% до 5,05%, p = 0,022, то есть результат значим, а интервал — от 0,007 до 0,093 процентного пункта. Если команда решила, что всё меньше 0,2 пункта не стоит времени разработчиков, значимость решения не меняет.
Отчёт по сегментам для пробного периода SaaS
Иллюстративный пример. Команда режет один тест на 20 сегментов и находит один с p = 0,03. При 20 независимых сравнениях и пороге 5% вероятность хотя бы одного ложного срабатывания — 64%. Сегмент становится гипотезой для следующего теста, а не результатом.
Когда применять
Проверка значимости нужна, когда вы проводите контролируемый эксперимент с заранее рассчитанной выборкой и основной метрикой, а решение зависит от того, настоящее изменение перед вами или шум. Она хорошо защищает от действий по случайным скачкам конверсии или выручки.
Когда не применять
Не опирайтесь на p-value как на единственное основание для бизнес-решения. Не используйте его, чтобы ранжировать множество идей, найденных в данных постфактум, или чтобы доказать, что два варианта одинаковы. Незначимый результат в маленьком тесте говорит, что тест был слаб, а не что ничего не произошло.
Частые ошибки
- Читать p = 0,03 как 97%-ную вероятность того, что вариант лучше. p-value считают в предположении, что настоящей разницы нет, поэтому вероятность превосходства варианта оно дать не может.
- Путать значимость с важностью. При достаточном трафике значимым становится даже ничтожное изменение.
- Принимать незначимый результат за доказательство отсутствия эффекта и отказываться от идеи.
- Нарезать результат на множество сегментов или метрик постфактум и докладывать тот, что перешёл 0,05.
- Сравнивать два сегмента по принципу «в одном значимо, в другом нет», хотя разницу между ними никто не проверял.
Вопросы и ответы
Какой уровень статистической значимости считать хорошим?
По умолчанию берут 5% (p ниже 0,05), но это договорённость, а не закон. Фишер в 1925 году назвал этот порог удобным. Продуктовой команде стоит задать уровень до теста по цене ошибки: строже для дорогого или трудно обратимого изменения, мягче для дешёвого и обратимого.
Значит ли p = 0,05, что я на 95% уверен в результате?
Нет. Американская статистическая ассоциация подчёркивает: p-value не измеряет вероятность того, что проверяемая гипотеза верна. p = 0,05 говорит лишь, что такие данные были бы необычны, если бы эффекта не было. Вероятность настоящего результата зависит ещё и от того, насколько правдоподобной идея была до теста.
Чем статистическая значимость отличается от практической?
Статистическая значимость говорит, что разница вряд ли случайна. Практическая значимость отвечает, достаточно ли она велика, чтобы повлиять на выручку, затраты или риск. Огромная выборка делает значимым даже крошечный прирост, поэтому сравнивайте доверительный интервал с наименьшим приростом, ради которого стоит действовать.
Как проверить статистическую значимость различий между двумя вариантами?
Сравните два показателя двухвыборочным тестом: z-тестом для конверсий или t-тестом для средних. Укажите разницу, её доверительный интервал и p-value. Размер выборки рассчитайте заранее и доведите тест до него: подглядывание в середине теста увеличивает долю ложных срабатываний.
Источники
- American Statistical Association, ASA releases statement on statistical significance and p-values, March 2016
- Ronald L. Wasserstein, Allen L. Schirm, Nicole A. Lazar, Moving to a world beyond p < 0.05, The American Statistician 73(S1), 2019
- Ronald A. Fisher, Statistical Methods for Research Workers, chapter III, 1925 (Classics in the History of Psychology)
- Jose D. Perezgonzalez, Fisher, Neyman-Pearson or NHST? A tutorial for teaching data testing, Frontiers in Psychology 6, 2015
- Daniel J. Benjamin et al., Redefine statistical significance, Nature Human Behaviour 2, 2018
- Daniel Lakens et al., Justify your alpha, Nature Human Behaviour 2, 2018
- Sander Greenland et al., Statistical tests, P values, confidence intervals, and power: a guide to misinterpretations, European Journal of Epidemiology 31, 2016
- John P. A. Ioannidis, Why Most Published Research Findings Are False, PLoS Medicine 2(8), 2005
- David Colquhoun, An investigation of the false discovery rate and the misinterpretation of P values, arXiv 1407.5296, 2014
- Valentin Amrhein, Sander Greenland, Blake McShane, Scientists rise up against statistical significance, Nature, March 2019
- Regina Nuzzo, Scientific method: statistical errors, Nature 506, 2014
- Joseph P. Simmons, Leif D. Nelson, Uri Simonsohn, False-positive psychology, Psychological Science 22(11), 2011
- Yoav Benjamini, Yosef Hochberg, Controlling the false discovery rate, Journal of the Royal Statistical Society B 57(1), 1995
- Andrew Gelman, Hal Stern, The difference between significant and not significant is not itself statistically significant, The American Statistician 60(4), 2006
- Ron Kohavi, Roger Longbotham, Dan Sommerfield, Randal M. Henne, Controlled experiments on the web: survey and practical guide, Data Mining and Knowledge Discovery 18, 2009
- Ron Kohavi, Stefan Thomke, The surprising power of online experiments, Harvard Business Review, September-October 2017
- Ron Kohavi, Diane Tang, Ya Xu, Trustworthy Online Controlled Experiments, Cambridge University Press, 2020
- Ramesh Johari, Leo Pekelis, David J. Walsh, Always valid inference: bringing sequential analysis to A/B testing, arXiv 1512.04922
- Statsig documentation, P-value
- GrowthBook documentation, Statistics overview
Обновлено 20 октября 2026

Маркетинговое агентство или система роста: что нужно на каждом этапе масштабирования
Агентство подходит, пока фаундер сам ведёт большую часть процессов. Когда бизнес начинает копировать себя в новые точки и регионы, нужна система, которая ставит цели, проверяет гипотезы и отвечает за результат.
Агентство медицинского маркетинга: почему работа с клиникой буксует и какую модель используем мы
Большинство агентств отвечают за клик, а за регистратуру не отвечает никто. Как мы строим маркетинг клиники в трёх горизонтах, на каких исследованиях это основано и что дал один год работы.
Тестирование рекламных каналов: почему тест затухает на третьем месяце
Большинство тестов нового рекламного канала заканчиваются не решением. Они заканчиваются, когда кончился бюджет, поменялась атрибуция или все тихо перестали открывать дашборд.