Размер выборки для A/B-теста: формула и MDE
Минимальный детектируемый эффект — наименьший прирост, который A/B-тест рассчитан заметить. Вместе с базовым значением метрики, уровнем значимости и мощностью он определяет, сколько пользователей нужно тесту и как долго ему идти.
Минимальный детектируемый эффект (MDE) — это наименьшая истинная разница между контролем и вариантом, которую A/B-тест рассчитан обнаружить, обычно при мощности 80% и уровне значимости 5%. Вместе с дисперсией метрики он задаёт размер выборки: примерно 16σ²/δ² пользователей на вариант. Поэтому если MDE уменьшить вдвое, тесту нужно вчетверо больше трафика.
- Автор
- Роберт Лер (формула 16σ²/δ²); Джеральд ван Белл (практическое правило); для веб-тестов её популяризировали Рон Кохави с коллегами и Эван Миллер, 1992; 2002; 2007–2010
- Уровень
- 301 · Продвинутый
- Подходит
- малый и средний бизнес, растущая компания
- Время на внедрение
- 30 минут на тест, если у вас есть четыре недели базовых данных
- Что понадобится
- история за четыре недели по метрике, которую вы будете тестировать: её среднее и, для небинарных метрик, стандартное отклонение · ежедневное или еженедельное число пользователей, которые действительно увидят изменение · бизнес-ответ на вопрос: какой наименьший прирост стоит выкатывать?
Минимальный детектируемый эффект (MDE) — это наименьшая истинная разница между контролем и вариантом, которую A/B-тест рассчитан надёжно обнаружить. Вы выбираете её до запуска, и она определяет, сколько пользователей нужно тесту. Выберете малый MDE — понадобится много трафика; выберете большой — тест дешёвый, но слепой к скромным победам.
Математика планирования пришла из клинической статистики. Роберт Лер опубликовал короткую формулу 16σ²/δ² в Statistics in Medicine в 1992 году, а Statistical Rules of Thumb Джеральда ван Белла превратила его в правило, которое стоит запомнить. Команда Рона Кохави в Microsoft принесла его в веб-эксперименты, а эссе Эвана Миллера 2010 года How Not To Run an A/B Test и его бесплатный калькулятор довели правило до большинства команд роста.
Четыре числа, которые задают размер выборки
Размер выборки следует из четырёх входных данных, и свободно выбирать можно только три. Справочник NIST по инженерной статистике даёт общую формулу: нужное n растёт вместе с дисперсией метрики и убывает обратно пропорционально квадрату эффекта, который вы хотите заметить.
| Входной параметр | Что он значит | Обычное значение |
|---|---|---|
| Уровень значимости (альфа) | Вероятность объявить победителя, когда реальной разницы нет | 5%, двусторонний |
| Мощность (1 - бета) | Вероятность значимого результата, когда истинный эффект равен MDE | 80% |
| Дисперсия (σ²) | Насколько шумна метрика; для конверсии p это p(1 - p) | По данным за последние четыре недели |
| MDE (δ) | Наименьшая абсолютная разница, которую вы хотите поймать | Задают бизнес и прошлые тесты |
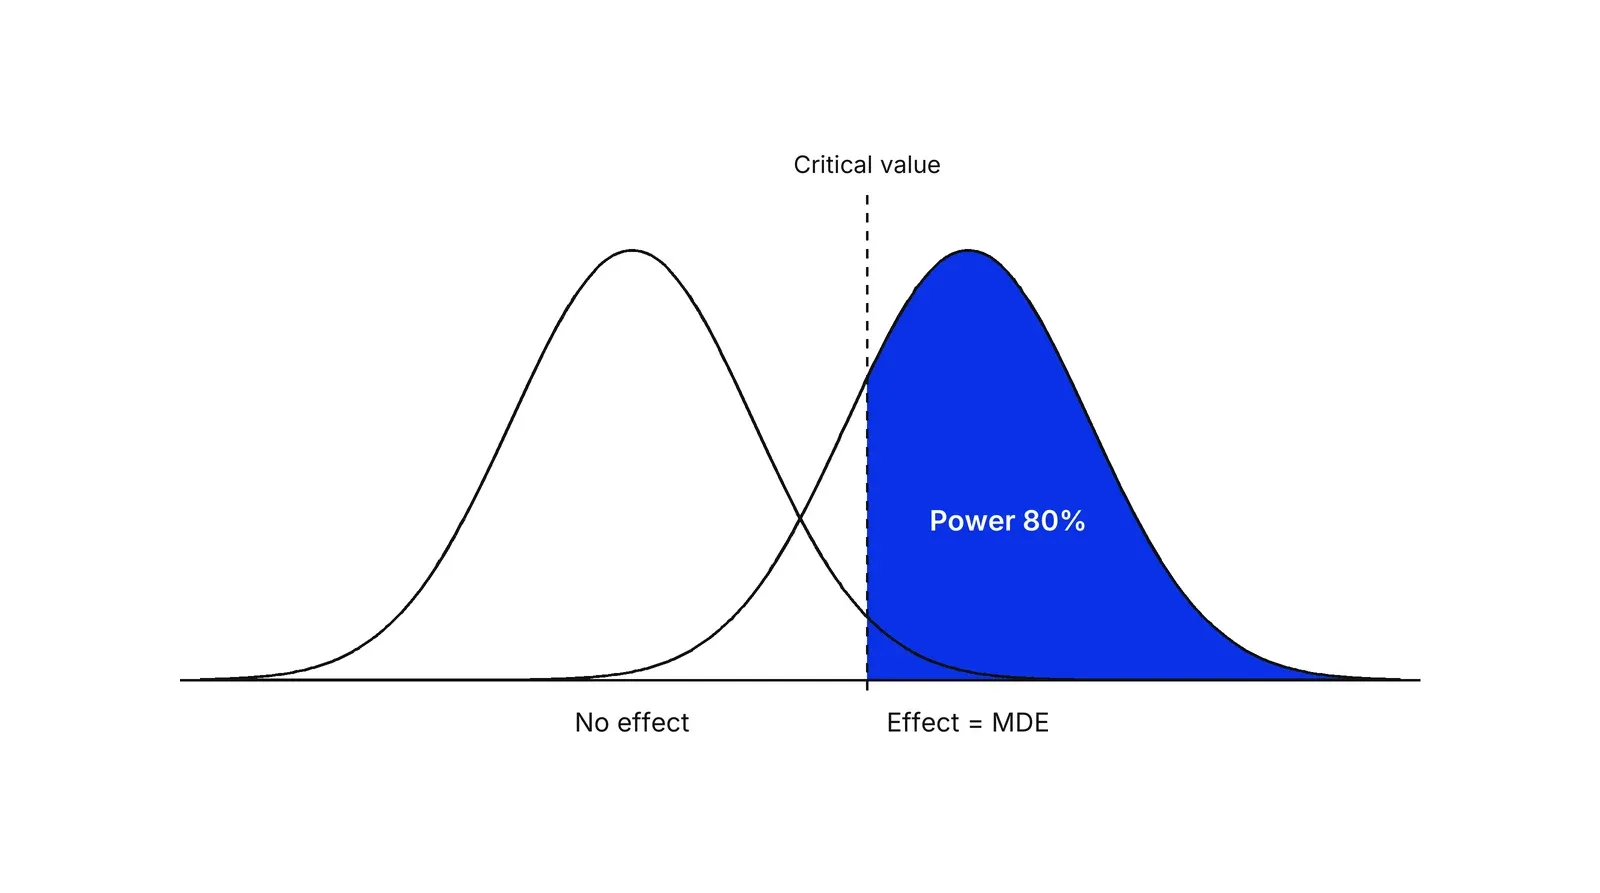
Мощность — тот параметр, который люди пропускают. Тест с мощностью 50% — это подбрасывание монетки: найдёт он реальный эффект запланированного размера или нет. Платформы вроде GrowthBook и Statsig по умолчанию берут мощность 80% и альфу 5%, а GrowthBook отмечает, что соглашение о 80% заимствовано из клинических испытаний.
Откуда берётся 16σ²/δ²
Правило гласит: каждому варианту нужно около 16σ²/δ² пользователей при двусторонней значимости 5% и мощности 80%. Число 16 — округлённая константа: z-значение для двусторонней значимости 5% равно 1,96, z-значение для мощности 80% равно 0,84, а 2 × (1,96 + 0,84)² = 15,7. Ван Белл округляет вверх до 16. Для мощности 90% константа становится равной 21, что прямо указано в обзоре Кохави с коллегами 2009 года.
Не во всех работах Кохави напечатана одна и та же формула. В руководстве KDD 2007 года использована версия Роберта Уилера 1974 года, n = (4rσ/Δ)² при мощности 90%, с предупреждением, что она может завышать оценку. Обзор 2009 года и статья 2026 года в Econ Journal Watch берут 16σ²/δ² на вариант и называют форму Уилера более консервативной. На этой странице используется версия с 16.
Расчёт на примере: конверсия 5%, прирост 10%
Возьмём страницу оформления заказа, которая конвертирует 5% посетителей. Вы хотите заметить относительный прирост 10%, с 5,0% до 5,5%, то есть δ = 0,005, а σ² = 0,05 × 0,95 = 0,0475. По правилу получается 16 × 0,0475 / 0,005² = 30 400 пользователей на вариант, или 60 800 всего.
Точные методы дают близкий результат (все три посчитаны в Python):
| Метод | Пользователей на вариант |
|---|---|
| Правило 16σ²/δ² | 30 400 |
| Формула из калькулятора Эвана Миллера | 30 244 |
| statsmodels, арксинусный размер эффекта и NormalIndPower | 31 217 |
При 4 000 подходящих посетителей в день 60 800 пользователей набираются за 15,2 дня. Округлите вверх до трёх полных недель: обзор 2009 года советует вести тест минимум неделю-две и затем целыми неделями, потому что посетители выходных часто ведут себя иначе.
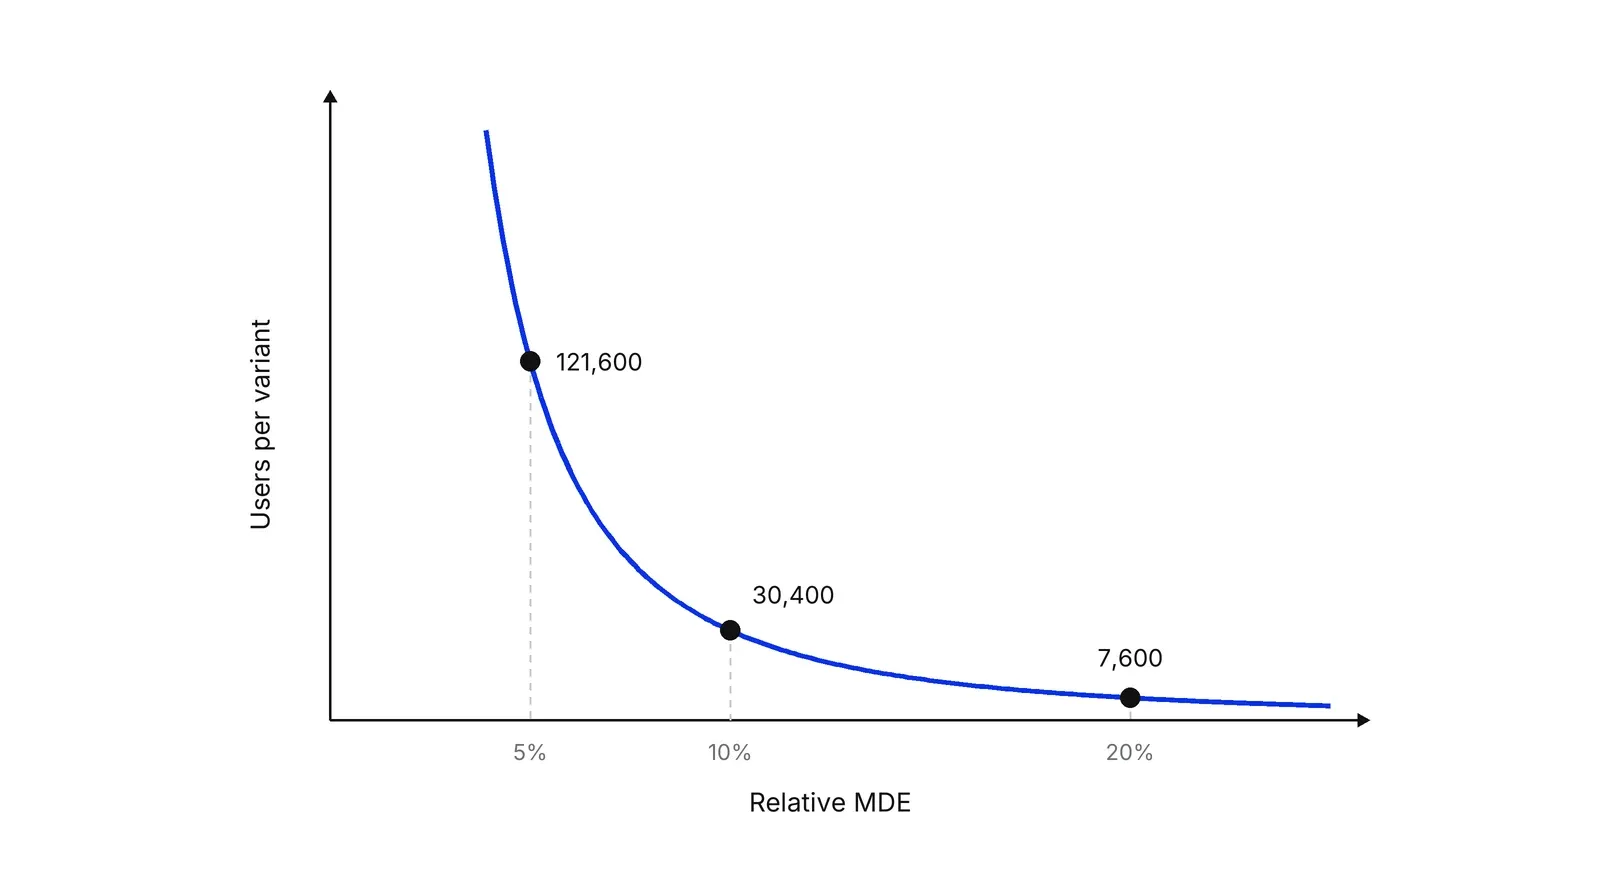
Именно δ² в знаменателе делает MDE дорогим. Чтобы заметить прирост 5% вместо 10%, нужно 121 600 пользователей на вариант, в четыре раза больше. Чтобы заметить 20%, достаточно 7 600.
Какой MDE способен поймать ваш трафик
У большинства команд трафик фиксирован, поэтому полезный вопрос идёт в обратную сторону: если на вариант приходится n пользователей, какой наименьший эффект тест способен поймать? Преобразованное правило даёт MDE ≈ 4σ/√n.
| Пользователей на вариант | MDE при базовой конверсии 5% (пункты) | Относительный MDE |
|---|---|---|
| 10 000 | 0,87 | 17,4% |
| 20 000 | 0,62 | 12,3% |
| 40 000 | 0,44 | 8,7% |
| 100 000 | 0,28 | 5,5% |
Если ваше изменение может сдвинуть конверсию на 3%, а трафик различает только 12%, тест почти наверняка покажет «ничего», а «ничего» вам ничего не скажет. Ту же связь между MDE, трафиком и длительностью теста проводит и руководство Optimizely.
Как выбрать MDE
Начните с денег: какой наименьший прирост окупит разработку и поддержку изменения. Затем сверьте его с историей. В статье 2026 года Кохави и семеро соавторов пишут, что приросты в просмотренных ими экспериментах «обычно меньше одного процента и редко больше двух-трёх процентов». Небольшие приросты всё равно могут быть большими в деньгах. Тест заголовков в Bing, который описывают Кохави и Стефан Томке, поднял выручку на 12%, а это больше $100 миллионов в год в США, и такие победы редки.
Почему тесты с низкой мощностью вводят в заблуждение
Значимый результат маленького теста, скорее всего, преувеличивает эффект. Эндрю Гельман и Джон Карлин называют это коэффициентом преувеличения. Статья 2026 года показывает это на практике: опубликованное исследование на 919 визитах сообщило о приросте кликов на 55% от кнопок со скруглёнными углами. Три повторения на 2,8, 2,2 и 1,9 миллиона пользователей нашли приросты 0,16%, 0,29% и 0,73%, и ни один не был значим на уровне 5%. При MDE 2% авторы оценивают, что у исходного теста была мощность около 3% и ожидаемое преувеличение примерно в 28 раз.
Как обойтись меньшим числом пользователей
- Снижайте дисперсию. Метод CUPED от Microsoft использует данные до эксперимента и снизил дисперсию в Bing примерно на 50%: та же мощность при вдвое меньшем числе пользователей.
- Анализируйте только тех, кто дошёл до изменённой страницы, как советует руководство 2007 года.
- Делите трафик 50/50. Обзор 2009 года даёт замедление при неравном делении как 1/(4p(1-p)): разделение 90/10 идёт в 2,8 раза дольше.
- Берите меньше вариантов, потому что каждому нужно своё n.
- Если без раннего просмотра не обойтись, планируйте последовательный тест, например простую версию Эвана Миллера или p-значения, верные при любом числе проверок, Джохари, Пекелис и Уолша.
В работе Pushers по Growth Lab этот расчёт входит в каждый HADI-цикл: ни одна гипотеза не запускается без записанных MDE и даты окончания.
Как применять: Размер выборки для A/B-теста: формула и MDE по шагам
- Выберите одну основную метрику и возьмите её базовое значение. Выберите метрику, от которой зависит решение, например конверсию в оформление заказа, и возьмите её значение и дисперсию за последние четыре недели по тем пользователям, которые увидят изменение. Для конверсии p дисперсия равна p(1 - p). Результат: записанные базовое значение и дисперсия.
- Задайте MDE из бизнес-кейса. Спросите себя, какой прирост окупит разработку и поддержку изменения, и сравните его с приростами, которые давали прошлые тесты. Если прошлые победители двигали метрику на 2%, а вы планируете 20%, план оторван от реальности. Результат: абсолютный и относительный MDE, например 0,5 пункта и 10%.
- Зафиксируйте альфу и мощность до всего остального. Берите двусторонний уровень значимости 5% и мощность 80%, если только регулятор, дорогой откат или вопрос безопасности не требуют более жёстких значений. Переход на мощность 90% увеличивает выборку примерно в 1,34 раза. Результат: два числа, которые никто не меняет после запуска.
- Дважды посчитайте число пользователей на вариант. Сначала прикиньте по правилу n = 16σ²/δ² в уме или в таблице. Затем проверьте в калькуляторе или в коде (statsmodels в Python, pwr в R). Результаты должны сойтись с точностью до нескольких процентов. Результат: размер выборки на вариант, которому вы доверяете.
- Переведите пользователей в календарное время. Разделите общую выборку на дневной трафик подходящих пользователей и округлите вверх до целых недель, чтобы в тест попали и будни, и выходные. Если получилось дольше шести недель, меняйте план: тестируйте более смелое изменение, перейдите на метрику с большим трафиком, уберите варианты или снизьте дисперсию. Результат: фиксированная дата окончания.
- Запишите план и не останавливайте тест раньше срока. До запуска внесите в бриф теста метрику, MDE, альфу, мощность, размер выборки и дату окончания. Смотрите на результат один раз, в конце, если только вы не планировали последовательный тест. Результат: решение, которое можно защитить, даже если цифра разочарует.
Примеры
Онбординг в финтехе
Иллюстративный пример. Платёжное приложение получает 3 000 новых регистраций в неделю, и 40% из них проходят верификацию личности. Команда хочет заметить относительный прирост 5%, с 40% до 42%. По правилу выходит 16 × 0,4 × 0,6 / 0,02² = 9 600 пользователей на вариант; по формуле из калькулятора Эвана Миллера — 9 440. Тесту нужно около 19 200 регистраций, или 6,4 недели трафика, поэтому его планируют на семь полных недель.
Страница записи в клинику при малом трафике
Иллюстративный пример. На страницу записи частной клиники заходят 3 000 посетителей в месяц, и конвертируются 3% из них. Если разделить трафик 50/50 на один месяц, каждая версия получит по 1 500 посетителей, и наименьший прирост, который тест надёжно поймает, составит около 1,8 процентного пункта, то есть относительный скачок на 60%, с 3% до 4,8%. За четыре месяца порог снижается примерно до 0,9 пункта, или 30%. Мелкие правки кнопки такую планку не возьмут; клинике нужно тестировать смелые изменения или измерять более ранний шаг с большим трафиком, например клики по кнопке записи.
Выручка на пользователя против конверсии
В руководстве Кохави с коллегами 2007 года описан магазин, где покупают 5% посетителей, средняя трата на посетителя равна $3,75, а стандартное отклонение — $30. Если подставить эти данные в правило 16σ²/δ² для изменения на 5%, получится 409 600 пользователей на вариант для выручки на посетителя против 121 600 для конверсии. Тот же тест, тот же трафик, а выборка больше чем втрое, только потому что выручка — более шумная метрика.
Когда применять
Применяйте перед каждым A/B-тестом, на этапе планирования: чтобы понять, ответит ли тест на свой вопрос при вашем трафике, и назначить фиксированную дату окончания. Пригодится и тогда, когда заинтересованные стороны спрашивают, почему тест идёт четыре недели, или когда очередь идей для тестов надо отсортировать по тому, на какие из них ваш трафик способен дать ответ.
Когда не применять
Не используйте расчёт с фиксированным горизонтом, если вы сознательно запускаете последовательный или байесовский тест: у них свои правила планирования. Не нужен он и тогда, когда трафика так мало, что даже прирост 50% потребует месяцев: там честнее качественное исследование, сравнение «до и после» с чёткими оговорками или решение на основе суждения, чем тест, который ничего не способен обнаружить.
Частые ошибки
- Путать абсолютный и относительный MDE. Прирост 10% при конверсии 5% — это 0,5 процентного пункта; если ввести в калькулятор 10 пунктов, выборка окажется заниженной в 400 раз.
- Выбирать MDE так, чтобы выборка вписалась в трафик, и считать, что мощности теста хватает. Какой эффект реалистичен, подскажут прошлые эксперименты, а не бюджет трафика.
- Останавливать тест в первый день, когда он показал значимость. Эван Миллер показал, что проверка после каждого посетителя может поднять номинальные 5% ложных срабатываний до 26%.
- Считать всех посетителей сайта, когда до изменённой страницы доходит лишь часть. Пользователи, не видевшие изменения, добавляют шум и раздувают нужную выборку.
- Верить большому значимому приросту из маленького теста. Низкая мощность вместе со значимостью обычно означает, что эффект преувеличен.
Вопросы и ответы
Какой минимальный детектируемый эффект выбрать для A/B-теста?
Такой, который вы можете обосновать дважды: бизнес готов действовать при таком приросте, а похожие прошлые тесты давали приросты такого размера. Кохави и семеро соавторов написали в 2026 году, что приросты в просмотренных ими экспериментах обычно меньше 1% и редко превышают 2–3%, так что MDE в 20% на зрелом продукте чаще всего выдача желаемого за действительное.
Как рассчитать размер выборки для A/B-теста?
На один вариант n ≈ 16σ²/δ², где σ² — дисперсия метрики, а δ — абсолютный MDE, для значимости 5% и мощности 80%. Для конверсии p дисперсия σ² = p(1 - p). Базовая конверсия 5% и MDE 0,5 пункта дают 30 400 пользователей на вариант. Проверьте результат в калькуляторе.
Что означает мощность 80% в A/B-тесте?
Если вариант улучшает метрику ровно на MDE, тест с мощностью 80% покажет значимый результат в четырёх случаях из пяти и пропустит эффект в одном. Эффекты крупнее ловятся чаще, мельче — реже. Соглашение о 80% пришло из клинических и поведенческих исследований.
Чем абсолютный MDE отличается от относительного?
Абсолютный MDE измеряется в единицах самой метрики, например в процентных пунктах конверсии. Относительный — это доля от базового значения. При конверсии 5% относительный MDE 10% равен 0,5 пункта в абсолютном выражении. В формулу размера выборки всегда подставляют абсолютное значение.
Можно ли остановить A/B-тест, как только он стал значимым?
В стандартном тесте с фиксированной выборкой нельзя. Каждый дополнительный просмотр даёт случайному шуму ещё один шанс пересечь порог, и доля ложных срабатываний растёт заметно выше 5%. Либо доведите тест до запланированной выборки, либо используйте последовательный метод, рассчитанный на повторные просмотры, например p-значения, которые остаются верными при любом числе проверок.
Источники
- Evan Miller, Sample Size Calculator (Evan's Awesome A/B Tools)
- Evan Miller, How Not To Run an A/B Test, 2010
- Evan Miller, Simple Sequential A/B Testing, 2015
- Ron Kohavi, Randal M. Henne, Dan Sommerfield, Practical Guide to Controlled Experiments on the Web, KDD 2007
- Ron Kohavi, Roger Longbotham, Dan Sommerfield, Randal M. Henne, Controlled Experiments on the Web: Survey and Practical Guide, Data Mining and Knowledge Discovery 18, 2009
- Ron Kohavi, Diane Tang, Ya Xu, Trustworthy Online Controlled Experiments, Cambridge University Press, 2020
- Robert Lehr, Sixteen S-squared over D-squared: A Relation for Crude Sample Size Estimates, Statistics in Medicine 11(8), 1992
- Gerald van Belle, Statistical Rules of Thumb, chapter 2: Sample size
- Robert E. Wheeler, Portable Power, Technometrics 16(2), 1974
- Jacob Cohen, A Power Primer, Psychological Bulletin 112(1), 1992
- NIST/SEMATECH e-Handbook of Statistical Methods, Sample sizes required
- statsmodels documentation, NormalIndPower.solve_power
- statsmodels documentation, proportion_effectsize
- GrowthBook documentation, Power analysis
- Statsig documentation, Power analysis
- Optimizely documentation, Use minimum detectable effect when you design an experiment
- Alex Deng, Ya Xu, Ron Kohavi, Toby Walker, Improving the Sensitivity of Online Controlled Experiments by Utilizing Pre-Experiment Data (CUPED), WSDM 2013
- Andrew Gelman, John Carlin, Beyond Power Calculations: Assessing Type S and Type M Errors, Perspectives on Psychological Science 9(6), 2014
- Ron Kohavi, Alex Deng, Lukas Vermeer, A/B Testing Intuition Busters, KDD 2022 (author's version)
- Ramesh Johari, Leo Pekelis, David J. Walsh, Always Valid Inference: Bringing Sequential Analysis to A/B Testing, arXiv 1512.04922
- Ron Kohavi et al., Power Analysis is Essential, Econ Journal Watch 23(1), March 2026
- Ron Kohavi, Stefan Thomke, The Surprising Power of Online Experiments, Harvard Business Review, September-October 2017
- Microsoft Experimentation Platform, Patterns of Trustworthy Experimentation: Pre-Experiment Stage, 2020
- Katherine S. Button et al., Power Failure: Why Small Sample Size Undermines the Reliability of Neuroscience, Nature Reviews Neuroscience 14, 2013
Обновлено 15 октября 2026

Маркетинговое агентство или система роста: что нужно на каждом этапе масштабирования
Агентство подходит, пока фаундер сам ведёт большую часть процессов. Когда бизнес начинает копировать себя в новые точки и регионы, нужна система, которая ставит цели, проверяет гипотезы и отвечает за результат.
Агентство медицинского маркетинга: почему работа с клиникой буксует и какую модель используем мы
Большинство агентств отвечают за клик, а за регистратуру не отвечает никто. Как мы строим маркетинг клиники в трёх горизонтах, на каких исследованиях это основано и что дал один год работы.
Тестирование рекламных каналов: почему тест затухает на третьем месяце
Большинство тестов нового рекламного канала заканчиваются не решением. Они заканчиваются, когда кончился бюджет, поменялась атрибуция или все тихо перестали открывать дашборд.