Причинно-следственный анализ: методы и примеры
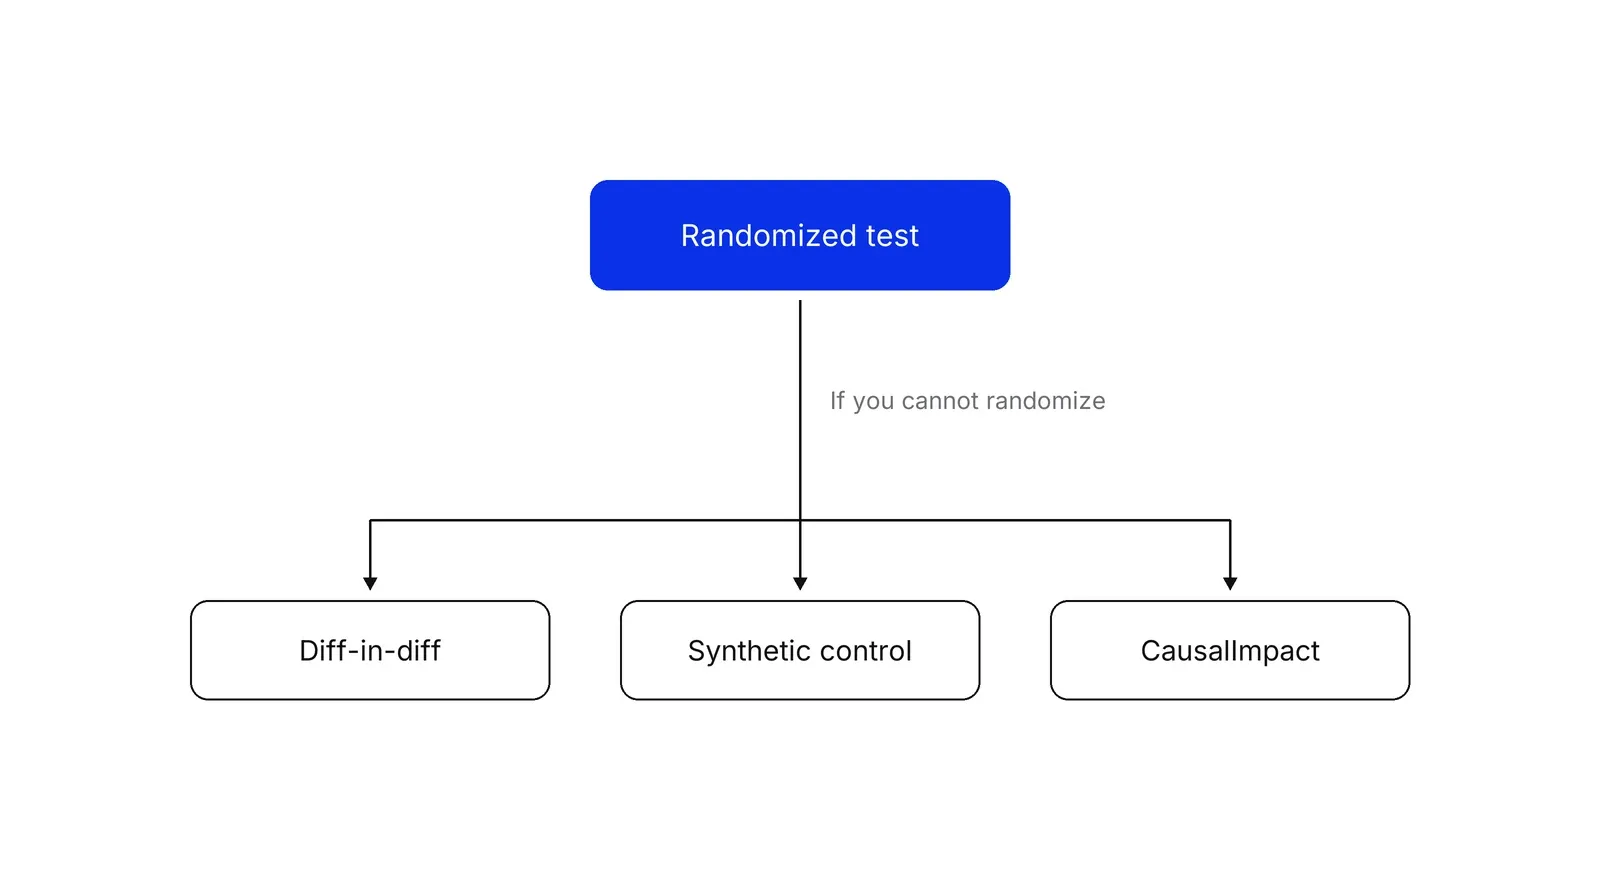
Причинно-следственный анализ — набор методов, которые оценивают, что именно вызвало изменение, когда рандомизированный тест невозможен: для этого берут контрольную группу или модель того, что случилось бы без изменения.
Причинно-следственный анализ — это методы, которые оценивают, что изменение действительно вызвало, а не что просто двигалось вместе с ним. Когда A/B-тест провести нельзя, аналитик строит контрфактуал — оценку того, что было бы без изменения: через разность разностей, синтетический контроль или байесовскую модель временных рядов вроде CausalImpact от Google.
- Автор
- Дональд Рубин (потенциальные исходы); Кард и Крюгер (разность разностей в экономике); Абади с соавторами (синтетический контроль); Бродерсен с соавторами из Google (CausalImpact), 1974; 1994; 2003 и 2010; 2015
- Уровень
- 301 · Продвинутый
- Подходит
- растущая компания, корпорация
- Время на внедрение
- одна-две недели на первую оценку разностью разностей или CausalImpact по данным, которые у вас уже есть
- Что понадобится
- дата, когда что-то изменилось (запуск, смена цены, новое правило), и данные задолго до неё · показатель, который измеряют одинаково во времени: недельные регистрации, заказы или записи · один или несколько рядов для сравнения, которых изменение не коснулось, например другой регион или канал · аналитик, который умеет запускать регрессию или пакет CausalImpact
Причинно-следственный анализ (анализ причинно-следственных связей) оценивает, что вызвало изменение, а не что просто двигалось рядом с ним. Продажи выросли после кампании, но они растут и с сезоном, и когда у конкурента кончается товар, и после снижения цены. Чтобы отделить кампанию от остального, каждый метод строит контрфактуал: результат, который вы увидели бы, если бы изменения не было. Этот язык дала области статья Дональда Рубина 1974 года о потенциальных исходах, а структурные причинные модели Джуды Перла добавили второй, графовый.
Вес этой работе придал и Нобелевский комитет. Нобелевскую премию по экономике 2021 года разделили так: половину получил Дэвид Кард, вторую разделили Джошуа Ангрист и Гвидо Имбенс — за методологический вклад в анализ причинных связей. Маркетологи встречают ту же задачу всякий раз, когда владелец бюджета спрашивает, сработал ли запуск, а A/B-теста никто не ставил.
Почему нельзя просто сравнить «до» и «после»?
Сравнение «до и после» не работает, потому что изменилось и всё остальное. Рандомизация решает проблему так: кто получит воздействие, решает случай, и группы различаются только воздействием. Когда рандомизировать нельзя, нужен заменитель. Бретт Гордон с коллегами сравнили такие методы с рандомизированными рекламными экспериментами в Facebook (принадлежит компании Meta, признанной экстремистской организацией и запрещённой в России) и обнаружили, что наблюдательные методы часто не воспроизводят эффекты, которые измерили рандомизированные эксперименты. Поэтому всё дальнейшее — запасной вариант с допущениями, которые нужно проверять, а не бесплатная замена. Если рандомизировать ещё можно, сначала прочитайте про тесты инкрементальности.
Разность разностей: четыре средних и три вычитания
Разность разностей (diff-in-diff, DiD) — метод, который сравнивает изменение во времени в группе воздействия с изменением за тот же период в группе без воздействия. Скотт Каннингем в Mixtape описывает её как четыре средних и три вычитания: группа воздействия после минус она же до, группа сравнения после минус она же до, затем первая разность минус вторая.
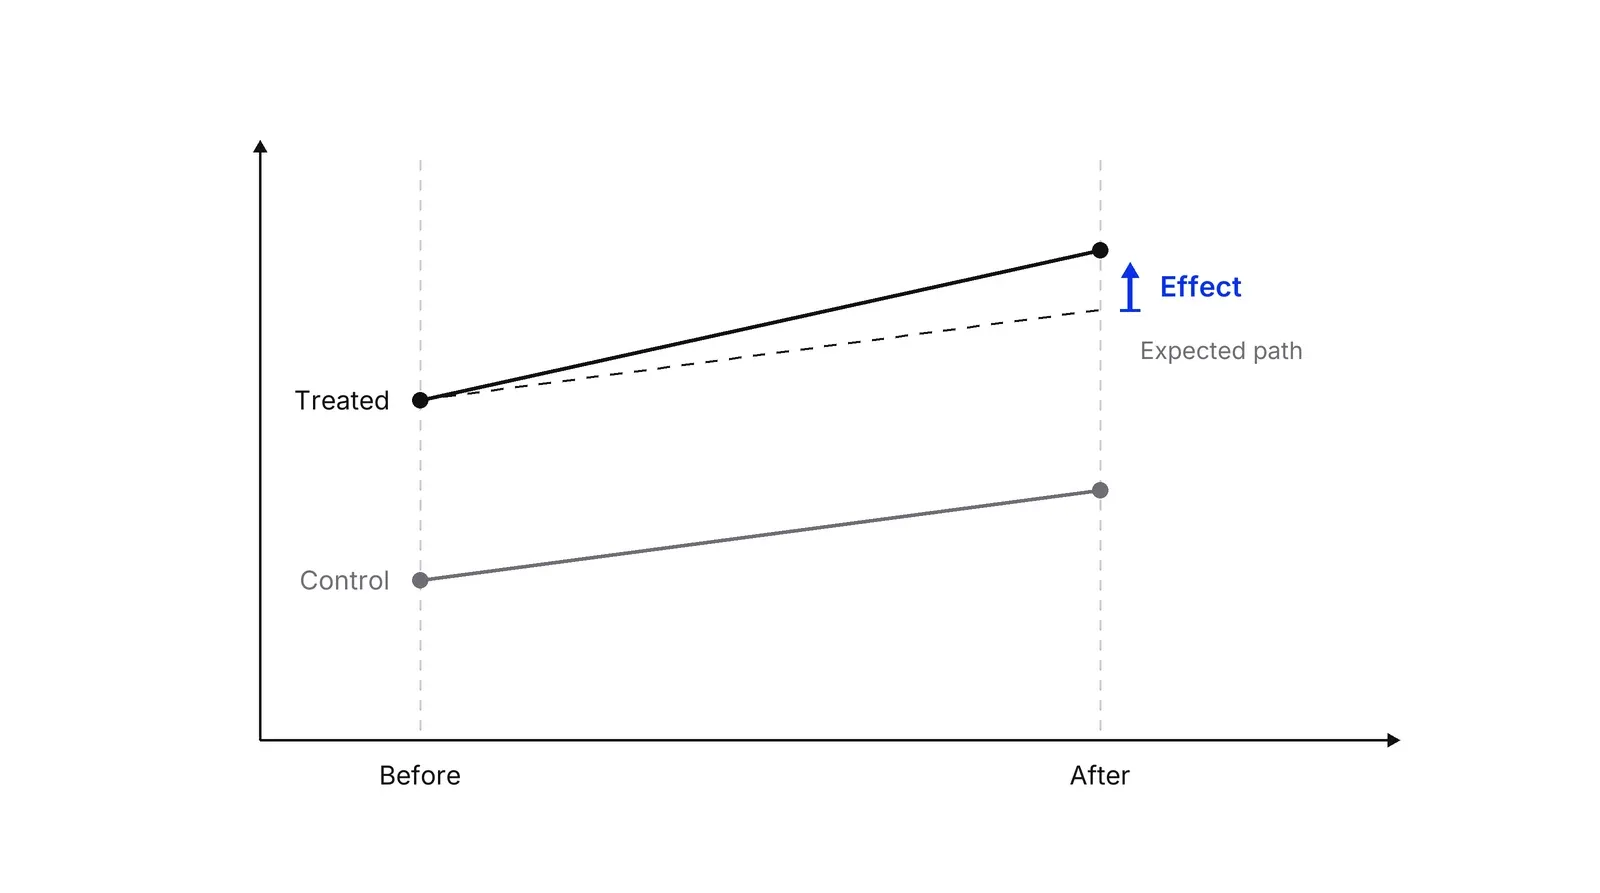
Идея старая. Каннингем возводит её к работе Джона Сноу о холере в Лондоне: с 1849 по 1854 год одна водопроводная компания перенесла водозабор выше по течению, а вторая — нет, и разница двух изменений составила на 97 смертей меньше на каждые 10 000 домохозяйств. Современный пример из экономики — исследование Карда и Крюгера о ресторанах быстрого питания в Нью-Джерси, оно разобрано в примерах ниже. В Mostly Harmless Econometrics Ангрист и Пишке относят разность разностей к трём основным инструментам оценки изменений политики.
Допущение, на котором всё держится
Разность разностей работает только при параллельных трендах: без изменения группа воздействия и контрольная группа двигались бы на одну и ту же величину. Контрфактуал никогда не наблюдается, поэтому допущение нельзя проверить напрямую. По Mixtape, исследователи ищут косвенные свидетельства, например в event study (анализе событий) проверяют, похожи ли тренды до запуска. Рамбачан и Рот идут дальше и оценивают, насколько сильным может быть нарушение с учётом различий до запуска.
Вторая ловушка — стандартные ошибки. Бертран, Дюфло и Муллайнатан прогнали выдуманные законы через реальные данные о зарплатах по штатам и увидели плацебо-эффекты, значимые на уровне 5%, вплоть до 45% случаев. Среди их средств — кластеризация стандартных ошибок и рандомизационный вывод.
Третья — время. Если единицы получают воздействие в разные даты, обычная регрессия с двусторонними фиксированными эффектами превращается во взвешенное среднее всех возможных сравнений двух групп за два периода и может быть смещённой, когда эффекты меняются со временем. Для поэтапных запусков построены новые оценки, например Каллауэя и Сант-Анны. Недавнюю литературу обобщают Рот с коллегами.
Синтетический контроль: взвешенная смесь в роли группы сравнения
Синтетический контроль — метод, который строит сравнение из взвешенной смеси единиц без воздействия, подобранной так, чтобы повторять единицу воздействия до изменения. Абади и Гардеазабаль предложили его в исследовании 2003 года, где после начала террора в конце 1960-х ВВП на душу населения в Стране Басков упал примерно на 10 процентных пунктов относительно синтетического контрольного региона. Абади, Даймонд и Хайнмюллер применили метод к калифорнийской программе против курения и получили, что к 2000 году годовые продажи сигарет на душу населения оказались примерно на 26 пачек ниже, чем были бы без неё.
В маркетинге синтетический контроль — двигатель многих гео-экспериментов, о них рассказывает страница гео-эксперимента. Обзор Абади 2021 года перечисляет условия: эффект должен быть большим относительно обычной волатильности, в пул доноров не входят единицы, затронутые похожими изменениями или шоками, а единица воздействия не должна быть настолько нетипичной, что ни одна смесь других её не повторит. Синтетическая разность разностей объединяет обе идеи.
CausalImpact: когда есть только временной ряд
CausalImpact — открытый метод от Google, который предсказывает контрфактуал байесовской структурной моделью временных рядов. Бродерсен с коллегами создали его для маркетинговых вопросов: модель по периоду до запуска учится, как показатель связан с контрольными рядами, и затем прогнозирует период после запуска так, будто ничего не произошло. Авторы пишут, что он показывает, как эффект развивается во времени, и учитывает сезонность и тренды, чего классическая разность разностей не умеет.
В документации пакета условия названы прямо: контрольные ряды не должны попадать под воздействие, а связь контролей с показателем должна оставаться стабильной после запуска. Плохой контрольный ряд даёт уверенный и неверный ответ.
Какой метод подходит
| Ситуация | Метод | Главный риск |
|---|---|---|
| Одна группа воздействия, одна естественная группа сравнения, данные до и после | Разность разностей | Параллельные тренды не выполняются |
| Одна или несколько единиц воздействия, много кандидатов в контроль | Синтетический контроль | Плохое совпадение до запуска, перетекание эффекта |
| Один ряд воздействия, длинная история, посторонние контрольные ряды | CausalImpact | Контроли затронуты изменением |
| Можно назначать, кто получит изменение | Рандомизированный тест | Стоимость, размер выборки |
Каким бы ни был метод, сообщайте интервал, а не точку. Здесь действует та же логика, что и в статистической значимости. Используйте такие оценки, чтобы откалибровать модель маркетингового микса, а не чтобы её заменить. План Growth Lab начинается с решения, какие из этих вопросов заслуживают настоящего эксперимента, а какие можно оставить с оценкой.
Как применять: Причинно-следственный анализ: методы и примеры по шагам
- Сформулируйте причинный вопрос и решение. Назовите одно изменение, один показатель и решение, которое зависит от ответа: если новая реферальная программа приносит меньше 150 регистраций в неделю, закрыть её. Результат: вопрос в одну строку с порогом.
- Зафиксируйте дату и тех, кто получил воздействие. Запишите, когда именно началось изменение, какие регионы, клиенты или каналы его получили и успел ли кто-нибудь отреагировать до запуска. Результат: группа воздействия, дата старта и список других изменений за то же окно.
- Выберите сравнение, которого изменение не коснулось. Возьмите контрольную группу, которая не получила воздействия и не зависит от группы воздействия. Если есть одна очевидная группа сравнения, берите разность разностей; если кандидатов много — синтетический контроль; если есть только длинная история и несколько посторонних рядов — CausalImpact. Результат: название метода и список контролей.
- Проверьте допущение до того, как смотреть на эффект. Нарисуйте группу воздействия и контроль за период до запуска и убедитесь, что они двигаются вместе. Запустите тот же метод на фальшивой дате запуска в прошлом, где настоящий эффект равен нулю. Результат: график до запуска и плацебо-оценка, близкая к нулю.
- Оцените эффект вместе с неопределённостью. Посчитайте разрыв между фактическим показателем и контрфактуалом после запуска, с интервалом: кластеризованные стандартные ошибки или апостериорный интервал, как требует метод. Результат: размер эффекта с диапазоном в единицах, в которых принимается решение.
- Проверьте устойчивость и решайте. Уберите по одному контролю за раз, сдвиньте дату старта на неделю и попробуйте другой набор контролей. Если ответ держится, действуйте. Если переворачивается, честно скажите, что данные не решают вопрос. Результат: решение или предложение поставить настоящий эксперимент.
Примеры
Кард и Крюгер о минимальной зарплате в Нью-Джерси
Нью-Джерси поднял минимальную зарплату с 4,25 до 5,05 доллара 1 апреля 1992 года, а соседняя Пенсильвания — нет. Дэвид Кард и Алан Крюгер опросили 410 ресторанов быстрого питания в обоих штатах и сравнили изменение занятости. Их оценка разностью разностей, как её приводит Скотт Каннингем в «Mixtape», составила +2,76 эквивалента полной занятости на ресторан, хотя учебник предсказывал падение. Повторный анализ Дэвида Ноймарка и Уильяма Вашера по платёжным ведомостям показал, наоборот, снижение занятости в Нью-Джерси на 4,6%. Метод тот же, данные другие, знак противоположный — поэтому данные и проверки значат не меньше, чем сам метод.
Реферальная программа финтех-приложения, запущенная в одной стране
Иллюстративный расчёт, реальная компания не подразумевается. Платёжное приложение запускает реферальную программу в Испании, но не в Португалии. После запуска Испания получает по 300 новых аккаунтов в неделю, Португалия за те же недели — 60. Оценка разностью разностей: 300 минус 60, то есть 240 аккаунтов в неделю. Рост Португалии — то, что Испания, вероятно, получила бы и так из-за сезона и общей маркетинговой активности. Если бы Португалия росла быстрее Испании несколько месяцев до запуска, оценка в 240 завысила бы эффект.
Сеть клиник меняет скрипт колл-центра
Иллюстративный пример. Группа клиник меняет телефонный скрипт в одну дату сразу во всех девяти городах, так что города без воздействия нет. Аналитик использует CausalImpact и прогнозирует недельные первичные записи по истории до запуска и двум рядам, на которые скрипт повлиять не может: поисковые запросы по услуге клиники и записи в партнёрской аптечной сети. Разрыв между прогнозом и фактом после запуска, вместе с интервалом, и есть оценка эффекта.
Когда применять
Применяйте, когда рандомизированный тест был невозможен или его уже пропустили: смена цены, запуск продукта, новое регулирование, поэтапный запуск, который сначала дошёл до части регионов, или кампания, которая шла сразу везде. Метод подходит и как перекрёстная проверка модели маркетингового микса, и когда оценка эффекта нужна в этом квартале по данным, которые у вас уже есть.
Когда не применять
Откажитесь, если рандомизировать ещё можно: холдаут или A/B-тест требуют меньше допущений. Откажитесь, если нет убедительной группы сравнения, если группу воздействия выбрали потому, что она и так росла, или если истории всего несколько недель. Аккуратный график не спасёт группу сравнения, которая никогда не была сопоставимой.
Частые ошибки
- Выбирают группу сравнения потому, что она в среднем похожа, и не рисуют тренды до запуска. Совпадение по уровням не показывает, что группы двигаются вместе.
- Прогоняют поэтапный запуск через обычную регрессию с двусторонними фиксированными эффектами. Эндрю Гудман-Бэкон показал, что оценка смешивает множество сравнений двух групп, включая уже получивших воздействие в роли контроля, и может быть смещённой, если эффект меняется со временем.
- Игнорируют последовательную корреляцию. Бертран, Дюфло и Муллайнатан обнаружили, что обычные стандартные ошибки объявляли значимыми плацебо-законы гораздо чаще, чем положенные 5% случаев.
- Берут контроль, которого изменение тоже коснулось, например соседний город, увидевший ту же рекламу. Эффект утекает в контроль и уменьшается.
- Сообщают одно число. Перезапустите расчёт с другими контролями и датами старта и сообщите диапазон.
Вопросы и ответы
Что такое причинно-следственный анализ простыми словами?
Это способ выяснить, вызвало ли изменение результат или просто совпало с ним по времени. Любой метод оценивает контрфактуал — результат, который был бы без изменения, — и сравнивает его с тем, что произошло. Рандомизированный тест строит контрфактуал с помощью контрольной группы, выбранной случайно. Остальные методы строят его из данных.
Как оценить эффект без A/B-теста?
Нужно сравнение, которое заменяет недостающий контроль. Разность разностей использует похожую группу без воздействия, синтетический контроль смешивает несколько таких групп, а CausalImpact предсказывает результат по посторонним временным рядам. Все три опираются на допущения, которые удаётся проверить лишь отчасти, поэтому они подходят как запасной вариант после рандомизации.
Что такое допущение параллельных трендов?
Оно говорит, что без изменения группа воздействия и группа сравнения изменились бы на одну и ту же величину. Допущение касается ненаблюдаемого сценария без изменения, поэтому прямо его не проверить. Аналитики смотрят, двигались ли группы вместе до запуска, и проверяют, насколько сильным должно быть нарушение, чтобы опрокинуть результат.
Разность разностей или синтетический контроль: что выбрать?
Разность разностей подходит, когда есть одна естественная группа сравнения. Синтетический контроль нужен, когда у вас одна или несколько единиц с воздействием и много кандидатов в контроль, ни один из которых не подходит сам по себе. Синтетический контроль подбирает веса, чтобы контроль повторял единицу воздействия до запуска, и смягчает требование параллельных трендов.
Чем CausalImpact отличается от разности разностей?
CausalImpact подгоняет байесовскую структурную модель временных рядов к периоду до запуска и прогнозирует контрфактуал после него. По словам авторов, так можно показать, как эффект развивается во времени, и учесть тренды и сезонность, чего классическая разность разностей не умеет. Но и ему нужны контрольные ряды, на которые изменение не повлияло.
Источники
- David Card, Alan B. Krueger, Minimum Wages and Employment: A Case Study of the Fast Food Industry in New Jersey and Pennsylvania, NBER Working Paper 4509 (AER 84(4), 1994)
- David Neumark, William Wascher, The Effect of New Jersey's Minimum Wage Increase on Fast-Food Employment: A Re-Evaluation Using Payroll Records, NBER Working Paper 5224
- Alberto Abadie, Javier Gardeazabal, The Economic Costs of Conflict: A Case Study of the Basque Country, American Economic Review 93(1), 2003
- Alberto Abadie, Alexis Diamond, Jens Hainmueller, Synthetic Control Methods for Comparative Case Studies, NBER Working Paper 12831 (JASA 105(490), 2010)
- Alberto Abadie, Using Synthetic Controls: Feasibility, Data Requirements, and Methodological Aspects, Journal of Economic Literature 59(2), 2021
- Kay H. Brodersen, Fabian Gallusser, Jim Koehler, Nicolas Remy, Steven L. Scott, Inferring causal impact using Bayesian structural time-series models, Annals of Applied Statistics 9(1), 2015
- Google Research, Inferring causal impact using Bayesian structural time-series models (publication page)
- Google, CausalImpact R package documentation
- Google, CausalImpact source repository
- Scott Cunningham, Causal Inference: The Mixtape, online edition
- Scott Cunningham, Causal Inference: The Mixtape, chapter 9: Difference-in-Differences Fundamentals
- Joshua D. Angrist, Jörn-Steffen Pischke, Mostly Harmless Econometrics, Princeton University Press, 2009
- Nick Huntington-Klein, The Effect: An Introduction to Research Design and Causality
- Royal Swedish Academy of Sciences, Press release: The Prize in Economic Sciences 2021
- Donald B. Rubin, Estimating causal effects of treatments in randomized and nonrandomized studies, Journal of Educational Psychology 66(5), 1974
- Judea Pearl, Causal inference in statistics: An overview, Statistics Surveys 3, 2009
- Andrew Goodman-Bacon, Difference-in-Differences with Variation in Treatment Timing, NBER Working Paper 25018 (Journal of Econometrics 225(2), 2021)
- Brantly Callaway, Pedro H. C. Sant'Anna, Difference-in-Differences with multiple time periods, Journal of Econometrics 225(2), 2021
- Marianne Bertrand, Esther Duflo, Sendhil Mullainathan, How Much Should We Trust Differences-in-Differences Estimates?, NBER Working Paper 8841 (QJE 119(1), 2004)
- Jonathan Roth, Pedro H. C. Sant'Anna, Alyssa Bilinski, John Poe, What's trending in difference-in-differences?, Journal of Econometrics 235(2), 2023 (arXiv)
- Ashesh Rambachan, Jonathan Roth, A More Credible Approach to Parallel Trends, Review of Economic Studies 90(5), 2023
- Dmitry Arkhangelsky, Susan Athey, David A. Hirshberg, Guido W. Imbens, Stefan Wager, Synthetic Difference-in-Differences, American Economic Review 111(12), 2021
- Susan Athey, Guido W. Imbens, The State of Applied Econometrics: Causality and Policy Evaluation (arXiv version)
- Brett R. Gordon, Florian Zettelmeyer, Neha Bhargava, Dan Chapsky, A Comparison of Approaches to Advertising Measurement: Evidence from Big Field Experiments at Facebook, Marketing Science 38(2), 2019
Обновлено 20 октября 2026

Маркетинговое агентство или система роста: что нужно на каждом этапе масштабирования
Агентство подходит, пока фаундер сам ведёт большую часть процессов. Когда бизнес начинает копировать себя в новые точки и регионы, нужна система, которая ставит цели, проверяет гипотезы и отвечает за результат.
Агентство медицинского маркетинга: почему работа с клиникой буксует и какую модель используем мы
Большинство агентств отвечают за клик, а за регистратуру не отвечает никто. Как мы строим маркетинг клиники в трёх горизонтах, на каких исследованиях это основано и что дал один год работы.
Тестирование рекламных каналов: почему тест затухает на третьем месяце
Большинство тестов нового рекламного канала заканчиваются не решением. Они заканчиваются, когда кончился бюджет, поменялась атрибуция или все тихо перестали открывать дашборд.