Process mining: что это и как работает
Process mining восстанавливает, как бизнес-процесс идёт на самом деле, по журналам событий в ваших программах, сверяет его с задуманным и показывает, где копятся задержки и переделки.
Process mining — это способ восстановить реальный ход бизнес-процесса по журналам событий в ваших программах. Каждое событие записывает три вещи: номер кейса, действие и время. Дальше три задачи: обнаружение строит модель процесса по журналу, проверка соответствия сверяет журнал с моделью, а улучшение добавляет в модель время шагов и узкие места.
- Автор
- Вил ван дер Аалст и рабочая группа IEEE по process mining (раньше — Кук и Вулф, Агравал с соавторами), 1998 (первые работы по обнаружению процессов по журналам); 2011 (Манифест process mining)
- Уровень
- 401 · Экспертный
- Подходит
- корпорация
- Время на внедрение
- От 2 до 4 недель на первый проект по одному процессу, большая часть уходит на выгрузку и очистку журнала
- Что понадобится
- один процесс с понятным началом и концом, например «заказ — оплата» или «направление пациента — первый визит» · доступ на чтение к системе, которая его записывает, или выгрузка таблицы истории · человек, который знает процесс и может сказать, как выглядит обычный путь
Process mining показывает, как бизнес-процесс идёт на самом деле, по следу, который он оставляет в программах. Рабочая группа IEEE по process mining определяет идею так: находить, отслеживать и улучшать реальные процессы, а не предполагаемые, вытаскивая знания из журналов событий, которые информационные системы и так ведут. Блок-схема, нарисованная на воркшопе, показывает, как люди представляют себе работу. Журнал событий показывает, что происходило, кейс за кейсом.
Откуда взялся process mining
Process mining вырос из нескольких независимых исследований конца 1990-х. В 1998 году Кук и Вулф опубликовали метод обнаружения моделей программных процессов по данным о событиях. В том же году Агравал, Гунопулос и Лейман показали, как добывать модели процессов из журналов рабочих процессов. Группа Вила ван дер Аалста, сначала в Эйндховене, потом в RWTH Aachen, превратила это в набор инструментов, включая альфа-алгоритм. Самая известная его форма описана в статье 2004 года, написанной вместе с Вейтерсом и Марустер.
В 2011 году рабочая группа выпустила Манифест. По данным страницы самой группы, его писали больше 75 человек из более чем 50 организаций. В нём шесть руководящих принципов и одиннадцать открытых задач, и это до сих пор самое короткое авторитетное описание области. Книга ван дер Аалста Process Mining: Data Science in Action, уже во втором издании, остаётся стандартным учебником.
Что такое журнал событий
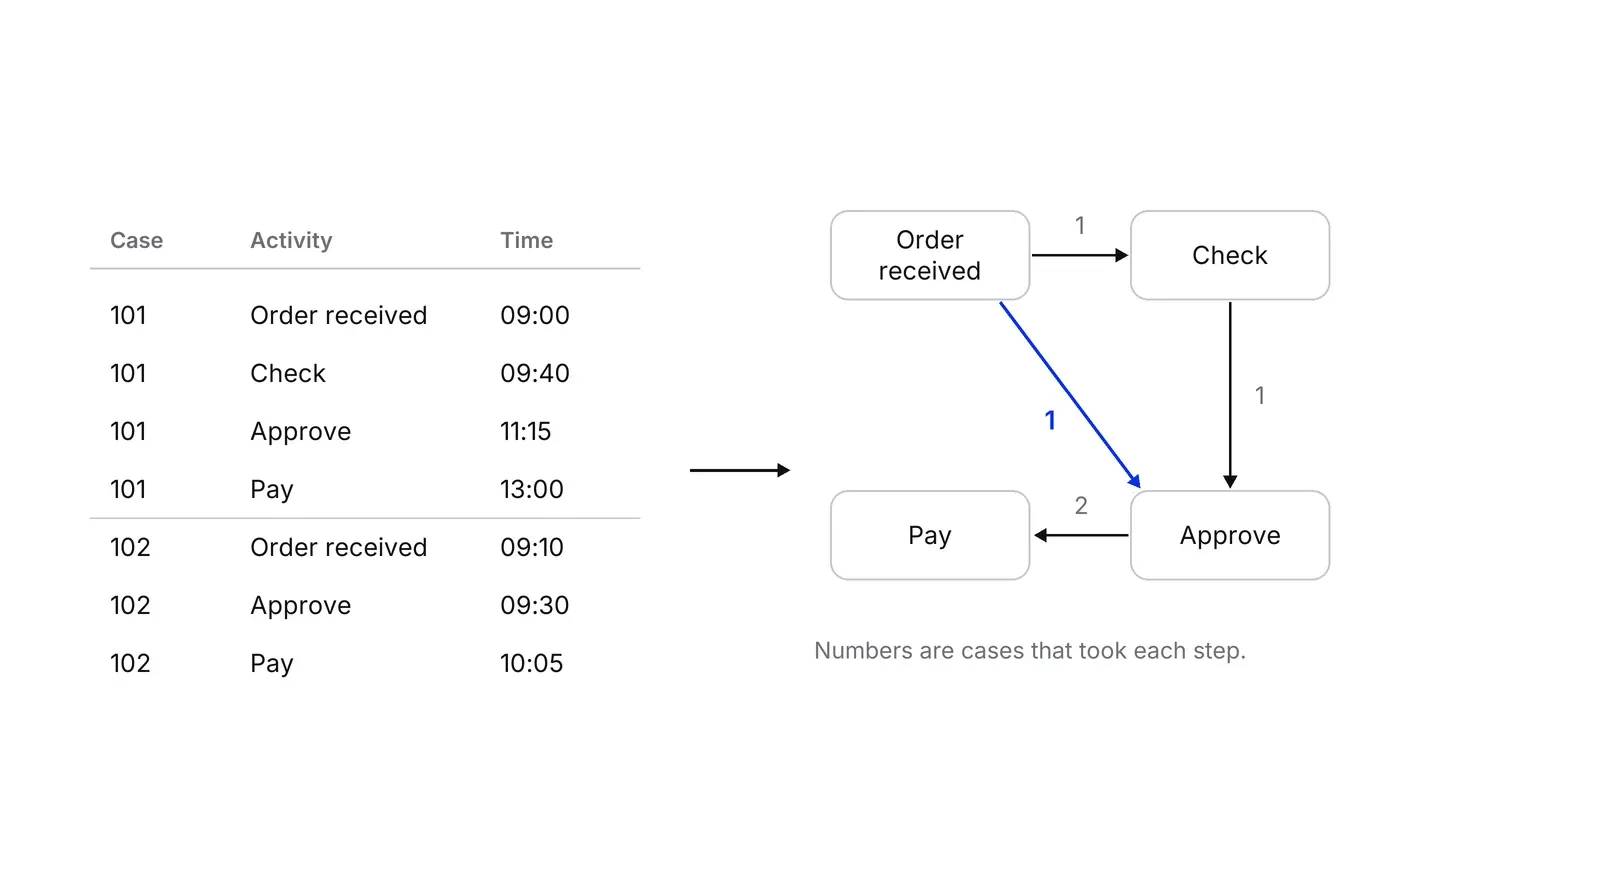
Журнал событий — это таблица, где каждая строка описывает одно событие, а каждое событие указывает кейс и действие. Fluxicon, вендор инструментов для process mining, называет минимум из трёх элементов: номер кейса, действие и время. Манифест добавляет, что методы используют ещё исполнителя, то есть человека или устройство, и данные, записанные вместе с событием, например размер заказа.
Кейс — это единица, за которой вы следите. В закупках, в примере Fluxicon, один заказ поставщику — один кейс, и его события («создан», «согласован», «оплачен») несут номер заказа. Документация Microsoft даёт то же правило для своего инструмента: номер кейса обязан быть у всех действий, и это может быть номер пациента, заказа или обращения.
Данные должны быть историей событий. В заметке Fluxicon о требованиях к данным сказано, что их нельзя агрегировать до уровня кейса: одна строка на кейс стирает последовательность. Во многих таблицах систем лежит только текущее состояние записи. Руководство Microsoft отмечает, что не все нужные события попадают в журнал и что таблицу истории, возможно, придётся склеить с другими таблицами, чтобы получить названия и идентификаторы. Стандарт IEEE 1849 XES нужен для того, чтобы инструменты обменивались журналами событий в одном формате.
Три типа process mining
Манифест выделяет три вида process mining, и различает их то, что подаётся на вход и что получается на выходе.
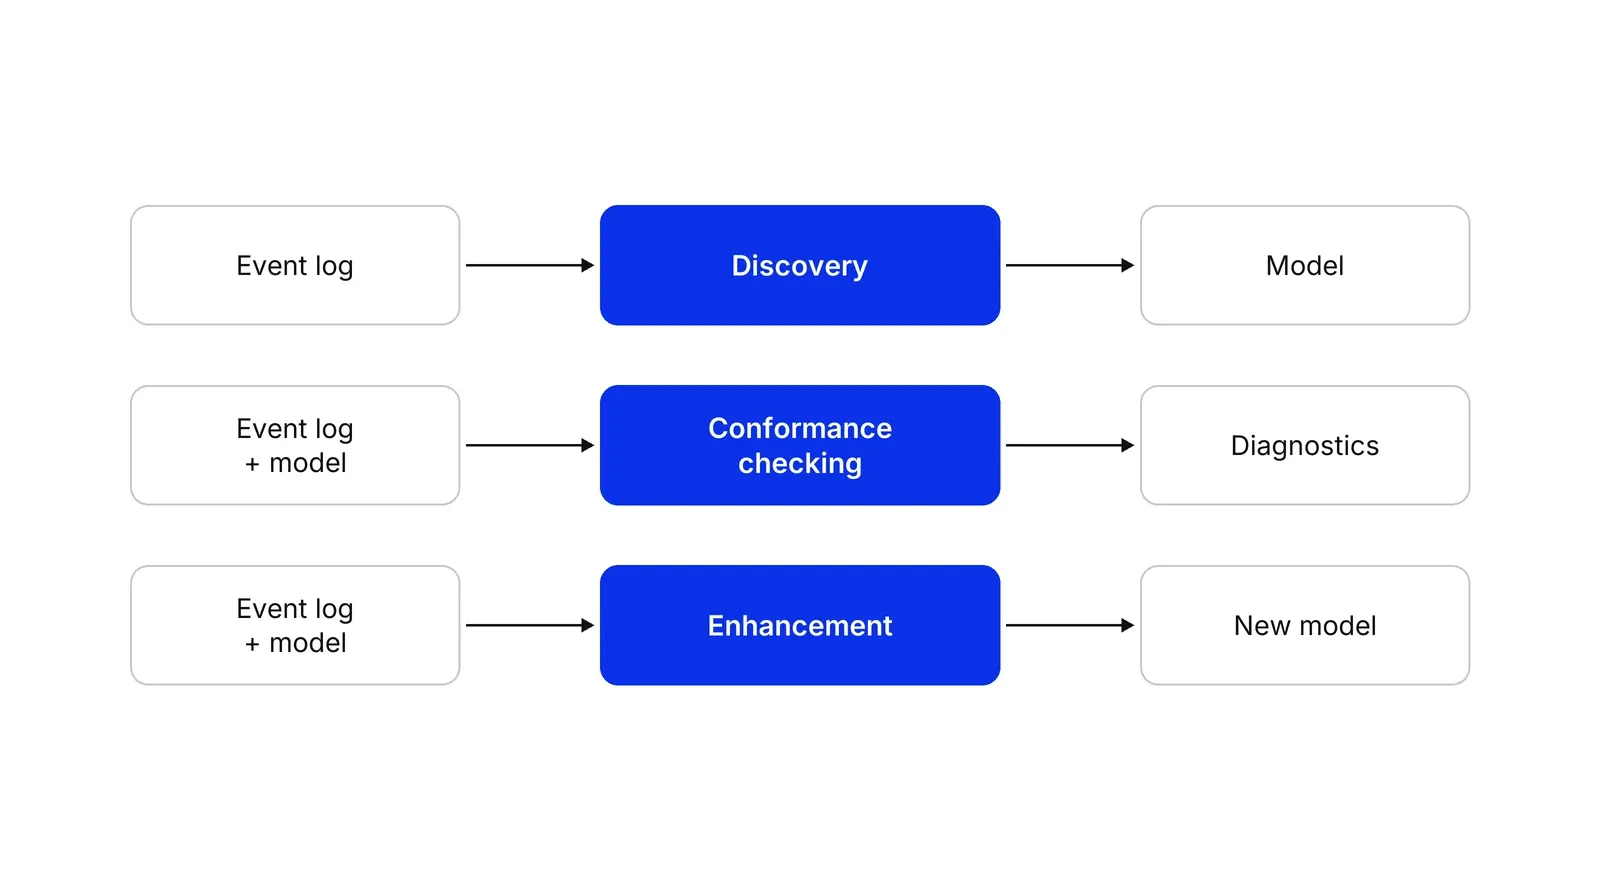
Обнаружение (discovery) берёт журнал событий и строит модель без какой-либо предварительной информации. Альфа-алгоритм строит сеть Петри по тому, в каком порядке действия следуют друг за другом. Индуктивный майнер Леманса, Фаланда и ван дер Аалста, опубликованный в 2013 году, строит блочно-структурированные модели. Он есть в PM4Py, библиотеке Python с открытым кодом.
Проверка соответствия (conformance checking) сравнивает с журналом готовую модель или правило. В 2008 году Розинат и ван дер Аалст измеряли две вещи: fitness, то есть следует ли записанное поведение модели, и appropriateness, то есть описывает ли модель то, что наблюдали. Метод отвечает на вопрос, соблюдают ли люди регламент согласования.
Улучшение (enhancement) использует журнал, чтобы расширить или починить модель. Ван дер Аалст, Адриансьях и ван Донген показали в 2012 году: если прогнать историю по модели и добавить отметки времени, видны узкие места. Так большинство бизнес-команд и находит медленный шаг.
Чем process mining отличается от соседних методов
| Метод | Откуда стартует | Что показывает | Слабое место |
|---|---|---|---|
| Process mining | Журналы событий систем | Реальные пути со счётчиками и временем | Не видит работу, которая не оставляет журнала |
| BPMN | Интервью и воркшопы | Задуманный процесс в стандартной нотации | Показывает замысел, а не действия людей |
| Карта потока создания ценности | Обход потока | Ожидания и передачи в физическом потоке | Ручная работа, снимок нескольких кейсов |
| SIPOC | Короткий воркшоп | Границы: поставщики, входы, процесс, выходы, клиенты | Слишком грубо для анализа |
| Task mining | Журналы действий на компьютере и в вебе | Как один человек выполняет задачу | Не прослеживает кейс между системами |
| Data mining | Таблица записей | Закономерности в данных | Не строится вокруг моделей процессов |
По последней строке: обзор ван дер Аалста 2012 года говорит, что классические методы data mining часто применяют к отдельному шагу, а process mining смотрит на процессы целиком, от начала до конца. Лено с соавторами называют исследования по поиску рутин в журналах действий пользователя robotic process mining. Эти исследования помогают автоматизации бизнес-процессов: показывают, какие рутины стоит превращать в скрипты. Process mining и план трекинга событий — близкие родственники: хороший план трекинга как раз и делает события продукта пригодными для журнала.
Где всё ломается
Главный риск — данные. Суриади с коллегами описали типичные дефекты реальных журналов, например пропавшие, задвоенные или стоящие не в том порядке события, и предложили шаблоны их очистки. Второй риск — изменения самого процесса: Бос с коллегами показали, что процесс может дрейфовать прямо во время анализа, и тогда одна карта смешивает две версии процесса.
Важны ещё масштаб и устройство данных. Манифест сообщает, что ASML постоянно следит за своими сканерами пластин и что существующие инструменты с трудом справлялись с петабайтами данных. Классические журналы предполагают один тип кейса, а в реальных системах одно событие часто связано сразу с несколькими объектами, например с заказом и его позициями. Именно поэтому стандарт OCEL 2.0 из RWTH Aachen записывает события вместе с участвующими объектами.
Осторожнее с доказательствами. В отчёте о промышленном применении 2007 года ван дер Аалст с коллегами отмечали, что мало продвинутых методов проверено на реальных процессах. Страницы вендоров, например Celonis, обещают результат быстрее и дешевле воркшопов и ссылаются на клиентов, но независимых доказательств на странице нет. Читайте это как утверждения, которые нужно проверить на вашем журнале.
Разбор карты процесса командой — это аудит трения, сделанный на данных. Если процессы за вашей воронкой и бэк-офисом описаны плохо, разбор Marketing-Operational System может взять журнал событий первым входом.
Как применять: Process mining: что это и как работает по шагам
- Начните с вопроса. Сформулируйте вопрос, на который должен ответить анализ: почему выплаты занимают 4 дня, где начинаются переделки. Манифест process mining советует строить выгрузку журнала вокруг вопросов: в базе ERP тысячи таблиц, и без вопроса нужные не выбрать. Результат: вопрос в одну фразу и названный процесс.
- Выберите кейс. Решите, что считать одним прогоном процесса: один заказ поставщику, один визит пациента, одну заявку мерчанта. У каждого события должен быть этот идентификатор. Результат: определение кейса, по которому можно склеить все источники данных.
- Выгрузите по строке на событие. Достаньте для каждого события номер кейса, название действия и время, плюс исполнителя и атрибуты, по которым будете фильтровать, например сумму или канал. Храните историю целиком, не сворачивайте её до одной строки на кейс. Результат: сырой журнал событий.
- Очистите журнал. Проверьте события без времени, дубли, названия действий, которые различаются только написанием, и события, записанные намного позже, чем произошли. Исправьте их или уберите и запишите, что именно убрали. Результат: журнал, которому вы доверяете настолько, что готовы показать его владельцу процесса.
- Обнаружьте процесс и разберите варианты. Загрузите журнал в инструмент, постройте карту процесса и выпишите варианты — разные пути, которыми шли кейсы. Начните с нескольких вариантов, которые покрывают большинство кейсов, затем посмотрите на редкие. Результат: карта того, что происходит, со счётчиками и длительностью на каждом шаге.
- Сверьте карту с правилами. Сравните карту с задуманным процессом или регламентом, например с двойным согласованием перед платежом. Каждое отклонение отметьте как оправданное исключение или как дефект. Результат: короткий список отклонений с долей затронутых кейсов.
- Исправьте и повторите на свежих данных. Измените процесс или систему под самый крупный дефект, а через несколько недель повторите выгрузку. Манифест называет непрерывный process mining одним из руководящих принципов. Результат: сравнение «до» и «после» по тем же показателям.
Примеры
Клиника: от направления до первого визита
Иллюстративный пример. Клиника выгружает таблицу истории из системы записи: по строке на каждую смену статуса, с номером записи, статусом и временем. Обнаружение показывает, что большинство записей идёт так: «Направление получено», «Звонок сделан», «Визит назначен», «Визит состоялся». Примерно у каждой шестой записи перед назначением визита есть второй шаг «Звонок сделан». Проверка соответствия по правилу «на каждое направление звонят в течение одного рабочего дня» отмечает кейсы, которые прождали выходные. Решение — слот для звонков в пятницу после обеда, а следующая выгрузка покажет, исчезли ли ожидания через выходные.
Платёжная компания: онбординг мерчантов
Иллюстративный пример. Кейс — одна заявка мерчанта, а события берутся из CRM, комплаенс-системы и бэк-офиса платежей и склеиваются по номеру заявки. На карте видно, что заявки по три-четыре раза гоняются между шагами «Документы запрошены» и «Документы получены». Фильтр по странам показывает, что петли собраны в двух рынках, где шаблоны документов отличаются от остальных. Команда переписывает эти два запроса и через месяц сравнивает число петель.
Когда применять
Используйте, когда процесс идёт через программы, которые записывают каждый шаг, кейсов достаточно много, чтобы не судить по горстке (сотни и больше), а реальный путь спорный, скрытый или слишком медленный. Подходит для цепочек «заказ — оплата», «закупка — платёж», страховых случаев, онбординга и поддержки. Помогает и перед автоматизацией: видно, какие шаги стоит автоматизировать и какие варианты сломают скрипт.
Когда не применять
Пропустите, если работа идёт вне систем (звонки, бумага, чаты) и не оставляет отметок времени, или если за месяц через процесс проходит горстка кейсов. Если процесса ещё нет, сначала нарисуйте его в BPMN. А если главный вопрос — где теряется ценность в физическом потоке, больше научит карта потока создания ценности прямо в цехе.
Частые ошибки
- Начинать с инструмента, а не с вопроса. Карту всех таблиц ERP нельзя прочитать. Сначала выберите один процесс и один вопрос.
- Брать журнал, который не хранит историю событий. Таблицы, где хранится только текущее состояние записи, не покажут, как она к нему пришла. Проверьте, что каждая смена статуса хранится со временем.
- Слепо верить отметкам времени. События, внесённые позже, чем случились, или пачками, искажают длительности и порядок шагов. Спросите, как создаётся каждая отметка.
- Считать каждое отклонение дефектом. Часть отклонений — это обработка исключений, благодаря которой клиенты остаются довольны. Прежде чем что-то менять, разберите их с владельцем процесса.
- Запустить один раз и забыть. Процессы дрейфуют, и карта прошлой весны может описывать процесс, которого уже нет.
Вопросы и ответы
Какие данные нужны для process mining?
Журнал событий, где у каждого события есть как минимум номер кейса, название действия и время, по одной строке на событие. Исполнитель и атрибуты вроде суммы или канала не обязательны, но делают анализ богаче. Агрегированных данных с одной строкой на кейс мало, потому что они теряют последовательность шагов.
Чем process mining отличается от data mining?
Data mining ищет закономерности в данных и часто применяется к одному шагу процесса. В обзоре Вила ван дер Аалста 2012 года в ACM Transactions on Management Information Systems сказано, что классические методы data mining не сосредоточены на моделях процессов, а process mining анализирует процессы целиком по данным о событиях.
Чем process mining отличается от task mining?
Process mining работает с журналами событий бизнес-систем. Task mining, который в науке изучают как robotic process mining, работает с журналами действий пользователя в настольных и веб-приложениях и ищет повторяющиеся рутины, которые можно автоматизировать. Первый показывает, как кейс движется между системами, второй — как один человек выполняет задачу.
Кто придумал process mining?
Единого автора нет. Кук и Вулф опубликовали обнаружение процессов по данным о программных процессах в 1998 году, и в том же году Агравал, Гунопулос и Лейман опубликовали работу об извлечении моделей процессов из журналов workflow-систем. Большую часть метода развила группа Вила ван дер Аалста в Эйндховене, позднее в RWTH Aachen; она же помогла написать Манифест 2011 года.
Источники
- Wil van der Aalst, Process Mining: Data Science in Action, 2nd edition, Springer, 2016
- IEEE Task Force on Process Mining, Process Mining Manifesto, BPM 2011 Workshops, LNBIP 99, Springer, 2012
- IEEE Task Force on Process Mining, Process Mining Manifesto (task force page, with the full text)
- Wil van der Aalst, Ton Weijters, Laura Maruster, Workflow mining: discovering process models from event logs, IEEE Transactions on Knowledge and Data Engineering 16(9), 2004
- Rakesh Agrawal, Dimitrios Gunopulos, Frank Leymann, Mining process models from workflow logs, EDBT 1998, Springer LNCS 1377
- Jonathan Cook, Alexander Wolf, Discovering models of software processes from event-based data, ACM Transactions on Software Engineering and Methodology 7(3), 1998
- Anne Rozinat, Wil van der Aalst, Conformance checking of processes based on monitoring real behavior, Information Systems 33(1), 2008
- Wil van der Aalst, Arya Adriansyah, Boudewijn van Dongen, Replaying history on process models for conformance checking and performance analysis, WIREs Data Mining and Knowledge Discovery 2(2), 2012
- Sander Leemans, Dirk Fahland, Wil van der Aalst, Discovering block-structured process models from event logs: a constructive approach, Petri Nets 2013, Springer LNCS 7927
- R. P. Jagadeesh Chandra Bose, Wil van der Aalst, Indre Zliobaite, Mykola Pechenizkiy, Dealing with concept drifts in process mining, IEEE Transactions on Neural Networks and Learning Systems 25(1), 2014
- Wil van der Aalst, Process mining, ACM Transactions on Management Information Systems 3(2), 2012
- Wil van der Aalst, Hajo Reijers, Ton Weijters, Boudewijn van Dongen and others, Business process mining: an industrial application, Information Systems 32(5), 2007
- Marlon Dumas, Marcello La Rosa, Jan Mendling, Hajo Reijers, Fundamentals of Business Process Management, 2nd edition, Springer, 2018
- Wil van der Aalst, Josep Carmona (eds.), Process Mining Handbook, Springer LNBIP 448, 2022 (open access)
- Jochen De Weerdt, Moe Wynn, Foundations of process event data, in Process Mining Handbook, Springer, 2022
- Suriadi, Andrews, ter Hofstede, Wynn, Event log imperfection patterns for process mining: towards a systematic approach to cleaning event logs, Information Systems 64, 2017
- XES, the IEEE 1849 standard for exchanging event logs
- RWTH Aachen, OCEL 2.0: the object-centric event log standard
- Fluxicon (vendor), Process mining book: data requirements and the minimum requirements for an event log
- Fluxicon (vendor), Data requirements for process mining, 2012
- Microsoft Learn (vendor docs), Prepare processes and data for process mining in Power Automate
- Celonis (vendor), What is process mining (marketing claims, not independent evidence)
- Process Intelligence Solutions (Fraunhofer FIT spin-off), PM4Py open-source library
- Volodymyr Leno, Artem Polyvyanyy, Marlon Dumas, Marcello La Rosa, Fabrizio Maggi, Robotic process mining: vision and challenges, Business & Information Systems Engineering 63(3), 2021
- Eduardo Rojas, Jorge Munoz-Gama, Marcos Sepulveda, Daniel Capurro, Process mining in healthcare: a literature review, Journal of Biomedical Informatics 61, 2016
- Thomas Reinkemeyer (ed.), Process Mining in Action: Principles, Use Cases and Outlook, Springer, 2020
- RWTH Aachen Process and Data Science group, processmining.org
Обновлено 20 октября 2026

Операционный директор на аутсорсе или встроенная операционная команда: что выбрать на раунде A
Эти две модели закрывают разные дыры. Как понять, какая нужна вашей компании, и чем каждая обходится во времени и в контроле.
Fractional руководитель: четыре модели, цена и где всё ломается
Приходящий, временный, советник или встроенная команда: под одним словом прячутся четыре разные схемы. Они отличаются полномочиями, занятостью и выходом, и каждая ломается по-своему.
Операционная система финтех-стартапа: четыре контура, на которых выросли десять компаний
Starling, Monzo, Qonto, bunq, Lunar, Pleo, Tide, Ramp, Mercury и Column росли на четырёх операционных контурах. Решения регуляторов показывают, что ломается, когда один из них отстаёт от роста.