Прогнозирование оттока клиентов: модель и примеры
Предиктивная модель оттока по прошлому поведению клиентов оценивает, кто уйдёт в заданный срок, чтобы команда удержания решила, на кого тратить силы, пока клиент ещё не потерян.
Прогнозирование оттока — это обучение статистической модели или модели машинного обучения на прошлом поведении клиентов, чтобы оценить шанс ухода каждого из них в фиксированный срок, например за 90 дней. По рейтингу риска команда удержания выбирает, кому писать и звонить. Исследования показывают, что отбор только по риску может впустую сжечь бюджет, поэтому сильные программы заодно оценивают, на кого предложение действительно влияет.
- Автор
- Единого автора нет; метод проверяли в маркетинговой науке Неслин с коллегами, Леммен и Круа, Аскарса, Турнир по оттоку опубликован в 2006; критика таргетинга по риску — 2018
- Уровень
- 401 · Экспертный
- Подходит
- растущая компания, корпорация
- Время на внедрение
- Четыре–восемь недель на первую модель и первый тест с контрольной группой, если история клиентов уже собрана в одной таблице
- Что понадобится
- записи о клиентах минимум за год с датой ухода каждого, сохранённые по датам, а не перезаписанные · чёткое определение «ушёл» и окно прогноза, например отсутствие продления в течение 90 дней · действие по удержанию с известной стоимостью на клиента и возможность не трогать часть клиентов
Предиктивная модель оттока обучается на прошлом поведении клиентов и оценивает шанс, что каждый из них уйдёт в заданный срок. Команда удержания сортирует клиентов по этому шансу и тратит бюджет на верх списка. Как отдельная область исследований метод оформился в 2000-х, когда маркетинговые учёные сравнили, насколько хорошо разные модели находят уходящих. Простую оценку, которую собирают вручную, разбирает страница про оценку здоровья клиента. Здесь речь о статистической версии и о вопросе, который идёт сразу за ней: кого выбрать для контакта.
Что предсказывает модель?
Ответ «да» или «нет» на фиксированный период: уйдёт ли этот клиент в ближайшие 90 дней? Как его получить, зависит от того, как уход выглядит в ваших данных. В контрактных сферах, таких как подписки и банковские счета, отмена записывается, и метку можно ставить прямо. Аскарса и Харди строят для этого случая совместную модель использования и продления: обе величины в ней считаются признаками одного скрытого состояния клиента.
Там, где контракта нет, например в магазине или на маркетплейсе, об уходе никто не объявляет. Модели вроде модели Фейдера, Харди и Ли по истории покупок оценивают, активен ли клиент ещё. Здесь до разметки нужно выбрать правило, например 120 дней молчания, и только потом называть кого-то ушедшим.
Как строится модель?
Возьмите прошлую дату, её называют датой среза. По каждому клиенту соберите то, что было известно на эту дату, и запишите, ушёл ли он в окне после неё. Повторите для нескольких дат и сложите результаты в одну обучающую таблицу.
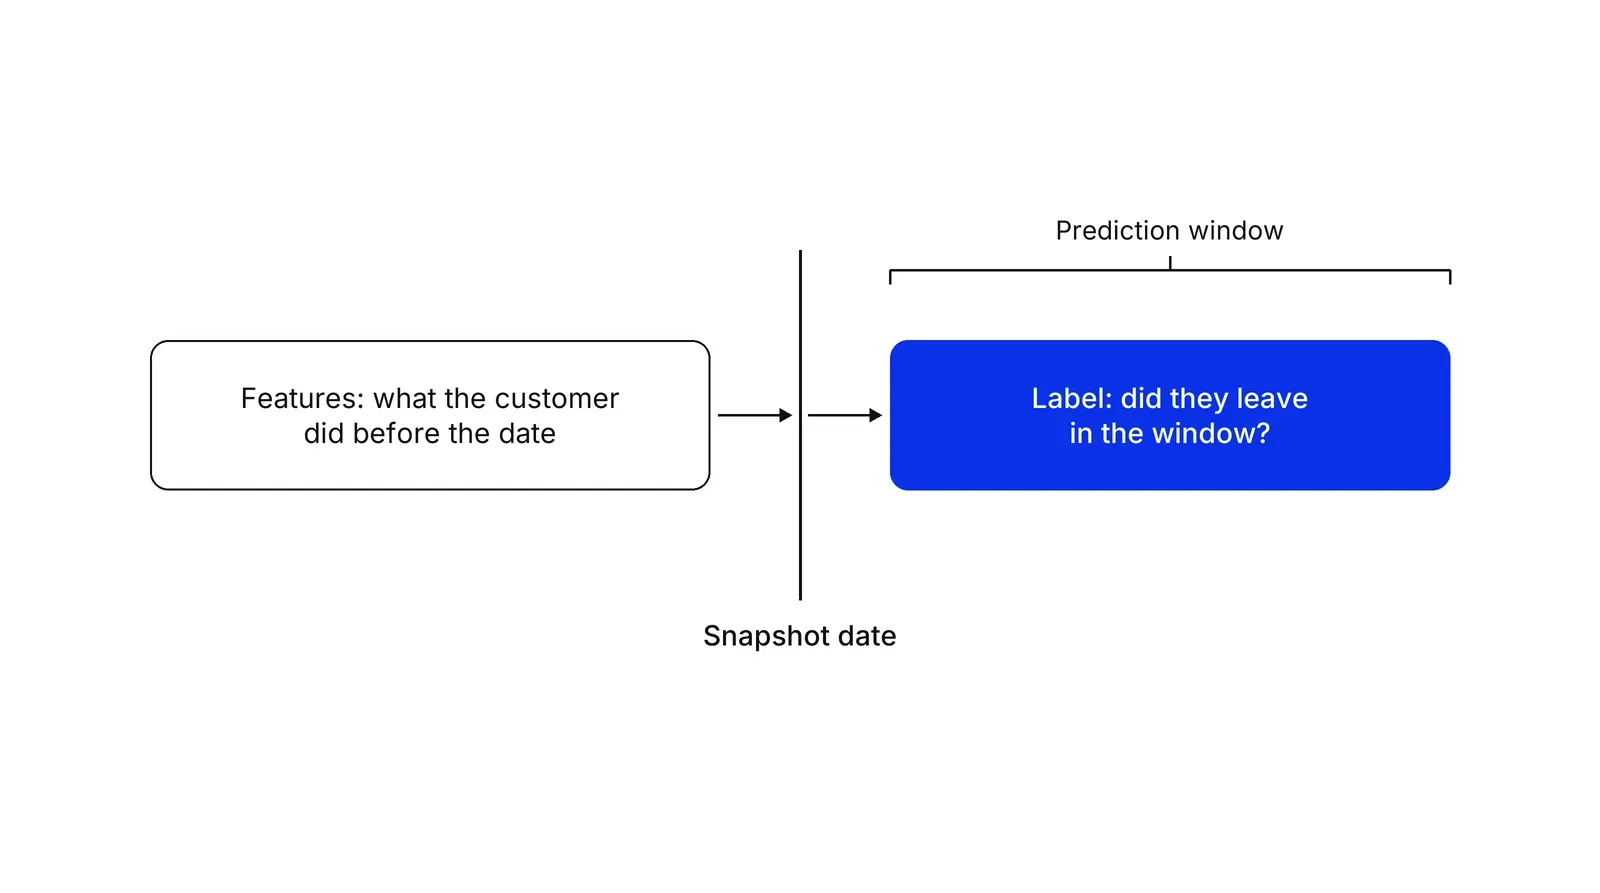
Строгость с датами нужна из-за утечки данных. Кауфман с коллегами определяют утечку как информацию о целевой переменной, которой не должно быть, когда модель работает. Типичный случай — поле «последний вход», перезаписанное после ухода клиента. Длина истории тоже выбор: Баллингс и Ван ден Поэль изучают, сколько истории событий клиента нужно модели оттока.
Какой алгоритм выбрать?
Начните с простого и сравнивайте. В турнире по оттоку, который провели Неслин с коллегами, учёные и практики обучали модели на одних и тех же открытых данных. Авторы сообщают, что выбор метода важен: разница способна изменить прибыль кампании на сотни тысяч долларов. Ещё они пишут, что на данных, собранных тремя месяцами позже, модели теряют в точности совсем немного.
Леммен и Круа выяснили, что бэггинг и бустинг классификационных деревьев значимо улучшили прогноз оттока у американского оператора беспроводной связи. Для редких событий они советуют сбалансированную выборку с поправкой на смещение. Бустинг деревьев остаётся стандартным выбором, например через XGBoost. Вербеке, Мартенс и Баесенс добавляют анализ социальных сетей, где дополнительным входом служат связи между клиентами, а анализ выживаемости учитывает клиентов, которые ещё не ушли.
Как понять, что модель хороша?
Проверяйте её на более позднем периоде и по тому, чего стоит решение. Случайное перемешивание кладёт в обучающую и тестовую выборки строки, близкие по времени, и завышает результат, о чём предупреждает руководство scikit-learn, поэтому проверяйте «вперёд» по времени.
Уходят редко, и точность вводит в заблуждение. Площадь под ROC-кривой, по Хэнли и Макнилу, равна шансу, что случайный уходящий окажется выше случайного оставшегося. Сайто и Рехмсмайер считают, что на несбалансированных данных точность и полнота (precision и recall) говорят больше. Вероятности должны быть ещё и откалиброваны: из клиентов с оценкой 30% должны уйти около 30%.
Главная проверка — деньги. Вербеке с коллегами ставят прогноз оттока как задачу, ориентированную на прибыль, а Леммен и Гупта предлагают оптимизировать прибыль кампаний удержания подходом машинного обучения к причинному выводу. Рейтинг стоит ровно столько, сколько кампания зарабатывает на группе, на контакт с которой хватит бюджета.
Выбирать по риску или по uplift?
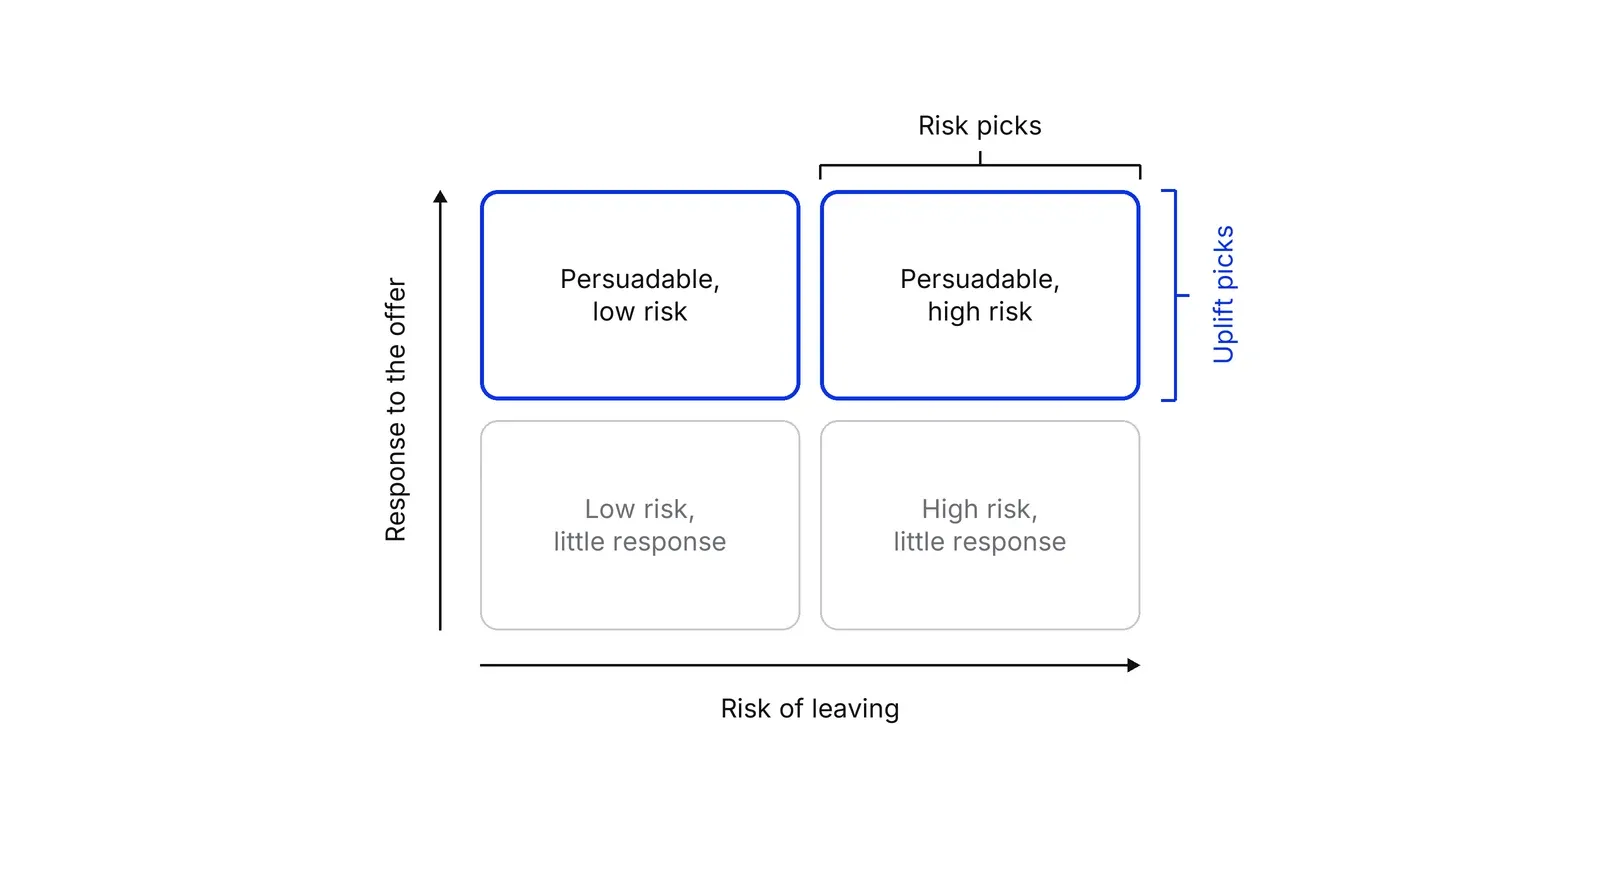
Таргетинг по риску — это контакт с теми, кто скорее всего уйдёт. Таргетинг по uplift — контакт с теми, чей шанс уйти предложение меняет сильнее всего. Это разные списки. Полевые эксперименты Аскарсы показали, что клиенты с самым высоким риском не обязательно лучшие цели и что компаниям стоит выбирать тех, кто чувствителен к воздействию, независимо от риска.
| Таргетинг по риску | Таргетинг по uplift | |
|---|---|---|
| На какой вопрос отвечает | Кто, вероятно, уйдёт? | На кого предложение влияет? |
| Обучающие данные | Прошлое поведение и исходы | Рандомизированный тест действия |
| Типичная потеря | Контакт с теми, кто уже ушёл или не реагирует | Сначала нужен эксперимент |
| Оценка | AUC, precision, калибровка | Кривые Qini и uplift |
У uplift-моделирования своя литература. Жепаковский и Ярошевич моделируют изменение вероятности класса, которое вызывает действие. Гутьеррес и Жерарди обзорно описывают основные подходы, а Вейджер и Эти и Кюнцель с коллегами предлагают причинные леса и метаобучение. Относитесь к результатам осторожно: Девриендт, Молдован и Вербеке нашли, что случайные леса для uplift входят в число лучших по мерам Qini и Gini, но uplift-модели часто нестабильны от одной части кросс-валидации к другой. Хитч, Мисра и Чжан изучают, как оценивать политики таргетинга, построенные на таких оценках, а обзор Аскарсы и коллег шире рассматривает управление удержанием.
Данные для uplift-модели должны прийти из рандомизированного теста, как описано в разделе про тесты инкрементальности. Оценки затем используются в решениях по следующему лучшему действию, а кампании по возврату клиентов работают с теми, кто уже ушёл. Результаты по группам регистрации читайте через когортный анализ, а итог отслеживайте через чистое удержание выручки (NRR). План Growth Lab начинается с модели, проверенной «вперёд» по времени, и действия, проверенного на контрольной группе.
Как применять: Прогнозирование оттока клиентов: модель и примеры по шагам
- Определите отток и окно. Запишите, что считается уходом: отмена тарифа, истёкший договор, 120 дней без покупки. Выберите окно, на которое модель строит прогноз, например ближайшие 90 дней. Результат: одно предложение, по которому каждому клиенту ставится метка.
- Соберите срезы. Для каждой из нескольких прошлых дат соберите всё, что было известно о каждом клиенте на эту дату, и отметьте, ушёл ли он в окне после неё. Используйте только то, что существовало на дату среза. Результат: таблица «клиент, дата, признаки, метка», в которой нет ничего из будущего.
- Сначала простая модель. Начните с логистической регрессии или одного решающего дерева, потом сравните с моделью на градиентном бустинге деревьев. Оставьте ту, что лучше на более позднем периоде, которого модель не видела. Результат: базовая модель и модель-претендент, у каждой указан период проверки.
- Оцените модель деньгами. Отсортируйте клиентов по оценке, возьмите верхнюю группу, на контакт с которой хватит бюджета, и посчитайте пойманных уходящих, стоимость контакта и ценность спасённых клиентов. Результат: ожидаемая прибыль для каждого размера кампании, а не только цифра точности.
- Проверьте действие на контрольной группе. Случайно разделите группу, отобранную для контакта: одним дайте предложение по удержанию, другим не давайте ничего. Сравните отток в двух группах. Результат: измеренный эффект действия в целом и по диапазонам риска.
- Перейдите от риска к uplift. На данных эксперимента обучите вторую модель, которая предсказывает, насколько действие меняет отток, и ранжируйте клиентов по этому изменению. Проверьте на новой контрольной группе. Результат: список для кампании, построенный по отклику, а не по риску.
Примеры
Приложение по подписке
Иллюстративный расчёт. В приложении 10 000 подписчиков, 5% уходят за 90 дней, то есть 500 человек. В верхнем дециле по оценке модели, это 1000 подписчиков, находятся 250 из них. Контакт с предложением стоит 150 ₽, спасённый подписчик приносит 3000 ₽. Если предложение снижает отток на 2 пункта среди самых рискованных 1000, спасены 20 человек, и кампания в минусе: заработали 60 000 ₽, потратили 150 000 ₽. Если модель отклика находит 1000 подписчиков, у которых предложение снижает отток на 8 пунктов, спасены 80: 240 000 ₽ против тех же 150 000 ₽.
Текущие счета в розничном банке
Иллюстративный пример. Банк отмечает клиентов, у которых перестала приходить зарплата и упали траты по карте. Модель их оценивает, но первый тест с контрольной группой показывает: клиенты с самой высокой оценкой уже перевели основной счёт в другой банк и на звонок не реагируют. Команда сдвигает действие раньше, на клиентов из середины шкалы, где звонок ещё меняет исход.
Членские программы сети клиник
Иллюстративный пример. Медицинская сеть продаёт годовые абонементы и за 60 дней до окончания прогнозирует, кто не продлит, по визитам, пропущенным приёмам и активности в приложении. Действие по удержанию — бесплатный профилактический осмотр. Клиника сравнивает тех, кто получил приглашение, с контрольной группой, которой его не отправляли, и выясняет, спасает ли осмотр абонементы или просто достаётся тем, кто продлил бы и так.
Когда применять
Применяйте, когда клиентов много, есть история по датам за несколько лет, понятен момент ухода, а у действия по удержанию есть реальная цена. Метод подходит подпискам, банкам, телекому, страхованию и абонементам: уход там фиксируется, и кампания успевает дойти до человека до того, как он уйдёт.
Когда не применять
Откажитесь, если клиентов несколько сотен и аккаунт-менеджер сам знает, кто недоволен, или если ушедших в прошлом слишком мало, чтобы на них учиться. Откажитесь и тогда, когда вы не сможете использовать результат: прогноз без действия по удержанию даёт только отчёт. Для тех, кто купил один раз и не вернулся, берите RFM-анализ или когортный анализ.
Частые ошибки
- Считают клиентов с самым высоким риском лучшими целями. Полевые эксперименты Аскарсы показали, что это не обязательно те, на чьё поведение программа удержания способна повлиять.
- Пускают будущее в признаки. Поле, которое перезаписали после ухода клиента, например дата последнего входа, и проверка на истории выглядит лучше, чем модель потом сработает вживую.
- Оценивают модель только по точности. Когда уходят редко, модель, предсказывающая «не уйдёт никто», очень точна и бесполезна, поэтому смотрите на прибыль при том размере кампании, который вам по карману.
- Пропускают контрольную группу. Без клиентов, которым ничего не предлагали, не отличить спасённых от тех, кто остался бы и так.
- Обучают модель один раз и больше не проверяют. Поведение меняется вместе с ценами, продуктом и сезоном, поэтому регулярно пересчитывайте оценку на свежем периоде.
Вопросы и ответы
Как прогнозировать отток клиентов?
Возьмите прошлую дату, запишите, что каждый клиент сделал до неё, и отметьте, кто ушёл в следующем окне, например за 90 дней. Обучите модель на многих таких срезах, затем проверьте её на более позднем периоде. Модель выдаёт вероятность ухода для каждого клиента, и по ней вы выстраиваете рейтинг.
Какая модель лучше всего прогнозирует отток?
Одной лучшей модели нет. В турнире по оттоку 2006 года методы и то, как команды их собирали, меняли прибыль кампании на сотни тысяч долларов. Леммен и Круа обнаружили, что бэггинг и бустинг деревьев повысили точность у одного оператора связи. Начните с простой модели, затем сравните с бустингом деревьев на более позднем периоде.
Насколько точной должна быть модель оттока?
Точность здесь плохая мерка, потому что уходят редко. Смотрите, сколько уходящих попадает в верхний срез, на контакт с которым хватит бюджета, насколько откалиброваны вероятности и какую прибыль даёт кампания. Скромная модель, которая находит нужных людей, может обойти более сильный рейтинг, нацеленный не на тех.
Как прогнозирование оттока применяют в банках и телекоме?
И там, и там уход фиксируется, поведенческих данных много и есть предложение для удержания, поэтому это классические области применения. Исследование Вербеке с коллегами, где модель оценивают по прибыли, и работа Леммен и Круа посвящены телекому. Банк использует тот же метод срезов, только сигналы другие: зарплатные поступления и траты по карте вместо минут разговора.
Чем прогнозирование оттока отличается от uplift-моделирования?
Прогноз оттока оценивает, кто, вероятно, уйдёт. Uplift-моделирование оценивает, насколько конкретное действие меняет шанс ухода каждого клиента. Клиент может быть в высокой зоне риска и не реагировать на предложение, поэтому uplift выстраивает рейтинг по отклику, а не по риску.
Источники
- Scott A. Neslin, Sunil Gupta, Wagner Kamakura, Junxiang Lu, Charlotte Mason, Defection detection: measuring and understanding the predictive accuracy of customer churn models, Journal of Marketing Research 43(2), 2006
- Aurélie Lemmens, Christophe Croux, Bagging and boosting classification trees to predict churn, Journal of Marketing Research 43(2), 2006
- Eva Ascarza, Retention futility: targeting high-risk customers might be ineffective, Journal of Marketing Research 55(1), 2018
- Wouter Verbeke, Karel Dejaeger, David Martens, Joon Hur, Bart Baesens, New insights into churn prediction in the telecommunication sector: a profit driven data mining approach, European Journal of Operational Research 218(1), 2012
- Aurélie Lemmens, Sunil Gupta, Managing churn to maximize profits, Marketing Science 39(5), 2020
- Eva Ascarza, Scott A. Neslin, Oded Netzer, Zachery Anderson, Peter S. Fader, Sunil Gupta and others, In pursuit of enhanced customer retention management: review, key issues, and future directions, Customer Needs and Solutions 5, 2018
- Eva Ascarza, Bruce G. S. Hardie, A joint model of usage and churn in contractual settings, Marketing Science 32(4), 2013
- Peter S. Fader, Bruce G. S. Hardie, Ka Lok Lee, Counting your customers the easy way: an alternative to the Pareto/NBD model, Marketing Science 24(2), 2005
- Piotr Rzepakowski, Szymon Jaroszewicz, Decision trees for uplift modeling with single and multiple treatments, Knowledge and Information Systems 32(2), 2012
- Floris Devriendt, Darie Moldovan, Wouter Verbeke, A literature survey and experimental evaluation of the state-of-the-art in uplift modeling, Big Data 6(1), 2018
- Pierre Gutierrez, Jean-Yves Gérardy, Causal inference and uplift modelling: a review of the literature, Proceedings of Machine Learning Research 67, 2017
- Stefan Wager, Susan Athey, Estimation and inference of heterogeneous treatment effects using random forests, Journal of the American Statistical Association 113(523), 2018
- Sören R. Künzel, Jasjeet S. Sekhon, Peter J. Bickel, Bin Yu, Metalearners for estimating heterogeneous treatment effects using machine learning, PNAS 116(10), 2019
- Günter J. Hitsch, Sanjog Misra, Walter W. Zhang, Heterogeneous treatment effects and optimal targeting policy evaluation, Quantitative Marketing and Economics 22(2), 2024
- Wouter Verbeke, David Martens, Bart Baesens, Social network analysis for customer churn prediction, Applied Soft Computing 14, 2014
- Michel Ballings, Dirk Van den Poel, Customer event history for churn prediction: how long is long enough?, Expert Systems with Applications 39(18), 2012
- Tianqi Chen, Carlos Guestrin, XGBoost: a scalable tree boosting system, Proceedings of the 22nd ACM SIGKDD Conference, 2016
- Shachar Kaufman, Saharon Rosset, Claudia Perlich, Ori Stitelman, Leakage in data mining, ACM Transactions on Knowledge Discovery from Data 6(4), 2012
- Takaya Saito, Marc Rehmsmeier, The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets, PLOS ONE, 2015
- James A. Hanley, Barbara J. McNeil, The meaning and use of the area under a receiver operating characteristic (ROC) curve, Radiology 143(1), 1982
- scikit-learn documentation, Probability calibration
- scikit-learn documentation, Cross-validation: evaluating estimator performance
- scikit-learn documentation, Metrics and scoring: quantifying the quality of predictions
- lifelines documentation, Introduction to survival analysis
Обновлено 20 октября 2026

Маркетинговое агентство или система роста: что нужно на каждом этапе масштабирования
Агентство подходит, пока фаундер сам ведёт большую часть процессов. Когда бизнес начинает копировать себя в новые точки и регионы, нужна система, которая ставит цели, проверяет гипотезы и отвечает за результат.
Агентство медицинского маркетинга: почему работа с клиникой буксует и какую модель используем мы
Большинство агентств отвечают за клик, а за регистратуру не отвечает никто. Как мы строим маркетинг клиники в трёх горизонтах, на каких исследованиях это основано и что дал один год работы.
Тестирование рекламных каналов: почему тест затухает на третьем месяце
Большинство тестов нового рекламного канала заканчиваются не решением. Они заканчиваются, когда кончился бюджет, поменялась атрибуция или все тихо перестали открывать дашборд.