Байесовский A/B-тест: что это и когда остановить
Последовательное и байесовское тестирование — два способа прочитать A/B-тест до планового конца: последовательные методы пересчитывают порог значимости, чтобы повторные проверки не поднимали долю ложных побед выше 5%, а байесовские показывают вероятность того, что вариант лучше, но сами по себе долю ложных побед не контролируют.
Последовательное тестирование — семейство планов A/B-теста, которые позволяют заглядывать в результаты много раз и останавливать тест раньше срока, не выходя за запланированную долю ложных побед: на ранних проверках порог строже. Байесовский A/B-тест показывает вероятность того, что вариант обгоняет контроль. Читать её проще, но если смотреть каждый день и останавливаться на 95%, ложные победители всё равно появляются.
- Автор
- Абрахам Вальд (последовательный критерий отношения вероятностей); Стюарт Покок, Питер О'Брайен и Томас Флеминг (групповые последовательные планы); Герберт Роббинс (смешанные критерии); Рамеш Джохари, Лео Пекелис и Дэвид Уолш (всегда валидный вывод для A/B-тестов), 1945; с 1977 по 1983; 1970; 2015
- Уровень
- 401 · Экспертный
- Подходит
- растущая компания
- Время на внедрение
- час на выбор плана и запись правила остановки; на каждый следующий тест дополнительного времени не нужно, если ваша платформа это поддерживает
- Что понадобится
- размер выборки для теста с фиксированным горизонтом, из вашего обычного расчёта мощности · инструмент для экспериментов или аналитик, который умеет применять последовательные границы или всегда валидные p-значения · правило остановки, записанное и согласованное до запуска
Последовательное тестирование — набор планов A/B-теста, при которых можно смотреть результаты прямо во время теста и останавливать его раньше срока, не поднимая долю ложных побед выше запланированной. Байесовский A/B-тест — другой способ отчитаться о тесте: вместо p-значения он называет вероятность, что вариант обгоняет контроль, и сколько вы потеряете, если ошибётесь с выбором.
Оба подхода отвечают на вопрос, который команды роста задают на второй неделе любого теста: можно ли уже подводить итог? У последовательного ответа история длиннее, чем у веб-тестирования. Абрахам Вальд опубликовал последовательный критерий отношения вероятностей в 1945 году, а медицинские испытания стали использовать плановые промежуточные проверки в конце 1970-х. Байесовские калькуляторы для веб-тестов появились около 2014 года, среди прочих у Эвана Миллера и Криса Стаккио. Ниже разбираем, как работает каждый подход, чего он стоит и где вводит в заблуждение. Предполагаем, что вы уже умеете считать размер обычного теста; это описано на странице про минимальный детектируемый эффект.
Почему подглядывание ломает обычный A/B-тест?
Стандартный тест обещает 5% ложных побед при одной проверке на заранее заданном размере выборки. Каждая лишняя проверка даёт случайному шуму ещё один шанс пересечь порог, а тест, который останавливается при первом пересечении, фиксирует ложную победу. Питер Армитидж с коллегами измерили это ещё в 1969 году. Мы пересчитали на 2 миллионах симулированных тестов, в которых вариант ничего не меняет:
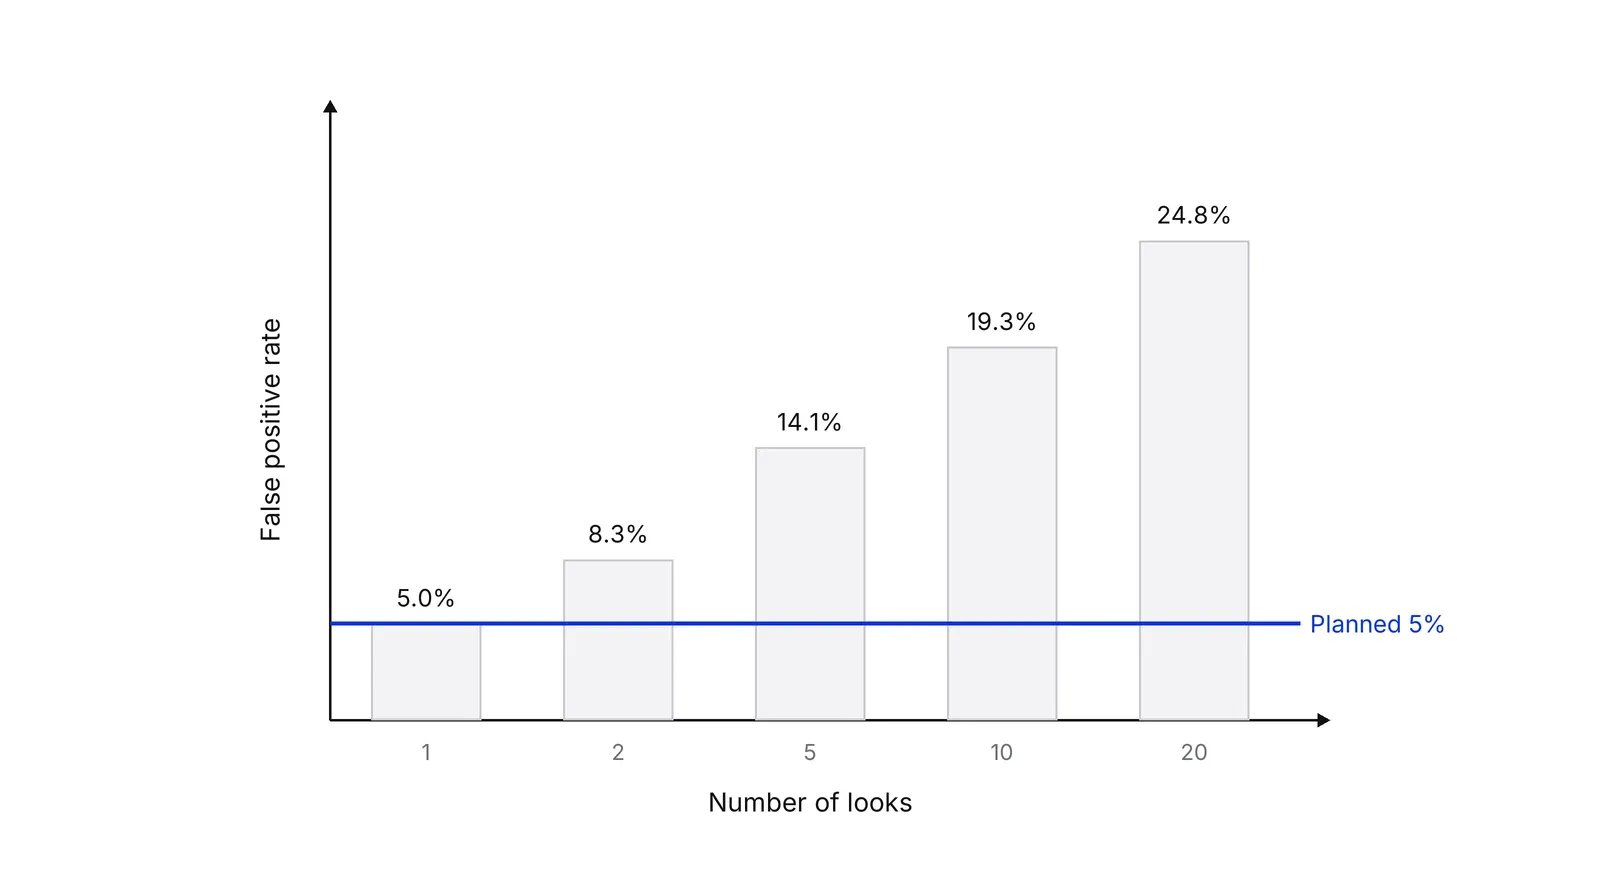
Эту ошибку допускали и вендоры. Первая страница результатов Optimizely обновлялась почти в реальном времени, и компания тогда советовала останавливать тест, как только результат становился значимым, — вспоминают Рон Кохави, Алекс Дэн и Лукас Вермеер в статье KDD 2022 года. Позже Optimizely заменила её на Stats Engine, построенный на всегда валидных методах, о которых речь ниже.
Групповые последовательные планы: несколько плановых проверок
Групповой последовательный план заранее фиксирует число проверок и даёт каждой свой, более строгий порог, поэтому суммарная доля ложных побед остаётся на уровне 5%. Стюарт Покок предложил постоянный порог в 1977 году. Питер О’Брайен и Томас Флеминг предложили порог, который начинается очень строго и к концу ослабевает почти до 1,96. Гордон Лан и Дэвид ДеМетс в 1983 году добавили расходование альфы: с ним время проверок можно сдвигать, не теряя гарантии.
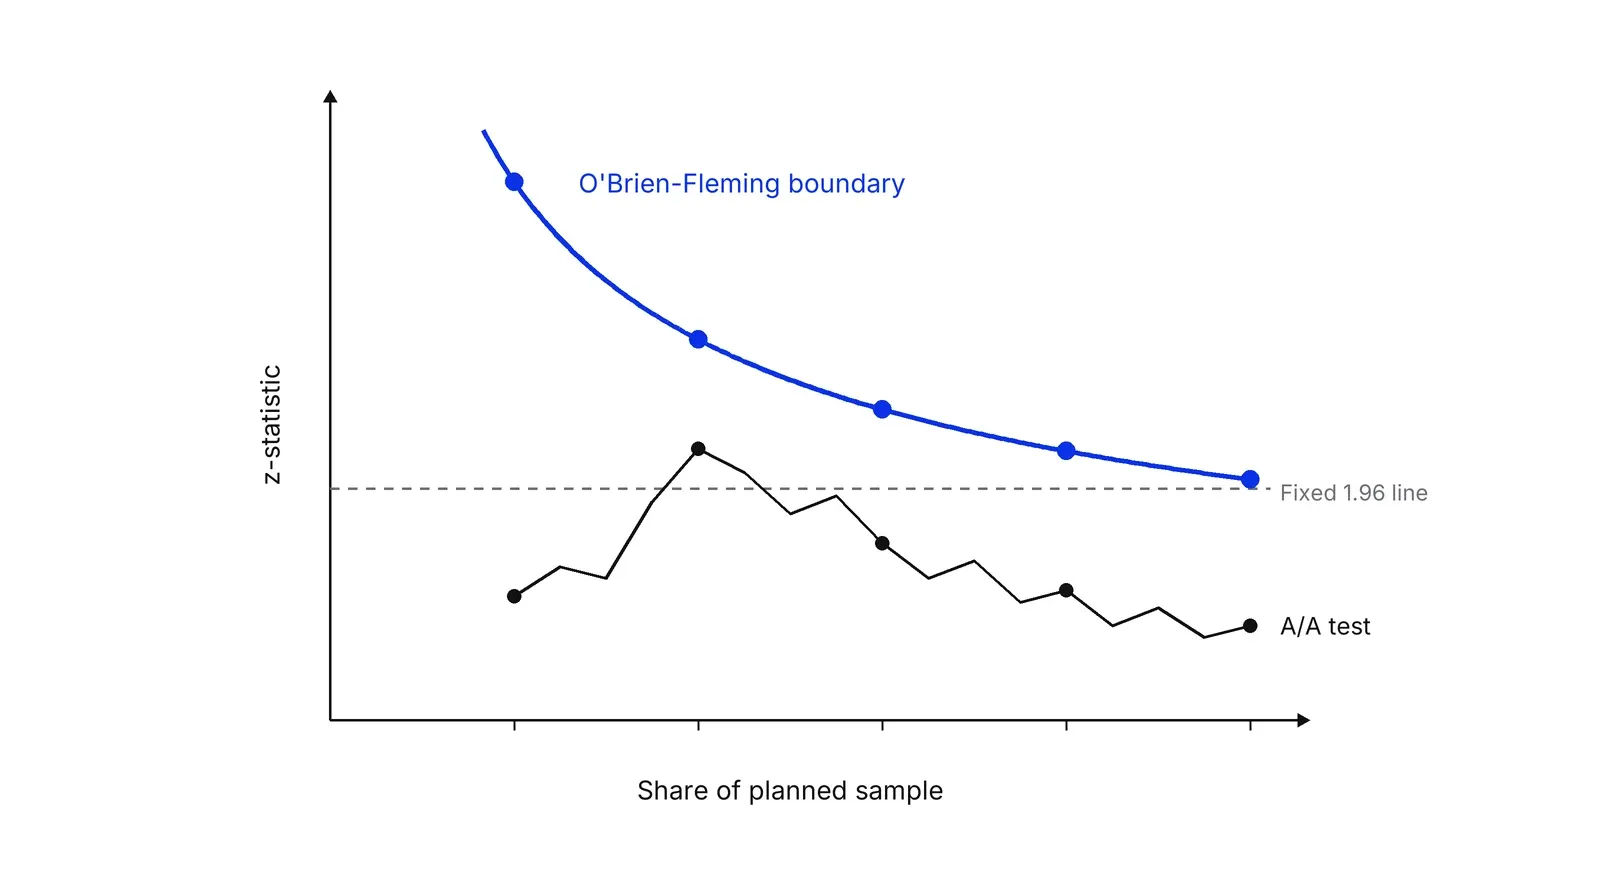
Две границы по-разному распределяют риск. Наш расчёт для пяти равномерно расставленных проверок при двусторонней значимости 5% и мощности 80%:
| Пять проверок | Пороги z по проверкам | Максимальная выборка относительно фиксированной | Ожидаемая выборка, если эффект настоящий |
|---|---|---|---|
| О’Брайен — Флеминг | 4,56; 3,23; 2,63; 2,28; 2,04 | +2,8% | 82% |
| Покок | 2,41 на каждой проверке | +22,8% | 80% |
Граница О’Брайена — Флеминга почти ничего не стоит, когда вариант ничего не меняет, поэтому большинство команд берёт её по умолчанию. В руководстве FDA 2019 года по адаптивным испытаниям сказано, что она «обычно требует очень убедительных ранних результатов», и оценено, что одна проверка на середине сокращает ожидаемую выборку примерно на 15% при мощности 90%. Мы воспроизвели эту цифру: 15,0%.
Spotify выбрал это семейство для своей платформы. В сравнении 2023 года Мортен Шульцберг и Себастиан Анкаргрен выяснили, что при 14 анализах групповой последовательный тест сохранял мощность 90%, а всегда валидные методы давали от 67% до 72%. Есть и оговорка: нужна хорошая оценка максимальной выборки, а выход за неё снова раздувает ложные победы.
Всегда валидный вывод и mSPRT
Всегда валидные p-значения остаются верными, когда бы и как часто вы ни смотрели, хоть после каждого посетителя. Рамеш Джохари, Лео Пекелис и Дэвид Уолш построили их на смешанном последовательном критерии отношения вероятностей (mSPRT), который Герберт Роббинс описал в 1970 году. Критерий спрашивает, во сколько раз данные вероятнее при наборе возможных эффектов, чем при нулевом эффекте, и останавливается, когда это отношение превысит 1/альфа. Их статья выросла из работы в Optimizely, а версия для KDD 2017 сообщает о применении метода там же.
Другие платформы пошли за ними с близкими методами. Statsig использует mSPRT. GrowthBook использует доверительные последовательности, то есть интервалы, верные при любом размере выборки, по линии Говарда, Рамдаса и коллег. Исследователи Netflix применяют к своим экспериментам регрессионные тесты, валидные в любой момент.
Платить приходится мощностью. Мы смоделировали базовую конверсию 5% при истинном приросте 10% и 2 000 пользователях на группу в день, проверка ежедневная. Тест с фиксированным горизонтом набирает мощность 80% на 16-й день. mSPRT к 16-му дню остановился с победителем только в 50% запусков, а 82% набрал лишь к 28-му дню. Зато доля ложных побед за 42 ежедневные проверки осталась на уровне 1,8%. Всегда валидные методы лучше подходят для защитных метрик и быстрых решений об отключении, чем для выжимания небольшой победы.
Байесовский A/B-тест и его ловушки
Байесовский A/B-тест соединяет априорное представление о конверсиях с данными и выдаёт апостериорное распределение: шанс, что вариант лучше, и ожидаемые потери, если его выбрать. Правило решения Криса Стаккио 2014 года останавливает тест, когда ожидаемые потери падают ниже «порога, который нам небезразличен», и утверждает, что при явном победителе тест можно закончить раньше. Так объяснять проще, чем p-значение, особенно финансовому директору.
Утверждение, что байесовские тесты защищены от подглядывания, в привычной формулировке неверно. Дэвид Робинсон смоделировал правило Стаккио в 2015 году: неверные переключения выросли с 2,5% до 11,8% при ежедневном подглядывании, потому что байесовские методы никогда не обещали контролировать эту долю. Наша симуляция правила «шанс победы выше 95%» на одинаковых вариантах дала 21% ложных победителей при ежедневных проверках против 5% при одном чтении в конце.
Статистики до сих пор спорят, насколько это важно. Джеффри Рудер утверждал, что произвольная остановка байесовцам не мешает. Рианна де Хейде и Питер Грюнвальд показали, что защита рушится при априорных распределениях по умолчанию, а их используют в большинстве инструментов. Алекс Дэн с коллегами доказали, что непрерывный мониторинг допустим только при правильных правилах остановки.
| Подход | Когда можно смотреть | Что гарантирует | Главная цена |
|---|---|---|---|
| Фиксированный горизонт | Один раз, в конце | 5% ложных побед | Нет ранней остановки |
| Групповой последовательный | На плановых проверках | 5% ложных побед | Нужна максимальная выборка |
| mSPRT, доверительные последовательности | В любой момент | 5% ложных побед | Меньше мощность на данной выборке |
| Байесовская апостериорная оценка | В любой момент | Верное описание данных при вашем априорном распределении | Ложные победы не контролируются |
Сильная сторона байесовских методов — априорное распределение. Кохави, Дэн и Вермеер оценивают, что при доле успехов 8% в поиске Airbnb и мощности 80% около 26% значимых результатов ложные. Платформа Microsoft сообщает оценки, построенные на априорных данных прошлых тестов. Если ваша программа ведёт журнал результатов, как описано на странице про программу экспериментов, у вас есть данные для такого априорного распределения. В практике Growth Lab мы записываем правило остановки в каждый HADI-цикл до запуска.
Как применять: Байесовский A/B-тест: что это и когда остановить по шагам
- Решите, нужна ли вам ранняя остановка вообще. Ранняя остановка окупается, когда настоящую победу выгодно выкатить быстро, когда плохой вариант каждый день стоит денег или когда трафик дорогой. Если ничего из этого нет, запустите тест с фиксированным горизонтом и прочитайте его один раз. Результат: «да» или «нет» последовательному плану и записанная причина.
- Выберите план под то, как вы смотрите результаты. Если проверки идут по расписанию, например раз в неделю, берите групповой последовательный план с границей О'Брайена — Флеминга или с функцией расходования альфы Лана — ДеМетса. Если вы смотрите когда придётся или не можете оценить итоговую выборку, берите всегда валидные p-значения (mSPRT) или доверительные последовательности. Результат: один названный метод.
- Задайте максимальную выборку и проверки. Отталкивайтесь от выборки для фиксированного горизонта и добавьте надбавку метода: около 2% для пяти проверок по О'Брайену — Флемингу, около 23% для пяти проверок по Пококу. Для mSPRT или доверительных последовательностей настройте параметр около выборки, на которой рассчитываете принять решение. Результат: максимальная выборка, расписание проверок и значения границ.
- Впишите правило остановки в бриф теста. Укажите, что завершает тест: пересечение границы эффективности, пересечение границы вреда по защитной метрике или достижение максимальной выборки. Добавьте, что никто не останавливает тест по нескорректированному p-значению или по байесовскому «шансу победы». Результат: правило, которое любой сможет проверить задним числом.
- Читайте тест только по скорректированным числам. На каждой проверке сравнивайте статистику с границей именно этой проверки или всегда валидное p-значение с альфой. Наивное p-значение, которое может показывать дашборд, игнорируйте. Результат: решение «остановить или продолжить», которое сохраняет запланированную долю ошибок.
- Делайте скидку на размер эффекта у раннего победителя. Тест, остановленный на ранней проверке, обычно завышает прирост: он остановился на случайном пике. Выкатывайте изменение, но выручку планируйте по меньшему числу или оставьте контрольную группу, чтобы измерить настоящий эффект. Результат: прогноз, который не держится на самом удачном моменте теста.
Примеры
Тест онбординга в финтехе с еженедельными проверками
Иллюстративный пример. Платёжное приложение тестирует более короткую проверку личности. По расчёту для фиксированного горизонта нужно 30 400 пользователей на вариант, это примерно три недели трафика. Команда смотрит результаты каждый понедельник, поэтому планирует три проверки с границей О'Брайена — Флеминга: z выше 3,47 после первой недели, 2,45 после второй и 2,00 в конце. Максимальная выборка вырастает примерно до 30 900 на вариант. Если прирост настоящий, ожидаемая выборка падает примерно до 26 000, потому что примерно в четырёх запусках из десяти тест останавливается на второй неделе.
Запись в клинику онлайн с защитной метрикой
Иллюстративный пример. Сеть стоматологических клиник тестирует новую страницу онлайн-записи. Главная метрика — завершённые записи, защитная — звонки на ресепшен. На защитной метрике команда использует всегда валидную доверительную последовательность, чтобы остановить тест в тот же момент, когда звонков станет больше, в какой бы день это ни случилось. Метрику успеха читают один раз, в запланированный конец, обычным критерием.
Байесовский дашборд, прочитанный неправильно
Иллюстративный пример. Инструмент тестирования в магазине показывает шанс обогнать контроль. Маркетолог заглядывает в него каждый день и выкатывает любой вариант, у которого шанс перевалил за 95%. В нашей симуляции одинаковых вариантов с конверсией 5% и 1 000 пользователей на группу в день такое правило выбирает ложного победителя в 21% двадцатидневных тестов, а при одном чтении на двадцатый день — в 5%. Лекарство — минимальная выборка и одна точка принятия решения либо правило по ожидаемым потерям с заранее названным порогом.
Когда применять
Последовательное тестирование нужно, когда результаты смотрят во время теста в любом случае, когда вредный вариант надо остановить быстро или когда стоит чуть увеличить максимальную выборку, чтобы выкатить настоящего победителя на неделю раньше. Байесовскую отчётность берите, если заинтересованным лицам нужны вероятность и ожидаемые потери, а не p-значение, и вы можете задать априорное распределение по прошлым экспериментам.
Когда не применять
Последовательные планы не нужны, если до конца теста никто не будет смотреть результаты: тест с фиксированным горизонтом даёт максимальную мощность на свою выборку. mSPRT не нужен, если вы знаете размер выборки и проверяете по расписанию: групповой последовательный план там мощнее. Байесовский шанс победы не годится как правило остановки, если организации нужна контролируемая доля ложных побед.
Частые ошибки
- Останавливаются по наивному p-значению. Десять равномерно расставленных проверок при обычном пороге 1,96 поднимают долю ложных побед с 5% примерно до 19%.
- Считают байесовские результаты защищёнными от подглядывания. Апостериорное распределение остаётся верным описанием данных, но то, как часто вы выкатываете вариант, который ничего не меняет, растёт с каждой проверкой.
- Выходят за запланированный максимум. Групповой последовательный план тратит всю альфу к последней проверке, а добавленные потом проверки снова раздувают ложные победы, как отмечает сравнение Spotify.
- Выдают прирост раннего победителя за прогноз. В нашей симуляции тесты, остановленные на второй из пяти проверок по О'Брайену — Флемингу, завышают истинный эффект в среднем примерно вдвое.
- Берут плоское априорное распределение и называют результат байесовским доказательством. Без априорной информации шанс победы ведёт себя почти как единица минус одностороннее p-значение и несёт те же риски.
Вопросы и ответы
Защищён ли байесовский A/B-тест от подглядывания?
Нет. Апостериорная вероятность верна при вашем априорном распределении в любой момент, но байесовские правила не обещают контролировать долю ложных побед. В симуляции Дэвида Робинсона 2015 года ежедневное подглядывание с правилом по ожидаемым потерям подняло неверные переключения с 2,5% до 11,8%. Берите минимальную выборку, одну точку принятия решения или правило, для которого доказана безопасность произвольной остановки.
Что такое mSPRT в A/B-тестировании?
Смешанный последовательный критерий отношения вероятностей сравнивает, насколько вероятны данные при диапазоне возможных эффектов и при отсутствии эффекта, и останавливается, когда это отношение превышает 1/альфа, например 20 при 5%. Джохари, Пекелис и Уолш превратили его во всегда валидные p-значения для Optimizely. Statsig тоже его использует. Смотреть результаты можно после каждого посетителя.
Что такое граница О'Брайена — Флеминга?
Это правило остановки для тестов с несколькими запланированными проверками, опубликованное Питером О'Брайеном и Томасом Флемингом в 1979 году. На ранних проверках нужны очень убедительные данные, на поздних порог почти обычный. При пяти проверках и уровне значимости 5% пороги z составляют 4,56; 3,23; 2,63; 2,28 и 2,04, а максимальная выборка вырастает всего примерно на 3%.
Сколько раз можно проверять A/B-тест?
При стандартном тесте — один раз. Каждая лишняя проверка при пороге 1,96 добавляет ложные победы: две проверки дают около 8%, пять около 14%, двадцать около 25%. При групповом последовательном плане можно смотреть столько раз, сколько запланировали, а при всегда валидных методах — так часто, как захочется.
Байесовский или частотный A/B-тест: что лучше?
Ни один не выигрывает везде. Частотные последовательные тесты гарантируют долю ложных побед при повторных проверках. Байесовский анализ даёт вероятности и ожидаемые потери, которые проще объяснить и которые могут опираться на априорные данные прошлых тестов. GrowthBook, например, предлагает оба. Выбирайте по тому, что вы должны гарантировать: долю ошибок или решение с минимальными ожидаемыми потерями.
Источники
- Abraham Wald, Sequential Tests of Statistical Hypotheses, Annals of Mathematical Statistics 16(2), 1945
- P. Armitage, C.K. McPherson, B.C. Rowe, Repeated Significance Tests on Accumulating Data, Journal of the Royal Statistical Society A 132(2), 1969
- Herbert Robbins, Statistical Methods Related to the Law of the Iterated Logarithm, Annals of Mathematical Statistics 41(5), 1970
- Stuart J. Pocock, Group sequential methods in the design and analysis of clinical trials, Biometrika 64(2), 1977
- Peter C. O'Brien, Thomas R. Fleming, A Multiple Testing Procedure for Clinical Trials, Biometrics 35(3), 1979
- K.K. Gordon Lan, David L. DeMets, Discrete sequential boundaries for clinical trials, Biometrika 70(3), 1983
- US Food and Drug Administration, Adaptive Design Clinical Trials for Drugs and Biologics, Guidance for Industry, 2019
- Evan Miller, How Not To Run an A/B Test, 2010
- Evan Miller, Simple Sequential A/B Testing, 2015
- Evan Miller, Formulas for Bayesian A/B Testing
- Ramesh Johari, Leo Pekelis, David J. Walsh, Always Valid Inference: Bringing Sequential Analysis to A/B Testing, arXiv 1512.04922
- Ramesh Johari, Pete Koomen, Leonid Pekelis, David Walsh, Always Valid Inference: Continuous Monitoring of A/B Tests, Operations Research 70(3), 2022
- Ramesh Johari, Pete Koomen, Leonid Pekelis, David Walsh, Peeking at A/B Tests: Why it matters, and what to do about it, KDD 2017
- Steven R. Howard, Aaditya Ramdas, Jon McAuliffe, Jasjeet Sekhon, Time-uniform, nonparametric, nonasymptotic confidence sequences, Annals of Statistics 49(2), 2021
- Mårten Schultzberg, Sebastian Ankargren, Choosing a Sequential Testing Framework: Comparisons and Discussions, Spotify Engineering, 2023
- Statsig documentation, Sequential testing
- GrowthBook documentation, Sequential testing
- GrowthBook documentation, Statistical details of the Bayesian engine
- Optimizely, Stats Engine: How Statistical Decisions Work
- Michael Lindon, Dae Woong Ham, Martin Tingley, Iavor Bojinov, Anytime-Valid Linear Models and Regression Adjusted Causal Inference in Randomized Experiments, arXiv 2210.08589
- Michael Lindon, Alan Malek, Anytime-Valid Inference For Multinomial Count Data, NeurIPS 2022
- David Robinson, Is Bayesian A/B Testing Immune to Peeking? Not Exactly, Variance Explained, 2015
- Chris Stucchio, Easy Evaluation of Decision Rules in Bayesian A/B testing, 2014
- Alex Deng, Jiannan Lu, Shouyuan Chen, Continuous Monitoring of A/B Tests without Pain: Optional Stopping in Bayesian Testing, arXiv 1602.05549
- Jeffrey N. Rouder, Optional stopping: No problem for Bayesians, Psychonomic Bulletin & Review 21(2), 2014
- Rianne de Heide, Peter D. Grünwald, Why optional stopping can be a problem for Bayesians, Psychonomic Bulletin & Review 28(3), 2021
- Ron Kohavi, Alex Deng, Lukas Vermeer, A/B Testing Intuition Busters: Common Misunderstandings in Online Controlled Experiments, KDD 2022
Обновлено 15 октября 2026

Маркетинговое агентство или система роста: что нужно на каждом этапе масштабирования
Агентство подходит, пока фаундер сам ведёт большую часть процессов. Когда бизнес начинает копировать себя в новые точки и регионы, нужна система, которая ставит цели, проверяет гипотезы и отвечает за результат.
Агентство медицинского маркетинга: почему работа с клиникой буксует и какую модель используем мы
Большинство агентств отвечают за клик, а за регистратуру не отвечает никто. Как мы строим маркетинг клиники в трёх горизонтах, на каких исследованиях это основано и что дал один год работы.
Тестирование рекламных каналов: почему тест затухает на третьем месяце
Большинство тестов нового рекламного канала заканчиваются не решением. Они заканчиваются, когда кончился бюджет, поменялась атрибуция или все тихо перестали открывать дашборд.