Переупаковка контента: что это и как делать
Переупаковка контента — способ превратить один содержательный материал в несколько публикаций в разных форматах и выложить копии так, чтобы в поиске не возникло проблем с дублями.
Переупаковка контента — это когда один содержательный материал (вебинар, интервью, отчёт об исследовании) перерабатывают в другие форматы: статьи, клипы, рассылки, посты, слайды. Каждую публикацию переписывают под её канал, а не вставляют как есть. Если один и тот же текст всё же появляется по нескольким адресам, нужно указать, какая копия оригинал.
- Автор
- Практика без документированного автора; идею единого источника формализовала NPR в подходе «Create Once, Publish Everywhere», без даты
- Уровень
- 201 · Инструмент
- Подходит
- стартап, малый и средний бизнес
- Время на внедрение
- полдня на то, чтобы разложить один источник по календарю; две-четыре недели на публикацию и разбор результатов
- Что понадобится
- один источник с настоящим содержанием: записанное выступление, интервью, собственные данные или длинная статья · доступ к шаблонам страниц, чтобы ставить canonical и noindex · расшифровка из YouTube Studio или похожего сервиса, вычитанная человеком · один редактор, который сверяет каждую производную публикацию с источником
Переупаковка контента — это когда один содержательный материал перерабатывают в несколько других, под разные форматы и каналы. Из 60-минутного вебинара получаются статья, три клипа и выпуск рассылки. У приёма нет документированного автора. Ближайшая формальная идея — «Create Once, Publish Everywhere» («создай один раз, публикуй везде»), на которой NPR построила архитектуру своего контента. По описанию Зака Бранда из NPR, материал делают один раз в гибком виде, а через API он попадает в приложения NPR для iPhone и Android, мобильный сайт, аудиоплеер и сайты партнёров. Маркетологи берут ту же логику без программирования: дорого стоит источник, а каждую копию переписывают под место, где её будут читать.
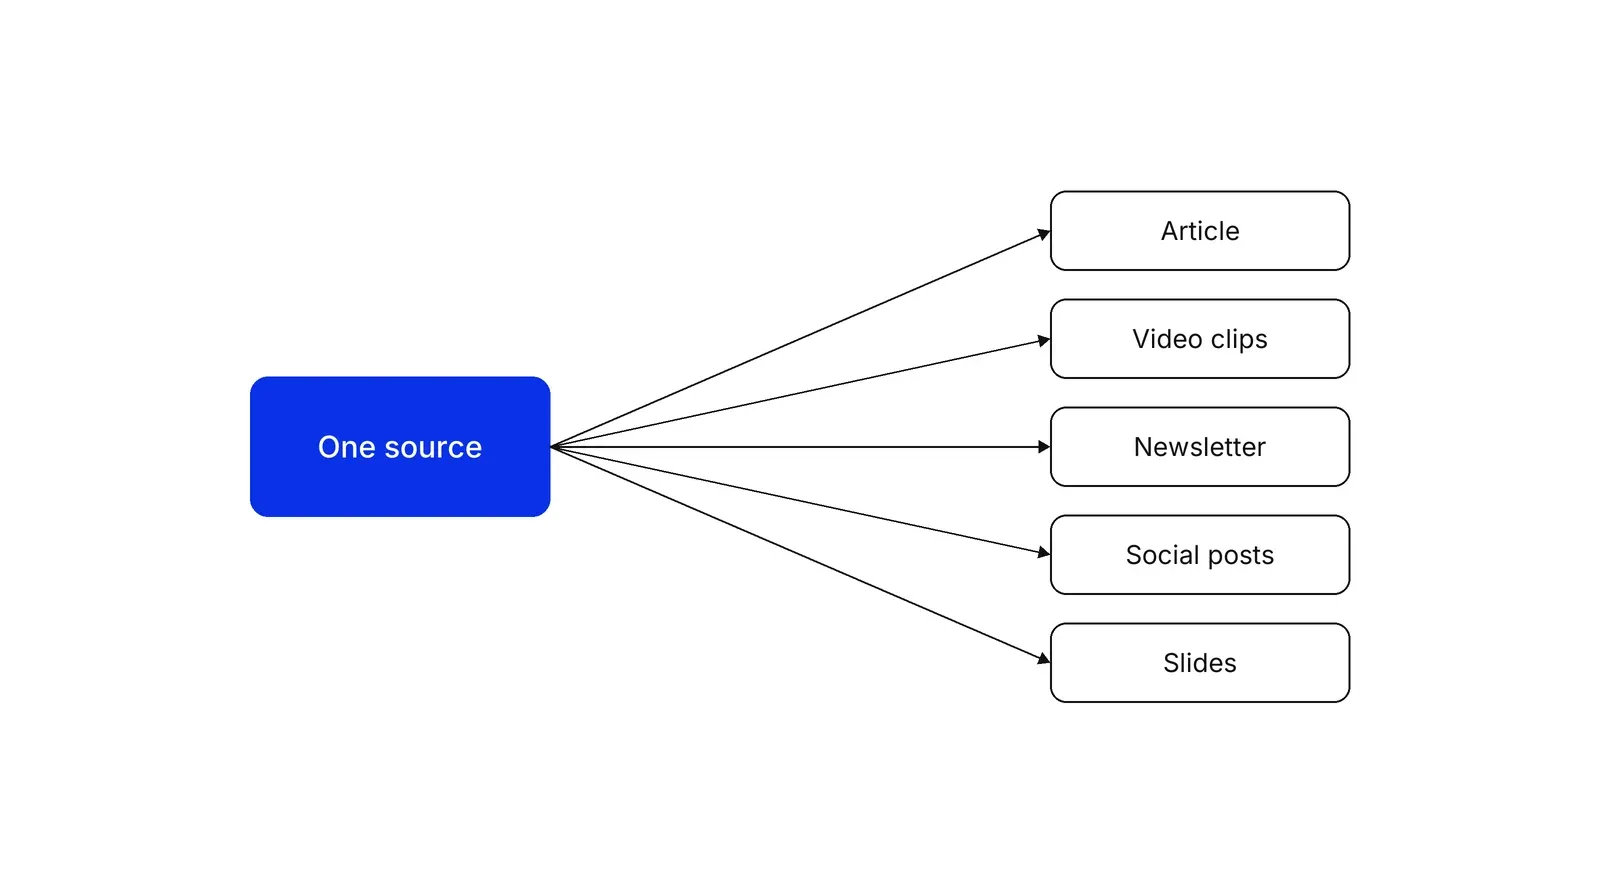
Почему из одного источника выходит много публикаций
В хорошем источнике много отдельных идей, а люди встречают контент по-разному. В 1997 году Якоб Нильсен сообщил, что 79% участников тестов всегда просматривали новые страницы по диагонали и 16% читали слово за словом. В той же статье пять версий одного сайта несли одинаковую информацию разными словами, и краткая, удобная для беглого чтения и объективная версия оказалась по юзабилити на 124% лучше контрольной. В исследовании 2006 года с айтрекингом на 232 пользователях он описал F-образный шаблон чтения: больше всего внимания читатели уделяют первым строкам. Поэтому производную публикацию стоит начинать с вывода, а не делать урезанной копией длинного текста.
Повторение идеи во времени тоже помогает её запомнить. В метаанализе 97 исследований вербального обучения, опубликованном в 2003 году в Journal of Consumer Research, Крис Янишевски, Хейден Ноэль и Алан Сойер (Chris Janiszewski, Hayden Noel, Alan Sawyer) изучали, что даёт разнесение повторов рекламы во времени. Авторы предлагают чередовать вовлекающие носители, например телевизионные ролики, с менее вовлекающими вроде рекламных щитов. Николас Сепеда, Гарольд Пашлер, Эдвард Вул, Джон Уикстед и Даг Рорер (Nicholas Cepeda, Harold Pashler, Edward Vul, John Wixted, Doug Rohrer) обобщили 839 оценок из 317 экспериментов в 184 статьях и обнаружили: чем позже человеку понадобится вспомнить идею, тем больше должен быть оптимальный промежуток между показами. Это лабораторные исследования на списках слов, а не на контент-маркетинге. Считайте их доводом в пользу разнесения выходов, а не готовой формулой.
Что делает производную публикацию достойной выхода
В рекомендациях Google Search о контенте для людей спрашивается, даёт ли страница оригинальную информацию, и сказано, что ссылки на другие источники не заменяют собственной работы. Там же спрашивают, не меняете ли вы даты, чтобы выглядеть свежее, без существенных изменений.
У каждого формата свои документированные правила:
| Формат | Что документирует платформа |
|---|---|
| Видео на вашем сайте | Отдельная страница просмотра со своим заголовком, описанием и разметкой VideoObject |
| YouTube Studio | Файлы субтитров или автосинхронизация расшифровки, которую YouTube не рекомендует для видео длиннее 1 часа; автоматические субтитры только на языке по умолчанию |
| Apple Podcasts Connect | Расшифровки VTT или SRT на 11 языках в iOS 17.4 и новее; автоматические расшифровки для выпусков короче 10 часов |
| Изображения | Описательный alt-текст и соседний текст, подходящий к картинке, — для Google Картинок |
| Переводы | Полные страницы, связанные через hreflang, а не переведённая обвязка вокруг непереведённого текста |
| Копии, написанные ИИ | Ручная проверка фактов перед публикацией; массовые страницы без добавленной ценности рискуют попасть под политику против масштабного злоупотребления контентом |
Вредят ли дубли при повторной публикации
Не как наказание. На странице Google Search Central об объединении дублирующихся URL дубли описаны как задача группировки: Google Search собирает почти одинаковые страницы в кластер и показывает ту, которую считает лучшей, а сайту, скорее всего, ничего не грозит и без указания предпочтения. Риск в том, что Google Search покажет копию, которую вы не выбирали.
Для копий на вашем домене та же страница расставляет три сигнала по силе: редирект сильный, ссылка rel="canonical" сильная, запись в карте сайта слабая. Canonical в Google Search Central называют подсказкой, а не правилом, поэтому Google вправе выбрать другой адрес.
С синдикацией иначе. В руководстве по устранению неполадок сказано, что canonical не рекомендуется для партнёров по синдикации, а самое действенное решение — чтобы партнёры закрыли страницу от индексации. На практике это метатег noindex на копии у партнёра, прописанный в договоре. Google Search увидит его, только если сможет просканировать страницу, поэтому адрес, закрытый в robots.txt, прячет и свой noindex. Для PDF используйте заголовок X-Robots-Tag.
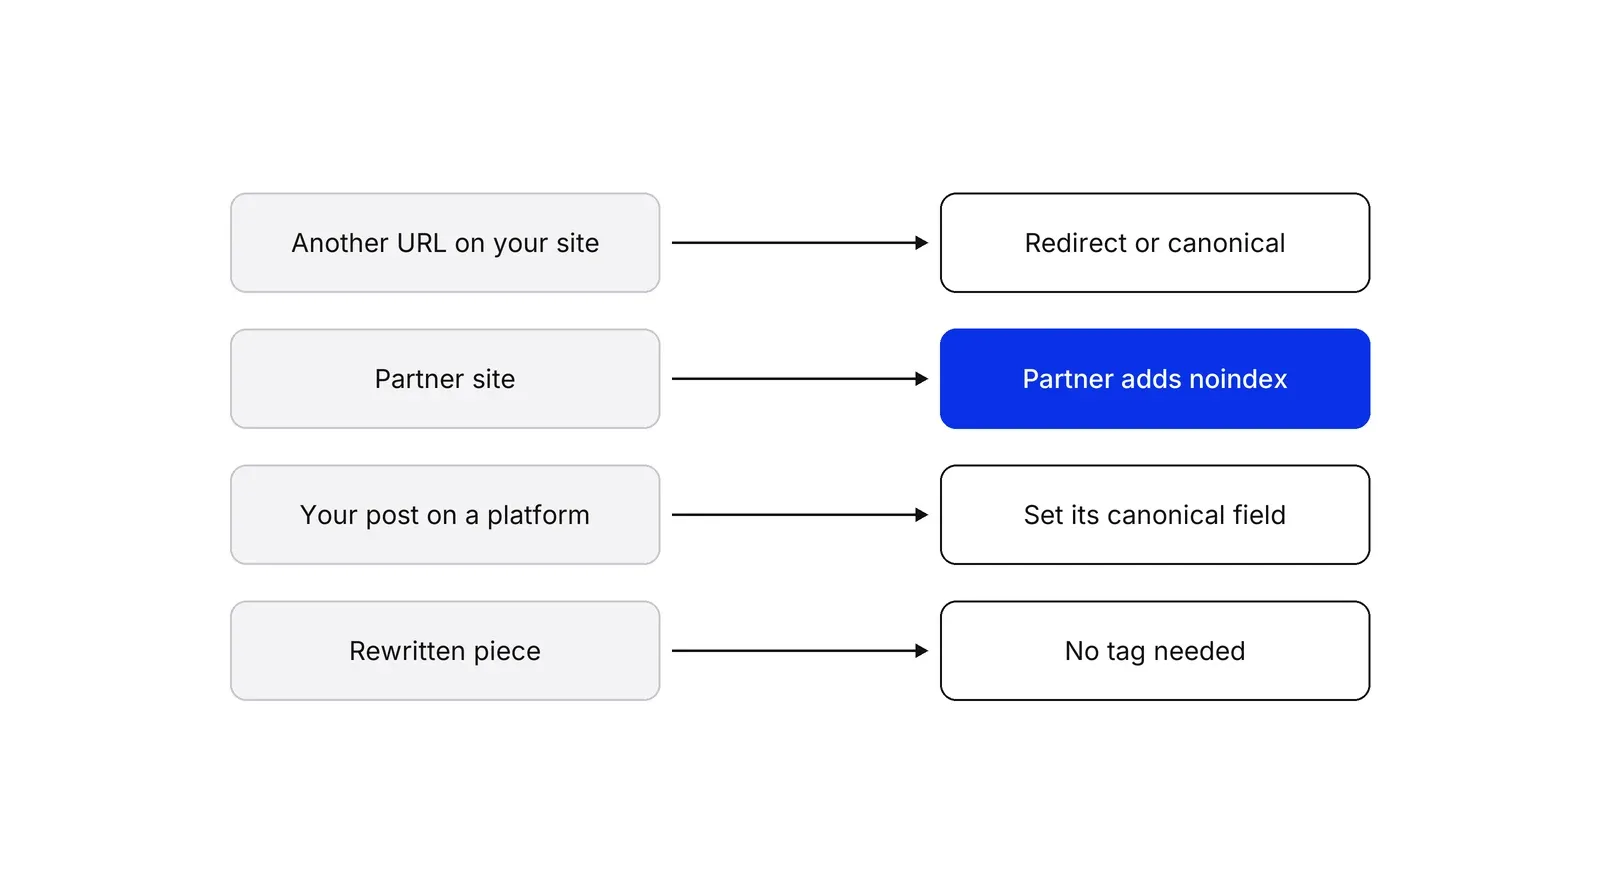
В DEV Community пост можно связать с оригиналом через поле canonical_url в начале файла. Считайте и его подсказкой.
| Ситуация | На что указывает документация Google |
|---|---|
| Один текст по двум адресам вашего сайта | Редирект или rel="canonical" на копии |
| Партнёр по синдикации публикует ваш текст | Попросить партнёра закрыть страницу от индексации |
| Ваш контент размещён где-то без разрешения | Связаться с хостинг-провайдером или подать жалобу по DMCA |
| Новая публикация другими словами и в новом формате | Отмечать нечего: это отдельная страница |
В Google Search Console инструмент проверки URL показывает заданный вами canonical рядом с тем, который выбрал Google. В отчёте об индексировании страниц Search Console адреса с таким расхождением идут под статусом «Duplicate, Google chose different canonical than user» (то есть Google выбрал другой canonical, чем указал пользователь).
Как выглядит четырёхнедельный выпуск
В этом иллюстративном календаре взят 45-минутный вебинар о платежах из первого примера, а главным списком в нём служат пять причин задержек.
| Неделя | Публикация | Канал | Как отмечена копия |
|---|---|---|---|
| 1 | Длинная статья по расшифровке | Сайт компании | Оригинал, canonical на себя |
| 1 | Страница с видео и субтитрами | YouTube и сайт компании | Отдельная страница просмотра, свой заголовок |
| 2 | Три клипа по 60 секунд, по одному на причину задержки | LinkedIn и YouTube | Новый формат, без метки |
| 3 | Чек-лист из 5 причин | Email-рассылка | Новые формулировки, без метки |
| 4 | Отредактированная статья для партнёра | Отраслевое издание | Партнёр ставит noindex |
А как быть с чужим контентом
Спам-политики Google Search называют два вида скрапинга: переиздание чужого контента без оригинальной ценности и копирование с мелкими правками. Переупаковка касается только вашего материала.
Рекомендации Google Search по дате публикации просят показывать видимую дату, совпадающую с datePublished или dateModified в разметке Article, BlogPosting или VideoObject.
Ссылайтесь из каждой производной публикации на оригинал обычной ссылкой <a href> с понятным анкором (ссылки, которые можно сканировать) и давайте каждой странице собственный заголовок (руководство по SEO для начинающих). Подробнее — в материалах про техническое SEO, про то, как источник зарабатывает доверие, — про E-E-A-T, а про то, какая аудитория какую публикацию увидит, — про холодную, тёплую и горячую аудиторию. План Growth Lab начинается с материалов, которые у команды уже есть, и раскладывает их по календарю выпусков.
Как применять: Переупаковка контента: что это и как делать по шагам
- Выберите источник, который стоит повторять. Берите материал с оригинальной начинкой: 45-минутный вебинар с практиком, ваши собственные цифры или длинную статью, которая уже приводит читателей. Результат: один источник и одна фраза, в которой сказано, что он утверждает.
- Достаньте из него строительные блоки. Выпишите отдельные тезисы, цифры, цитаты, истории и шаги — у каждого пометьте таймкод или страницу. Результат: от 10 до 20 блоков, каждый понятен сам по себе.
- Подберите блокам форматы и аудитории. Для каждого блока выберите формат и канал: холодной аудитории подойдёт описание проблемы, тёплой — доказательства. Результат: таблица «блок, формат, канал и одно действие, которого вы ждёте».
- Перепишите под каждый формат. Пишите каждую публикацию из своего блока, начиная с вывода, со своим заголовком, началом и концовкой. Источник не вставляйте. Результат: черновики, понятные без первоисточника.
- Решите, как отмечать копии, до публикации. Для каждого места, где один текст окажется дважды, выберите одно правило: редирект, canonical, noindex у партнёра или никакой метки, потому что формулировки новые. Результат: по строке на каждую копию, написанные до запуска.
- Растяните выпуск и проверьте индексацию. Выпускайте материалы четыре недели. Потом проверьте важные адреса в Google Search Console и сравните объявленный canonical с тем, который выбрал Google. Результат: календарь и список адресов, где Google с вами не согласен.
Примеры
Компания, которая проводит трансграничные платежи
Иллюстративный пример. Финансовый директор проводит 45-минутный вебинар о задержках расчётов для импортёров. Расшифровка превращается в длинную статью на сайте компании — это оригинал. Три клипа уходят в LinkedIn и YouTube, чек-лист из пяти причин задержек попадает в рассылку, а отраслевое издание публикует статью с noindex.
Дерматологическая клиника
Иллюстративный пример. Врач записывает 20-минутное выступление о том, когда изменившуюся родинку нужно показать специалисту. Клиника выкладывает страницу с видео и субтитрами, письменное руководство и короткие вопросы и ответы. Врач проверяет каждую производную публикацию, и ни одна не делает медицинских утверждений сильнее, чем источник.
Когда применять
Применяйте, когда у вас уже есть один сильный материал, у команды нет времени на десять новых, а аудитория сидит в нескольких каналах. Лучше всего работает с выступлениями, интервью и собственными данными.
Когда не применять
Не берите, если источник слабый или устарел: копии только размножат слабость. Это и не разрешение копировать чужие страницы: по спам-политике Google Search такое считается скрапингом.
Частые ошибки
- Вставляют один и тот же текст в LinkedIn, рассылку и сайт партнёра вместо того, чтобы переписать его под каждое место.
- Ставят canonical на копию у партнёра по синдикации и считают вопрос закрытым, хотя Google Search Central называет его подсказкой и не рекомендует для партнёров.
- Закрывают дубль в robots.txt и добавляют на него noindex, так что Google этот noindex никогда не видит.
- Меняют дату на переписанной старой статье, чтобы она казалась свежей, хотя содержание по сути то же.
- Перерабатывают только самую посещаемую статью и никогда — выступления и массивы данных, которые так и не превратились в текст.
Вопросы и ответы
Вредит ли SEO повторная публикация одного и того же контента?
Google Search Central считает дубли вопросом объединения, а не наказанием: Google Search группирует похожие страницы и показывает одну. Риск в том, что он выберет копию, которую вы не хотели. Отметьте оригинал редиректом, canonical или noindex у партнёра и дайте каждой копии что-то своё.
Нужно ли ставить canonical на синдицированный контент?
В руководстве Google Search Central по устранению неполадок сказано, что canonical не рекомендуется для защиты от дублей у партнёров по синдикации, а самое действенное решение — чтобы партнёры закрыли страницу от индексации. Внутри вашего сайта canonical — сильный сигнал. Для копий у партнёров пропишите noindex в договоре.
Что делать, если копия обгоняет оригинал в выдаче?
Откройте инструмент проверки URL в Google Search Console и сравните canonical, заданный вами, с тем, который выбрал Google. Если чужой сайт разместил ваш материал без разрешения, Google Search Central советует написать хостинг-провайдеру сайта или подать жалобу по DMCA. Для лицензированной копии у партнёра просите noindex.
Как лучше всего переупаковать вебинар?
Начните с расшифровки и разберите её на тезисы, цифры и истории. Выложите страницу с видео и субтитрами, статью под отдельным заголовком, выпуск рассылки и три-пять клипов для LinkedIn и YouTube. Каждую часть перепишите под свой канал и дайте ссылку на оригинал.
Сколько публикаций должно получиться из одного источника?
Ни одно исследование не называет число. Посчитайте отдельные идеи в источнике и сделайте по одной публикации на идею для каждого канала, где сидит ваша аудитория. Метаанализ 97 исследований эффекта разнесения, который Янишевски, Ноэль и Сойер опубликовали в 2003 году, подсказывает растягивать выход во времени, так что планируйте четыре недели, а не один день.
Источники
- Google Search Central, Consolidate duplicate URLs with canonicalization
- Google Search Central, How Google picks a canonical URL
- Google Search Central, Troubleshoot canonicalization issues
- Google Search Central, Spam policies for Google web search
- Google Search Central, Robots meta tag and X-Robots-Tag specifications (noindex)
- Google Search Central, Creating helpful, reliable, people-first content
- Google Search Central, Influence your byline date in Google Search
- Google Search Central, Video SEO guidance
- Google Search Central, Google Search's guidance on using generative AI content
- Google Search Central, Managing multi-regional and multilingual sites
- Google Search Central, Image SEO guidance
- Google Search Central, SEO starter guide
- Google Search Central, Make your links crawlable
- Google Search Central, Google Search Essentials
- Google Search Console Help, Page indexing report
- Google Search Console Help, URL Inspection tool
- Jakob Nielsen, Nielsen Norman Group, How users read on the web, 30 September 1997
- Jakob Nielsen, Nielsen Norman Group, F-shaped pattern for reading web content, 16 April 2006
- Chris Janiszewski, Hayden Noel, Alan Sawyer, A Meta-analysis of the Spacing Effect in Verbal Learning, Journal of Consumer Research 30(1), 2003 (IDEAS/RePEc)
- Nicholas Cepeda and others, Distributed practice in verbal recall tasks: a review and quantitative synthesis, Psychological Bulletin 132(3), 2006
- Zach Brand, NPR Senior Director of Technology and Strategy, NPR API: Create Once, Publish Everywhere (slides)
- YouTube Help, Add subtitles and captions
- Apple Podcasts for Creators, Transcripts on Apple Podcasts
- DEV Community, Editor guide
Обновлено 15 октября 2026

Маркетинг в финтехе: где реклама упирается в комплаенс, KYC и лицензии
Агентство может собрать кампании. Но проверку рекламных обещаний, отвал на KYC и лицензионные правила разных рынков оно не контролирует, а именно они решают, станет ли лид клиентом.
Маркетинговое агентство или система роста: что нужно на каждом этапе масштабирования
Агентство подходит, пока фаундер сам ведёт большую часть процессов. Когда бизнес начинает копировать себя в новые точки и регионы, нужна система, которая ставит цели, проверяет гипотезы и отвечает за результат.
Агентство медицинского маркетинга: почему работа с клиникой буксует и какую модель используем мы
Большинство агентств отвечают за клик, а за регистратуру не отвечает никто. Как мы строим маркетинг клиники в трёх горизонтах, на каких исследованиях это основано и что дал один год работы.