Измерение эффективности маркетинга: методы и система
Единая система измерения маркетинга запускает моделирование маркетингового микса, атрибуцию и эксперименты на инкрементальность как одно целое: у каждого метода своя задача, а эксперименты поправляют два других.
Измерение эффективности маркетинга по единой системе — это три метода в связке. Моделирование маркетингового микса (MMM) делит бюджет между каналами, атрибуция помогает принимать ежедневные решения по кампаниям, а эксперименты на инкрементальность дают причинную проверку. Результаты экспериментов калибруют два других метода: например, задают приоры в MMM или множители для атрибутированной отдачи. Инструменты остаются раздельными, а цель одна — решения, которые не противоречат друг другу.
- Автор
- Практика без единого автора; изложена в плейбуке Google Modern Measurement и в функциях калибровки Meridian, Robyn и PyMC-Marketing, Единой даты нет; плейбук Google, издание 2024 года
- Уровень
- 401 · Экспертный
- Подходит
- корпорация
- Время на внедрение
- неделя на распределение прав на решения и сопоставление чисел; от шести до двенадцати месяцев на первый цикл калибровки
- Что понадобится
- отчёт по атрибуции, по которому вы уже принимаете решения по кампаниям · хотя бы один эксперимент на инкрементальность, лучше геоэксперимент, на крупном канале · два года недельных данных по каждому каналу, если вы собираетесь строить или покупать MMM · аналитик, который отвечает за сопоставление, и владелец бюджета, готовый действовать по его итогам
Единая система измерения — это три метода, которые работают как одно целое. Моделирование маркетингового микса (MMM) оценивает вклад каждого канала по недельным итогам. Атрибуция, чаще всего многоканальная (MTA), делит заслугу за отслеженные конверсии между рекламой, с которой человек взаимодействовал. Эксперименты на инкрементальность сравнивают людей или регионы, видевших рекламу, с теми, кто её не видел. Каждому методу достаются решения, с которыми он справляется лучше всего, а эксперименты исправляют два других.
У подхода нет автора. В плейбуке Google Modern Measurement 2024 года исходная мысль уложена в одну фразу: «Ни у одного инструмента больше нет всех ответов». Google называет связку modern measurement, вендоры говорят об унифицированном измерении или триангуляции. Пользуются подходом крупные рекламодатели, у которых финансисты и маркетологи называют разную отдачу на один и тот же бюджет.
Почему одного метода мало
У каждого метода есть слепая зона, которую видят остальные. Атрибуция видит только то, что отслеживает. Атрибуция на основе данных в Google работает со взаимодействиями с рекламой Google, а на iOS начиная с версии 14.5 Apple требует разрешения, прежде чем приложение сможет отслеживать людей в чужих приложениях для измерения рекламы. К тому же атрибуция засчитывает и продажи, которые случились бы и без рекламы.
MMM видит все каналы, в том числе офлайн, но учится на корреляциях в прошлых расходах и, как сказано в плейбуке Google, требует не меньше двух лет истории. Исследователи Google Дэвид Чан и Майк Перри ещё в 2017 году писали, как трудно получить достоверные ответы от таких моделей. Эксперименты показывают причинность, но охватывают узкий участок и дают шумные оценки: Льюис и Рао нашли, что в 25 крупных тестах с расходами 2,8 млн долларов медианный доверительный интервал отдачи шире 100 процентных пунктов. Страница про моделирование маркетингового микса сравнивает три метода в таблице, а здесь речь о том, как запускать их вместе.
Триангуляция: читайте три числа как границы
Триангуляция — это сравнение оценок, ошибки которых идут из разных мест. Эпидемиологи Лоулор, Тиллинг и Дэйви Смит определяют её как сочетание подходов с разными и в основном не связанными источниками смещения. Если методы, которые ошибаются по-разному, дают один ответ, он, скорее всего, верный.
Плейбук Google превращает это в правило для цифровых каналов, где считают клики. Атрибуция даёт щедрый взгляд, верхнюю границу. Эксперимент на инкрементальность даёт самый осторожный взгляд, нижнюю границу. Оценка MMM должна лежать между ними.
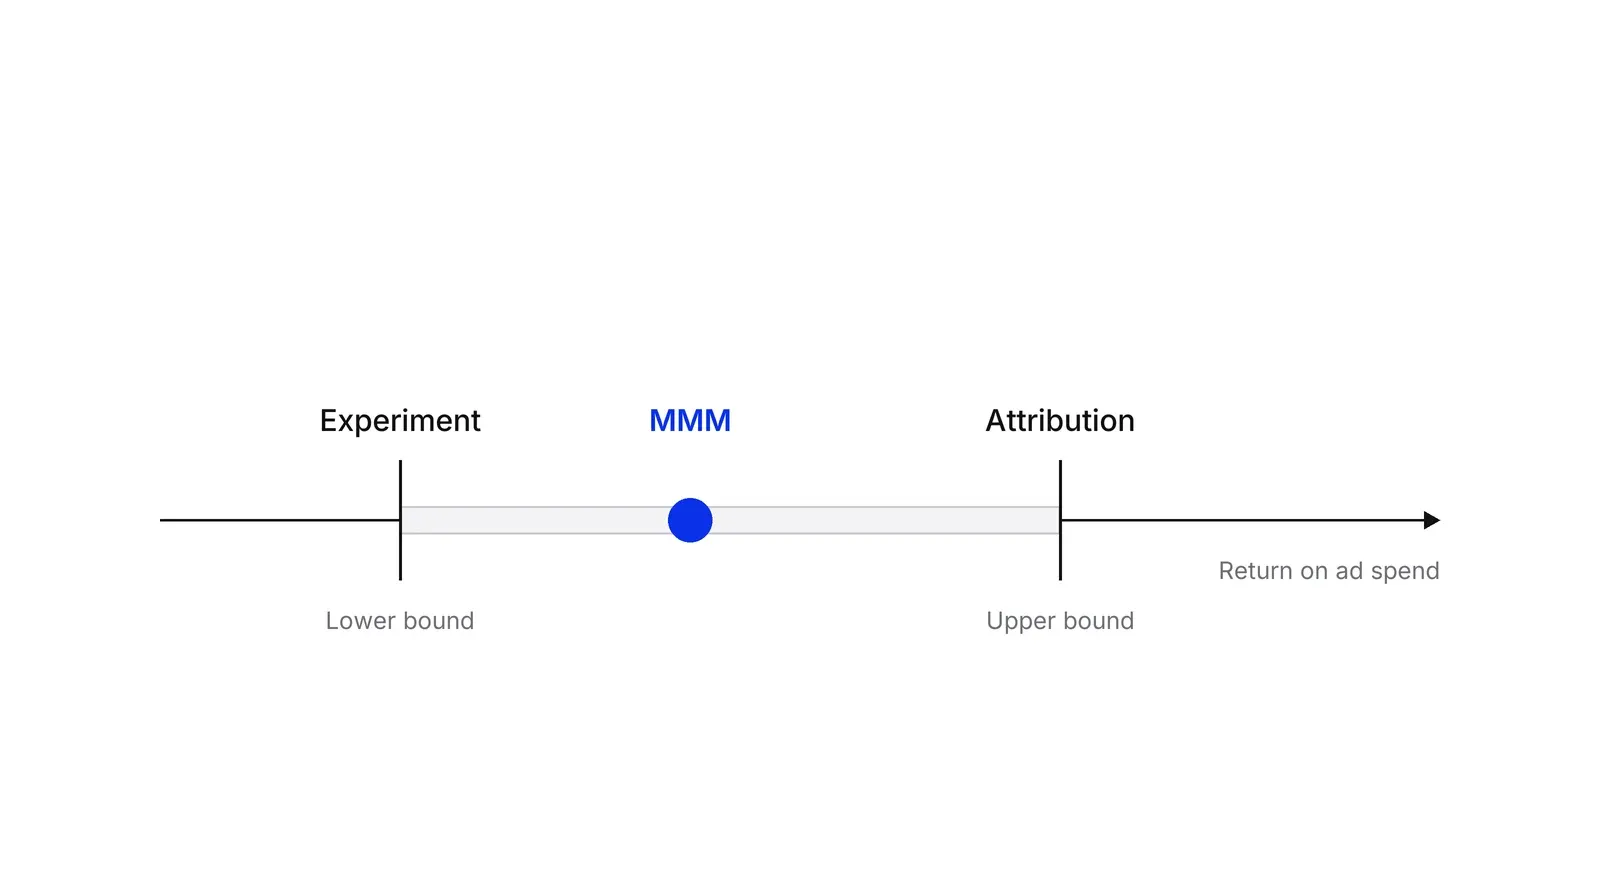
Если число выходит за диапазон, что-то настроено неверно: отслеживание конверсий, допущения модели или сам тест. Та же логика отсеивает версии модели. Если версия MMM утверждает, что инкрементальная стоимость привлечения в канале с кликами ниже, чем атрибутированная, плейбук советует отбросить её: инкрементальная цифра не должна быть лучше щедрой.
Кто что решает
Единая система начинается с прав на решения: какой инструмент закрывает какой вопрос. Ритм и роли из плейбука умещаются в одну таблицу.
| Решение | Главный инструмент | Типичный ритм | Чем проверяют |
|---|---|---|---|
| Распределение бюджета между каналами | MMM | От одного до четырёх раз в год | Эксперименты на самых крупных каналах |
| Ставки, креативы, аудитории внутри канала | Атрибуция | Ежедневно | Калибровочные множители из экспериментов |
| Приводит ли этот канал к продажам вообще | Эксперимент | Раз в квартал | Повторные тесты каждые три–шесть месяцев |
Плейбук предупреждает: гнаться за одним сводным числом не стоит. Если заставлять модель, атрибуцию и эксперименты сходиться, приходится вводить жёсткие допущения, и каждая цифра становится менее точной. Там же отмечено, что два инструмента, которыми пользуются как надо, лучше трёх, у которых нет ясной задачи.
Калибровка атрибуции экспериментами
Калибровочный множитель переводит атрибутированную отдачу в оценку инкрементальной. Вы делите отдачу, измеренную в эксперименте, на атрибутированную отдачу тех же кампаний за те же недели и применяете это отношение до следующего теста. В разобранном примере Google канал с атрибутированной отдачей 5 и экспериментальной 3,5 получает множитель 0,7. Второй канал с 5,5 по атрибуции и 3 по измерению получает 0,54 и оказывается позади первого, хотя по атрибуции выглядел выше.
Плейбук добавляет ограничители. Предпочитайте геоэксперименты, например дизайн Вейвера и Кёлера из Google или GeoLift от Meta (принадлежит компании Meta, признанной экстремистской организацией и запрещённой в России), и берите один дизайн для всех каналов, чтобы результаты сравнивались. Если множитель выглядит крайним, сдвигайтесь лишь частично и перепроверьте, прежде чем применять его целиком. Целевые ставки меняйте не больше чем на 20% за раз, а множители обновляйте раз в три–шесть месяцев. Исходные данные дают платформенные инструменты: Google Conversion Lift и исследования эффекта рекламы (lift studies) на платформе Meta, там, где к ним есть доступ.
Калибровка MMM экспериментами
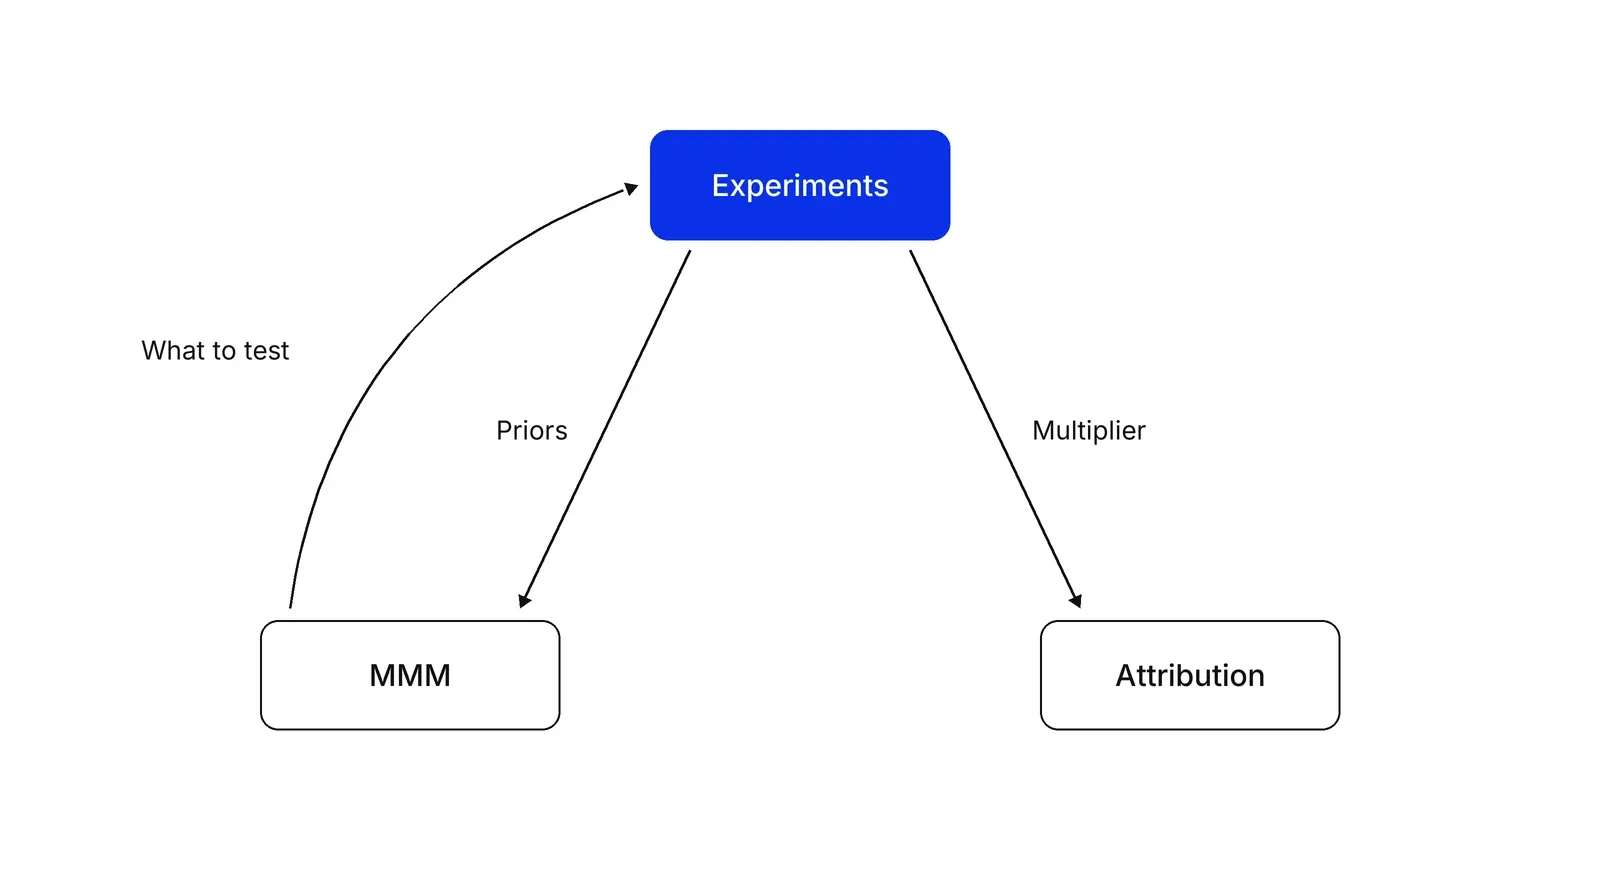
Эксперименты исправляют то, чему модель не может научиться на истории, например когда расходы двух каналов всегда росли одновременно. Meridian, Robyn и PyMC-Marketing, три главных open-source-инструмента, принимают результаты экспериментов в разном виде.
| Инструмент | Как эксперимент попадает в модель | На что смотреть |
|---|---|---|
| Google Meridian | Как приор на ROI канала | Поправка на уровень расходов, длительность теста и его давность |
| Meta Robyn | Как ошибка калибровки, которую минимизирует модель | Взвешивается вместе с точностью подгонки и штрафом за долю расходов |
| PyMC-Marketing | Как дополнительное наблюдение на кривой насыщения | Нужны расходы до теста, изменение расходов, прирост и его ошибка |
В документации Meridian эксперименты на инкрементальность названы, пожалуй, самой надёжной основой для приоров, но тут же сказано, что фиксированной формулы перевода одного в другое нет. Конструктор калибровки расширяет приор для старых тестов, используя период полураспада 52 недели, и для тестов, проведённых при расходах, не похожих на обычные для канала. Идею объясняет статья Google 2024 года Чжана и соавторов: модель переписывают так, чтобы отдача на рекламные расходы сама стала параметром, и задают её приор по эксперименту.
Robyn считает эксперименты эталоном и оптимизирует сразу три ошибки: подгонку к продажам, бизнес-ошибку DECOMP.RSSD и ошибку калибровки MAPE.LIFT. По умолчанию веса у всех трёх равны: 1, 1 и 1. В статье о Robyn объяснено, что DECOMP.RSSD измеряет расстояние между долей эффекта каждого канала и долей его расходов. Это предпочтение результатов, близких к существующему положению дел, поэтому относитесь к нему как к суждению, которое тест может перечеркнуть. PyMC-Marketing читает каждый lift-тест как две точки на кривой отклика канала.
В плейбуке Google есть рабочий порог. Если обновлённая модель и сопоставимый эксперимент расходятся меньше чем примерно на 10%, действий не требуется. Больше 10% — калибруйте. Для сдвигов бюджета по модели плейбук советует менять не больше 20% расходов канала за раз и проверять тестом любое изменение больше 10%. Старые эксперименты тоже стоит хранить: команда Uber обнаружила, что модель, обученная на всех прошлых тестах, точнее предсказала отложенный эксперимент, чем модель только по последнему.
Где единая система ломается
Обычный сбой — ложная точность. У экспериментов широкие интервалы, поэтому сравнивайте интервалы, а не точечные оценки. Обходные пути на наблюдательных данных тесты не заменяют: в 663 экспериментах на Facebook ошибки неэкспериментальных оценок были больше, чем измеряемый прирост. Как спланировать тест, который выдержит проверку, и посчитать его размер, написано на странице про тесты на инкрементальность.
Второй сбой связан с календарём. Эксперименты идут по одному каналу, а бюджет утверждают сразу по всем. Отметьте даты, когда принимаются бюджетные решения, и планируйте тесты так, чтобы они заканчивались раньше. В Growth Lab от Pushers такой календарь ведут как циклы HADI: одна гипотеза, один тест за раз.
Как применять: Измерение эффективности маркетинга: методы и система по шагам
- Распределите права на решения. Запишите, какой инструмент решает какой вопрос. Типичное разделение: MMM раз или два в год распределяет бюджет между каналами, атрибуция перекладывает деньги между кампаниями, аудиториями и креативами внутри канала, а эксперименты решают споры о том, работает ли канал вообще. Результат: таблица на одну страницу, которая прекращает споры о том, чьё число главнее.
- Поставьте числа рядом. По каждому крупному каналу выпишите отдачу по атрибуции, отдачу по эксперименту (если он был) и отдачу по MMM за один и тот же период и по одному и тому же результату. Для каналов, где считают клики, проверьте, что оценка MMM лежит между экспериментом и атрибуцией. Результат: список каналов, где инструменты согласны, и короткий список тех, где они расходятся.
- Запланируйте эксперименты там, где сомнений больше всего. Начните с каналов, у которых самый широкий диапазон оценки MMM, с тех, где инструменты расходятся, и с брендового поиска, который модели оценивают плохо. Во всех каналах используйте один и тот же дизайн, лучше всего геоэксперименты, чтобы результаты можно было сравнивать. Результат: календарь тестов на ближайшие четыре квартала.
- Откалибруйте атрибуцию. Поделите отдачу, которую измерил каждый эксперимент, на атрибутированную отдачу тех же кампаний за те же недели. Применяйте этот множитель к отчётам по атрибуции между тестами и пересматривайте его раз в три–шесть месяцев. Результат: ежедневные отчёты, которые говорят на языке инкрементальной отдачи.
- Откалибруйте MMM. Передайте каждый эксперимент модели в том виде, который принимает инструмент: приоры по ROI в Meridian, калибровочный вход в Robyn, строки lift-тестов в PyMC-Marketing. Если обновлённая модель и новый эксперимент расходятся больше чем примерно на 10%, калибруйте ещё раз. Результат: модель, в которой оценки каналов опираются на измеренные эффекты.
- Двигайте бюджет шагами и тестируйте заново. Меняйте расходы на канал небольшими шагами по совету модели, а более крупные сдвиги подтверждайте экспериментом. Результат: бюджет, который меняется измеренными шагами, и повод для следующего теста.
Примеры
Пример Google с калибровочными множителями
В плейбуке Google за 2024 год показаны три канала: атрибутированная отдача 5, 5,5 и 8, а отдача по геоэкспериментам 3,5, 3 и 12. Множители получаются 0,7, 0,54 и 1,5. По атрибуции канал 2 выглядел лучше канала 1, а после калибровки впереди канал 1. Канал 3, которому атрибуция недодавала заслуг, оказывается сильнейшим из трёх.
Проверка старых и новых экспериментов в Uber
Три исследователя Uber построили байесовскую модель, которая принимает эксперименты как приоры. В одной проверке самый свежий эксперимент по платному каналу отложили как эталон: по атрибуции он равнялся 1 147 (в статье единицы не указаны). Модель, которая использовала только предыдущий эксперимент, оценила канал в 1 311. Модель, которая использовала все более ранние эксперименты, дала 1 240, ближе к эталону. Авторы делают вывод, что старые тесты по-прежнему полезны.
Платёжное приложение сводит три числа
Иллюстративный пример, реальная компания не подразумевается. Платёжное приложение видит стоимость пополненного счёта в таргетированной рекламе в соцсетях: 4 000 ₽ по атрибуции, оценку MMM 7 000 ₽ и результат геоэксперимента 9 500 ₽ за один и тот же квартал. Оценка MMM лежит между границами, поэтому команда оставляет модель, ставит на атрибутированные счета множитель 4 000 / 9 500, то есть около 0,42, и берёт 9 500 ₽ как плановую стоимость до следующего теста.
Когда применять
Подходит, когда вы тратите деньги в нескольких каналах, хотя бы один из которых офлайновый или плохо отслеживается, а разные команды называют разную отдачу на одни и те же деньги. Метод годится компаниям, которые могут позволить себе хотя бы несколько экспериментов в год и уже ведут MMM или собираются. Больше всего пользы он приносит перед годовым пересмотром бюджета.
Когда не применять
Полную систему не нужно строить, если у вас один-два канала или не хватает объёма для экспериментов и модели. Небольшому бизнесу больше расскажут один хорошо проведённый геотест и честный отчёт по атрибуции. Не внедряйте её ради одного сводного числа для совета директоров: инструменты измеряют разное, и если заставить их совпасть, настоящая неопределённость окажется спрятана.
Частые ошибки
- Заставлять MMM, атрибуцию и эксперименты сходиться до последней цифры. Плейбук Google предупреждает: так в расчёт попадают жёсткие допущения, и каждое число становится менее точным.
- Калибровать целый канал по одному эксперименту и считать результат окончательным.
- Сравнивать эксперимент и модель, которые измеряют разные результаты, периоды или уровни расходов, например двухнедельный тест кампании и годовую оценку канала.
- Использовать числа атрибуции для годового планирования, а числа модели для ежедневных ставок — ровно наоборот тому, для чего они созданы.
- Принимать точечную оценку из шумного эксперимента за точное значение, вместо того чтобы сравнивать доверительные интервалы.
Вопросы и ответы
Что такое единая система измерения маркетинга?
Это практика, при которой моделирование маркетингового микса, атрибуция и эксперименты на инкрементальность работают вместе, и каждый метод отвечает за те решения, где он сильнее. Эксперименты дают причинную проверку и служат для поправки двух других методов. Google называет тот же подход modern measurement. Единого стандарта и единого автора нет: метод изложен в документации вендоров и open-source-проектов.
Что такое триангуляция в измерении маркетинга?
Триангуляция — это сравнение оценок, полученных методами с ошибками из разных источников. Атрибуция обычно завышает вклад каналов, где считают клики, эксперименты дают осторожную, но причинную оценку, а MMM оказывается между ними. Когда все три указывают в одну сторону, действовать можно увереннее. Когда расходятся, перед переносом денег проверьте отслеживание, допущения модели или дизайн теста.
Как откалибровать модель маркетингового микса с помощью lift-тестов?
У каждого open-source-инструмента свой способ. Meridian превращает результаты экспериментов в приоры по ROI и корректирует их с учётом расходов, давности и длительности теста. Robyn добавляет разрыв между моделью и экспериментом как ошибку калибровки, которую минимизирует. PyMC-Marketing рассматривает каждый lift-тест как дополнительное наблюдение на кривой насыщения канала.
Как часто проводить калибровочные эксперименты?
Плейбук Google 2024 года описывает эксперименты как квартальную практику и советует повторять тесты каждые три–шесть месяцев: инкрементальность меняется вместе с расходами, сезоном и креативами. MMM обычно обновляют от одного до четырёх раз в год, а атрибуция считается ежедневно. Планируйте эксперименты под моменты, когда утверждается бюджет.
Нужна ли ещё многоканальная атрибуция?
Да, для ежедневной работы. Атрибуция быстрая и детальная, поэтому она подсказывает ставки, креативы и аудитории внутри канала. Для планирования она слабая: видит только отслеживаемые цифровые касания, а на iOS начиная с версии 14.5 для отслеживания между приложениями нужно разрешение пользователя. Калибровка экспериментами сохраняет её пользу.
Источники
- Google, Modern Measurement playbook, 2024 edition (PDF)
- Google, Ana Carreira Vidal and Hannah Lamb, Drive business goals with modern measurement, March 2024
- Google Meridian, ROI priors and calibration
- Google Meridian, Set custom ROI priors using past experiments
- Google, Meridian marketing mix model, developer documentation
- Meta Marketing Science, Robyn features: calibration with experiments
- Julian Runge, Igor Skokan, Gufeng Zhou, Koen Pauwels, Packaging Up Media Mix Modeling: An Introduction to Robyn's Open-Source Approach, arXiv, 2024
- PyMC-Marketing, Lift test calibration
- Yingxiang Zhang, Mike Wurm, Eddie Li, Alexander Wakim, Joseph Kelly, Brenda Price, Ying Liu, Media Mix Model Calibration With Bayesian Priors, Google, 2024
- Edwin Ng, Zhishi Wang, Athena Dai, Bayesian Time Varying Coefficient Model with Applications to Marketing Mix Modeling, Uber, arXiv, 2021
- Julian Runge, Harpreet Patter, Igor Skokan, A New Gold Standard for Digital Ad Measurement?, Harvard Business Review, March 2023
- Debbie A. Lawlor, Kate Tilling, George Davey Smith, Triangulation in aetiological epidemiology, International Journal of Epidemiology 45(6), 2016
- David Chan, Mike Perry, Challenges and Opportunities in Media Mix Modeling, Google, 2017
- Jon Vaver, Jim Koehler, Measuring Ad Effectiveness Using Geo Experiments, Google, 2011
- Brett R. Gordon, Florian Zettelmeyer, Neha Bhargava, Dan Chapsky, A Comparison of Approaches to Advertising Measurement: Evidence from Big Field Experiments at Facebook, Marketing Science 38(2), 2019
- Kellogg School of Management, Gordon, Moakler, Zettelmeyer, Close Enough? research abstract, 2023
- Randall A. Lewis, Justin M. Rao, The Unfavorable Economics of Measuring the Returns to Advertising, Quarterly Journal of Economics 130(4), 2015
- Google Ads Help, About data-driven attribution
- Google Ads Help, About Conversion Lift
- Meta for Developers, Lift studies
- Meta Open Source, GeoLift documentation, Methodology
- Apple Developer, User privacy and data use (App Tracking Transparency)
Обновлено 15 октября 2026

Маркетинг в финтехе: где реклама упирается в комплаенс, KYC и лицензии
Агентство может собрать кампании. Но проверку рекламных обещаний, отвал на KYC и лицензионные правила разных рынков оно не контролирует, а именно они решают, станет ли лид клиентом.
Маркетинговое агентство или система роста: что нужно на каждом этапе масштабирования
Агентство подходит, пока фаундер сам ведёт большую часть процессов. Когда бизнес начинает копировать себя в новые точки и регионы, нужна система, которая ставит цели, проверяет гипотезы и отвечает за результат.
Агентство медицинского маркетинга: почему работа с клиникой буксует и какую модель используем мы
Большинство агентств отвечают за клик, а за регистратуру не отвечает никто. Как мы строим маркетинг клиники в трёх горизонтах, на каких исследованиях это основано и что дал один год работы.