MaxDiff: что это и как провести анализ
MaxDiff — опрос, в котором людям показывают небольшие наборы пунктов и просят выбрать в каждом лучший и худший. На выходе у каждого пункта оценка на общей шкале, и пункты выстраиваются в рейтинг.
MaxDiff, или метод наилучшего-наихудшего выбора (best-worst scaling), — опрос, который ранжирует список пунктов по важности или привлекательности. Респондент видит наборы из четырёх-пяти пунктов и выбирает в каждом самый важный и наименее важный. За десяток наборов эти выборы дают каждому пункту оценку на одной шкале, без скопления оценок у верхнего края и без смещения из-за разной манеры пользоваться шкалой, которые портят вопросы с оценками.
- Автор
- Джордан Лувьер (придумал в Университете Альберты); первая публикация — вместе с Адамом Финном, придуман в 1987; впервые опубликован в 1992
- Уровень
- 301 · Продвинутый
- Подходит
- малый и средний бизнес, растущая компания
- Время на внедрение
- 1–2 недели: два дня на список пунктов и дизайн, неделя в поле, день на анализ
- Что понадобится
- список из 10–30 пунктов, которые отвечают на один вопрос: функции, выгоды или сообщения · инструмент опросов с поддержкой MaxDiff-дизайнов или экспериментальный дизайн, который вы построите сами · 150–300 респондентов из целевого сегмента, больше — если хотите сравнивать сегменты
MaxDiff — опрос, который ранжирует список пунктов: людей раз за разом просят выбрать лучший и худший из небольшого набора. В науке метод называется best-worst scaling. Продуктовые команды выбирают с его помощью функции, маркетологи — выгоду, с которой начать, а исследователи здравоохранения ранжируют то, что важно пациентам. В докладе Sawtooth Software 2019 года сказано, что 73% её клиентов за предыдущие 12 месяцев провели хотя бы одно MaxDiff-исследование.
Откуда взялся MaxDiff
Джордан Лувьер (Jordan Louviere) придумал метод в 1987 году в Университете Альберты, как написано в его собственной книге с Терри Флинном и Энтони Марли. Ту же дату называет технический доклад Sawtooth. В печать метод попал позже. Лувьер с коллегами пишут, что BWS «представили Финн и Лувьер (1992)» в исследовании общественной тревоги из-за безопасности пищевых продуктов, а некоторые работы ссылаются вместо этого на рабочий доклад 1991 года. Поэтому в литературе встречаются обе даты: 1987 для идеи и 1992 для первой публикации.
Метод опирается на парные сравнения Луиса Терстоуна 1927 года. Формальные модели выбора для него изложили Энтони Марли и Лувьер в Journal of Mathematical Psychology в 2005 году. Среди специалистов по маркетинговым исследованиям он быстро распространился после того, как Sawtooth Software выпустила свои первые инструменты MaxDiff в 2004 году.
Как устроен один вопрос MaxDiff
Респондент видит четыре или пять пунктов и делает два клика: один на самый важный, другой на наименее важный.
Возьмём четыре пункта: A, B, C и D. Если человек выбрал A лучшим и D худшим, вы уже знаете пять из шести возможных пар: A сильнее B, C и D, а B и C сильнее D. Открытой остаётся только пара B и C, и её закроет другой набор. С пятью пунктами два клика решают семь пар из десяти, по данным технического доклада Sawtooth.
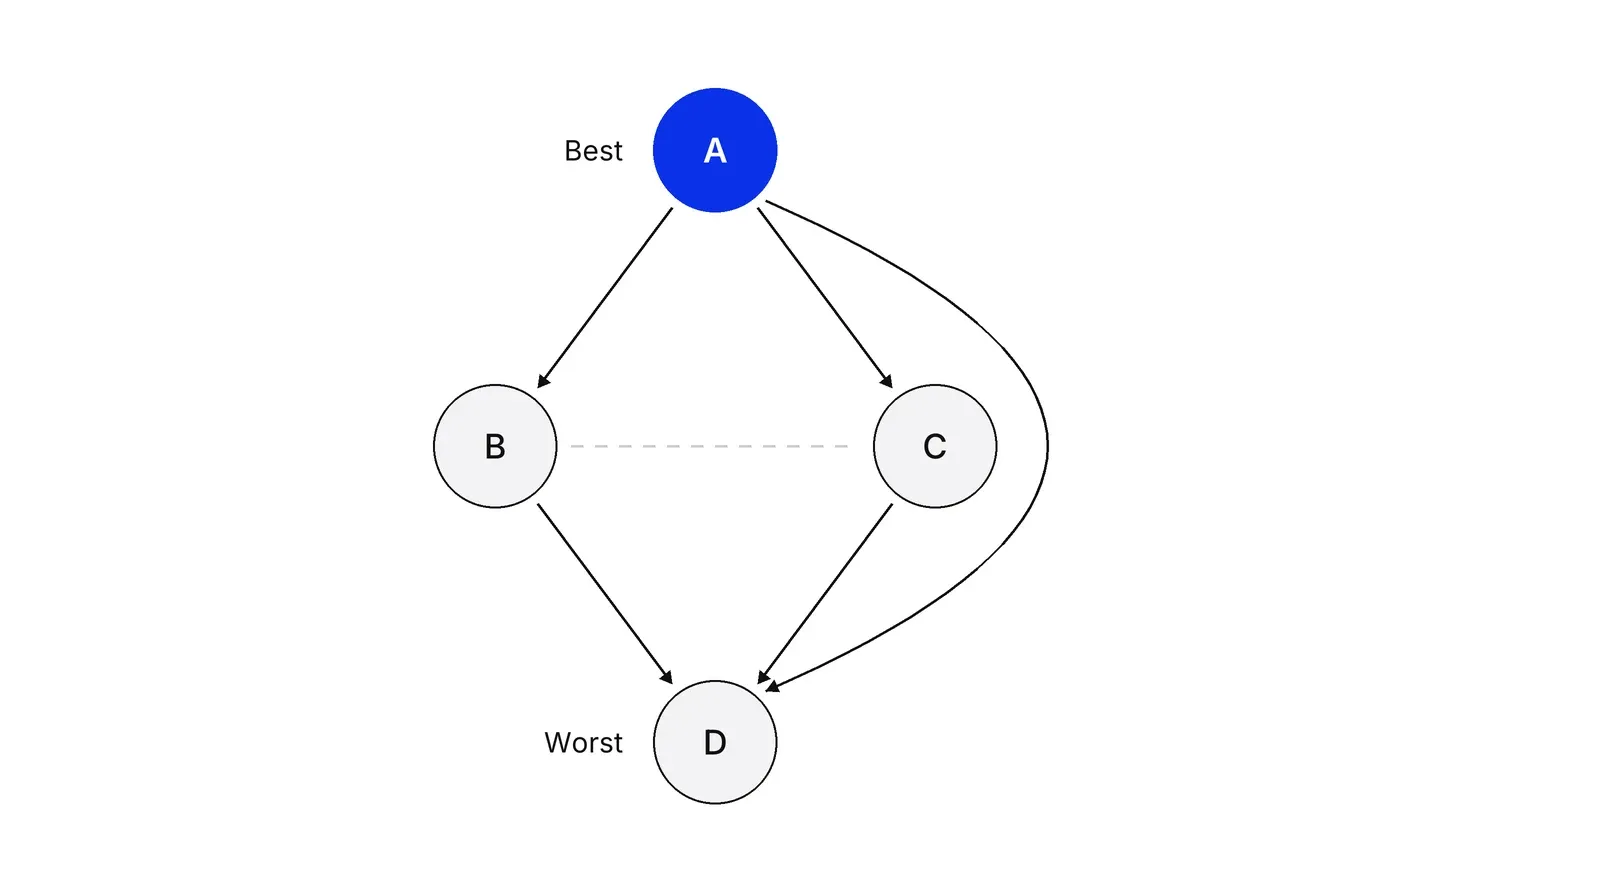
Кроме того, крайние варианты люди оценивают легче, чем середину, поэтому выбрать лучший и худший из четырёх быстрее, чем решать, заслуживает ли пункт 7 или 8 баллов из 10.
Почему не попросить просто оценить каждый пункт?
Оценки сбиваются в кучу. Большинство людей считает большинство пунктов важными, поэтому у списка из 16 функций оценки ложатся между 7 и 9, а порядок внутри этой полосы — в основном шум. Шкалой люди пользуются по-разному: кто-то никогда не ставит 10, кто-то ставит 10 всему, а привычки различаются по странам. Sawtooth называет это смещением в использовании шкалы (scale-use bias). MaxDiff его обходит, потому что люди выбирают, а не выставляют баллы.
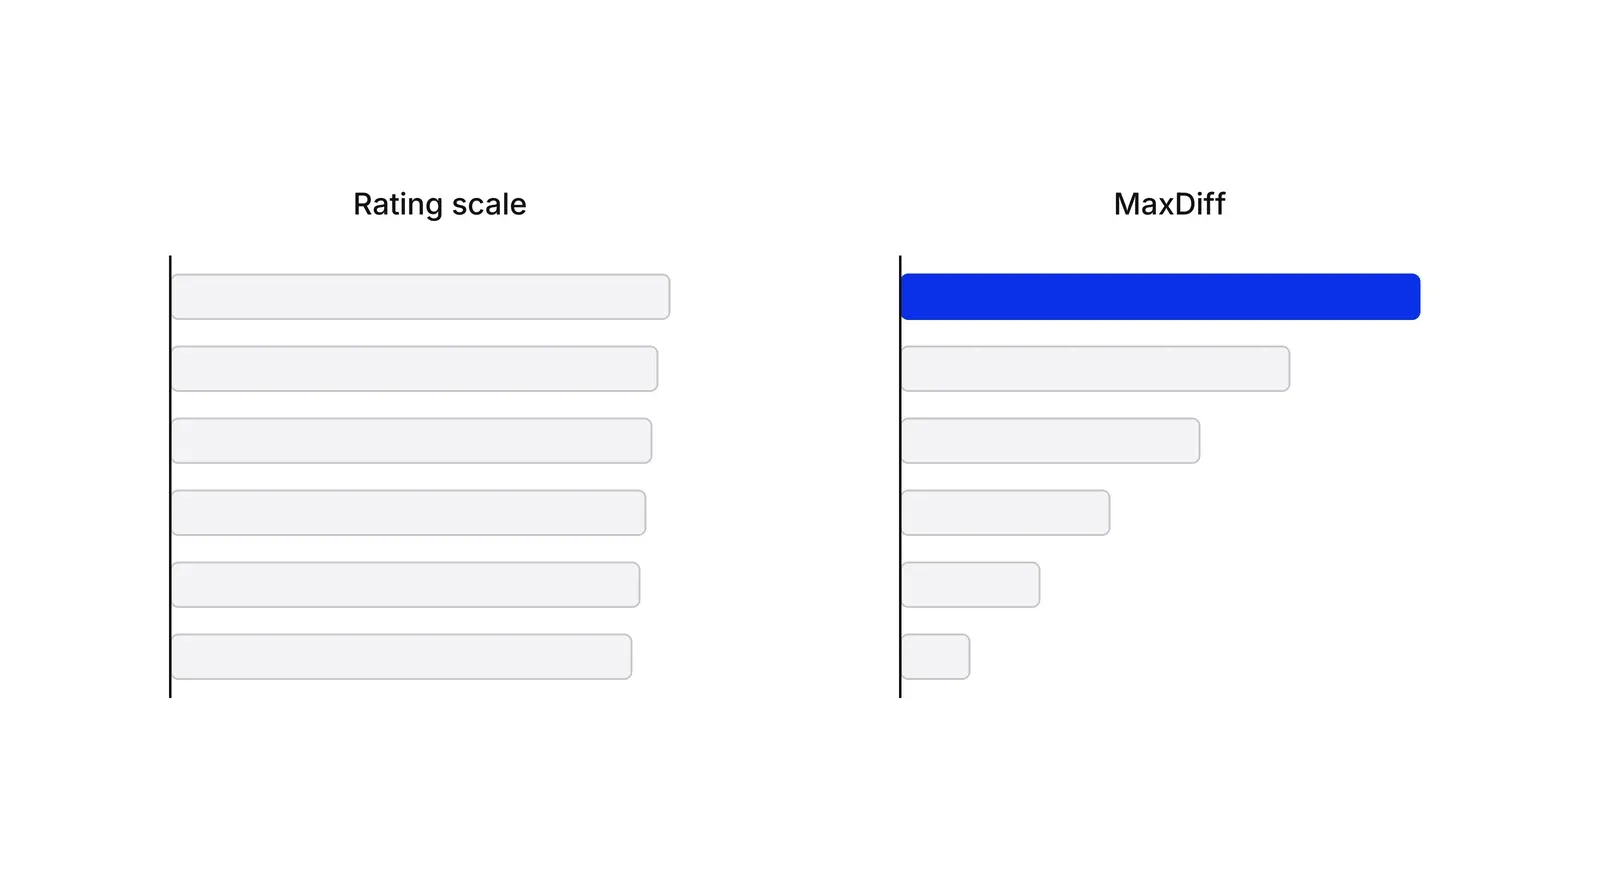
Доказательства дают прямые сравнения методов. Кит Хржан (Keith Chrzan) и Наталья Головашкина сопоставили шесть мер важности на 1 284 респондентах в 2006 году. MaxDiff лучше всех разделил пункты и лучше всех предсказал общую удовлетворённость: корреляция 0,62 против 0,30 у простых оценок. В статье ACL 2017 года Кириченко и Мохаммад (Kiritchenko, Mohammad) показали, что суждения «лучший — худший» надёжнее оценок при том же числе ответов.
Платить приходится временем. По данным Хржана и Головашкиной, MaxDiff занял больше времени, чем любой другой из шести методов, а Брайан Орме из Sawtooth оценивает его в примерно втрое больше времени, чем вопросы с оценками. Sawtooth продаёт программу для MaxDiff, так что учитывайте это, когда взвешиваете её утверждения.
Как спроектировать MaxDiff-исследование
Дизайн держится на трёх числах из технического доклада Sawtooth. Показывайте 4–5 пунктов в наборе: симуляции дали мало выигрыша после пяти для списков примерно до 30 пунктов, а показ больше половины списка за раз снижает точность. Пусть каждый пункт встречается у респондента около трёх раз — тогда индивидуальные оценки устойчивы. Число наборов следует отсюда: 3 × пунктов ÷ пунктов в наборе, так что 20 пунктов в наборах по 5 требуют 12 наборов.
Дизайн должен быть сбалансированным: каждый пункт встречается одинаково часто и примерно одинаково часто попадает в набор с каждым другим. Команда Лувьера для этого использует сбалансированные неполные блочные планы; инструменты опросов генерируют такой дизайн сами. По размеру выборки: обзор 2016 года по 62 исследованиям в здравоохранении нашёл медиану в 175 респондентов для дизайнов такого рода.
Как читать оценки MaxDiff
Самая быстрая оценка — счётчики: сколько раз пункт выбрали лучшим минус сколько раз худшим. Лувьер с коллегами показали, что на уровне выборки эти счётчики близко совпадают с оценками логит-модели. Для индивидуальных оценок и срезов по сегментам берите мультиномиальный логит или иерархическую байесовскую модель, а затем пересчитайте оценки так, чтобы они давали в сумме 100. На этой шкале, объясняет Sawtooth, пункт с оценкой 10 предпочитают примерно вдвое сильнее, чем пункт с оценкой 5.
Благодаря индивидуальным оценкам данные MaxDiff хорошо подходят для сегментации по потребностям. По данным Sawtooth, модели скрытых классов находят сегменты по данным MaxDiff лучше, чем кластеризация по оценкам.
Чего обычный MaxDiff не расскажет
Оценки относительные. Если важны все пункты или не важен ни один, MaxDiff всё равно выстроит их от первого до последнего. Anchored MaxDiff исправляет это, добавляя порог. Версия Лувьера с двойным ответом после каждого набора спрашивает, важны ли все пункты, некоторые или ни один; прямая версия Кевина Латтери задаёт отдельные вопросы «да» или «нет». Руководство Sawtooth предупреждает, что якорь может вернуть часть привычки со всем соглашаться, которую обычный MaxDiff убирает.
Для длинных списков нужны другие варианты. Sparse MaxDiff показывает каждый из 40 и более пунктов примерно по одному разу на человека; Хржан и Пейтц нашли, что он восстанавливает оценки полного дизайна лучше, чем вариант Express. Bandit MaxDiff чаще показывает пункты, которые нравились предыдущим респондентам, и Орме сообщает, что он может быть в 2–4 раза эффективнее при поиске нескольких лучших из 50 и более пунктов.
MaxDiff, конджойнт и шкалы оценок: сравнение
MaxDiff часто путают с конджойнт-анализом: оба метода основаны на выборе и вышли из одной исследовательской традиции. «Профильный» и «мультипрофильный» варианты best-worst scaling у Лувьера близки к конджойнту, но классический MaxDiff, который используют в маркетинговых исследованиях, — это «объектный» вариант: плоский список пунктов.
| Метод | Что оценивает респондент | Что вы получаете | Для чего |
|---|---|---|---|
| Шкала оценок | Каждый пункт отдельно, по шкале от 1 до 10 | Оценки, которые часто сбиваются в кучу | Быстрые проверки, отслеживание во времени |
| MaxDiff | Небольшие наборы пунктов, лучший и худший | Ранжированные оценки на одной общей шкале | Приоритизация функций, выгод, сообщений |
| Конджойнт-анализ | Целые профили продукта с атрибутами и ценой | Компромиссы, готовность платить, симуляции долей | Решения о цене и упаковке |
Типичная последовательность: с помощью MaxDiff сократить 30 функций-кандидатов до 6 важных, а затем проверить эти 6 вместе с ценой в конджойнт-исследовании. В нашей работе над Growth Lab победитель MaxDiff становится гипотезой, например открыть страницу с тарифами главной выгодой, и живой тест её проверяет.
Как применять: MaxDiff: что это и как провести анализ по шагам
- Напишите один вопрос и список пунктов. Решите, на какой вопрос должны ответить оценки, например какие выгоды выносить на страницу с тарифами. Пишите все пункты на одном уровне детализации, словами клиента, по одной идее в пункте. Результат: список из 10–30 пунктов, которые отвечают на один и тот же вопрос.
- Задайте числа дизайна. Показывайте 4–5 пунктов в наборе и никогда не больше половины списка. Наборов нужно столько, чтобы каждый пункт встретился у человека около трёх раз: наборов = 3 × пунктов ÷ пунктов в наборе. Для 16 пунктов в наборах по 4 получается 12 наборов. Результат: сбалансированный дизайн, где каждый пункт встречается одинаково часто и сталкивается с каждым другим.
- Проведите пилот на десяти людях. Понаблюдайте, как несколько человек проходят опрос. Ищите пункты, которые читаются как одинаковые, пункты, которые никто не понимает, и формулировки «самый» и «наименее», которые для вашего вопроса звучат странно. Результат: зафиксированный список и формулировка вопроса до полного запуска.
- Проведите опрос. Отправьте его целевому сегменту и добавьте два-три вопроса о профиле, по которым понадобятся срезы: роль, тариф, регион. Результат: чистый набор данных, где в каждом сегменте, который вы собираетесь сравнивать, достаточно людей.
- Рассчитайте и нормируйте оценки. Для быстрого взгляда начните с разности числа выборов «лучший» и «худший», затем запустите логит или иерархическую байесовскую модель и пересчитайте оценки в доли, дающие в сумме 100. Результат: одна оценка на пункт — для всей выборки и для каждого сегмента.
- Превратите оценки в решение. Лучшие пункты возьмите в роадмап, заголовок или оффер, нижние отбросьте или отодвиньте. Если нужно понять, важны ли слабые пункты вообще, повторите исследование с anchored-дизайном. Результат: ранжированный список, у которого есть владелец и по которому действуют.
Примеры
Финтех-приложение выбирает, что делать дальше
Пример иллюстративный. У платёжного приложения 16 запросов на функции и бюджет на три. Оно показывает 250 клиентам из малого бизнеса 12 наборов по 4 функции, так что каждая функция встречается трижды на человека. Массовые выплаты и расчёты в тот же день уходят далеко вперёд с долями 18 и 15 из 100, а запрос на тёмную тему получает 2. В прошлогоднем опросе с вопросами-оценками все 16 функций лежали между 7 и 9 из 10. Команда делает две лучшие функции, а оценки заодно показывают, что фрилансеры ставят напоминания о счетах гораздо выше, чем агентства.
Клиника выбирает сообщение для рекламы
Пример иллюстративный. Частная стоматологическая клиника проверяет 10 причин, по которым пациенты могут её выбрать: вечерний приём, фиксированные цены, приём у конкретного врача, парковка и другие. При наборах по 4 и трёх показах каждой причины каждый респондент отвечает на 8 наборов (3 × 10 ÷ 4 = 7,5, округляем вверх). Среди новых пациентов побеждают фиксированные цены и вечерний приём. Клиника открывает рекламу этими двумя и переносит строку про парковку на страницу контактов.
Когда применять
Применяйте метод, когда есть список из 10 и более сопоставимых пунктов и нужно решить, какие важнее: функции для роадмапа, выгоды для лендинга, заявления для упаковки, потребности для сегментации. Он лучше всего работает, когда вопросы с оценками дали плоский результат, где все пункты получили высокие баллы, или когда вы сравниваете группы, по-разному пользующиеся шкалами, например несколько стран.
Когда не применять
Не берите его, если нужно узнать, сколько люди готовы заплатить или как они обменивают цену на функцию: это задача для конджойнт-анализа. Не берите его и для списка короче примерно шести пунктов: там хватит обычного вопроса на ранжирование. Не используйте обычный MaxDiff, чтобы понять, важен ли пункт в абсолютном смысле, потому что оценки относительные; для этого нужен anchored MaxDiff.
Частые ошибки
- Смешивать уровни в списке, например «быстрая поддержка» рядом с «ответ в чате за 2 минуты». Респонденты сравнивают несравнимое, и оценки перестают что-либо значить. Пишите пункты на одном уровне.
- Показывать слишком много пунктов в наборе. Симуляции Sawtooth показали, что выигрыш заканчивается примерно после пяти, а показ больше половины списка в наборе снижает точность для средних пунктов.
- Давать слишком мало наборов на человека. Если каждый пункт встречается один раз, индивидуальные оценки шумят; стремитесь к трём показам каждого пункта на респондента или берите разреженный дизайн и читайте результаты только на уровне выборки.
- Читать низкие оценки как «неважно». Нижний пункт может быть очень важным: MaxDiff говорит лишь, что он важен меньше остальных. Если нужна абсолютная черта, добавьте вопрос-якорь.
- Считать счётчики окончательным ответом для отдельного человека. Лувьер с коллегами предупреждают, что разность выборов «лучший» и «худший» может не различить средние пункты у одного респондента; для индивидуальных оценок нужна модель.
Вопросы и ответы
Чем MaxDiff отличается от конджойнт-анализа?
MaxDiff ранжирует список отдельных пунктов, например функций или сообщений, на одной шкале. Конджойнт-анализ показывает целые профили продукта из атрибутов и уровней, включая цену, и оценивает, как люди обменивают одно на другое. Используйте MaxDiff, чтобы отобрать важное, а конджойнт — чтобы назначить цену и собрать пакет из короткого списка.
Сколько респондентов нужно для MaxDiff-исследования?
Жёсткого правила нет. Обзор 2016 года по 62 исследованиям в здравоохранении показал медиану в 175 респондентов в дизайнах для объектов, и нужно больше, если вы планируете сравнивать сегменты. Для сотен пунктов симуляции Sawtooth потребовали около 1 000 человек, чтобы найти лидеров в bandit-исследовании из 300 пунктов.
Сколько пунктов показывать в одном вопросе MaxDiff?
Четыре или пять. Технический доклад Sawtooth Software показывает, что для исследований примерно до 30 пунктов точность почти не растёт после пяти пунктов в наборе, и советует никогда не показывать больше половины всего списка в одном наборе. С anchored-дизайном и двойным ответом ограничьтесь четырьмя.
MaxDiff лучше шкалы оценок?
Для разделения пунктов — да. В исследовании на 1 284 людях Хржан и Головашкина обнаружили, что из шести мер важности MaxDiff дал лучшее разделение и самую высокую прогностическую валидность, а оценки — худшие результаты. Платить приходится временем: Брайан Орме из Sawtooth оценивает, что MaxDiff занимает примерно втрое больше времени, чем вопросы с оценками.
Что означают оценки MaxDiff?
После логит-модели или иерархической байесовской модели оценки обычно пересчитывают в доли, дающие в сумме 100 по всем пунктам. Шкала пропорциональная: пункт с оценкой 10 предпочитают примерно вдвое сильнее, чем пункт с оценкой 5. Они показывают только положение относительно других, а не то, проходит ли пункт абсолютную планку.
Источники
- Sawtooth Software, The MaxDiff System Technical Paper, Version 9, 2020
- Jordan J. Louviere, Terry N. Flynn, A.A.J. Marley, Best-Worst Scaling: Theory, Methods and Applications, Cambridge University Press, 2015
- Louviere, Flynn, Marley, Best-Worst Scaling, chapter 1: Introduction and overview of the book, Cambridge University Press, 2015
- Jordan Louviere, Ian Lings, Towhidul Islam, Siegfried Gudergan, Terry Flynn, An introduction to the application of (case 1) best-worst scaling in marketing research, International Journal of Research in Marketing 30(3), 2013
- A.A.J. Marley, J.J. Louviere, Some probabilistic models of best, worst, and best-worst choices, Journal of Mathematical Psychology 49(6), 2005
- Terry N. Flynn, Jordan J. Louviere, Tim J. Peters, Joanna Coast, Best-worst scaling: what it can do for health care research and how to do it, Journal of Health Economics 26(1), 2007
- Axel C. Mühlbacher, Peter Zweifel, Anika Kaczynski, F. Reed Johnson, Experimental measurement of preferences in health care using best-worst scaling: theoretical and statistical issues, Health Economics Review 6, 2016
- Kei Long Cheung and colleagues, Using best-worst scaling to investigate preferences in health care, PharmacoEconomics 34(12), 2016
- Ilene L. Hollin and colleagues, Best-worst scaling and the prioritization of objects in health: a systematic review, PharmacoEconomics 40(9), 2022
- Keith Chrzan, Natalia Golovashkina, An empirical test of six stated importance measures, International Journal of Market Research 48(6), 2006
- Svetlana Kiritchenko, Saif M. Mohammad, Best-Worst Scaling More Reliable than Rating Scales: A Case Study on Sentiment Intensity Annotation, ACL 2017
- Bryan Orme, How good is best-worst scaling?, Quirk's, July 2018
- Sawtooth Software, Lighthouse Studio manual: What is MaxDiff?
- Sawtooth Software, Lighthouse Studio manual: Anchored MaxDiff
- Bryan Orme, Anchored Scaling in MaxDiff Using Dual Response, Sawtooth Software, 2009
- Kevin Lattery, Anchoring Maximum Difference Scaling Against a Threshold: Dual Response and Direct Binary Responses, Sawtooth Software, 2011
- Bryan Orme, Sparse, Express, Bandit, Relevant Items, Tournament, Augmented, and Anchored MaxDiff, Sawtooth Software, 2019
- Bryan Orme, Bandit MaxDiff: When to Use It and Why It Can Be a Better Choice than Standard MaxDiff, Sawtooth Software, 2018
- Sawtooth Software knowledge base, Sample size for Bandit MaxDiff studies
- Bryan Orme, Adaptive Maximum Difference Scaling, Sawtooth Software, 2006
- Keith Chrzan, Megan Peitz, Best-Worst Scaling with many items, Journal of Choice Modelling 30, 2019
- Julie Anne Lee, Geoffrey Soutar, Jordan Louviere, Measuring values using best-worst scaling: the LOV example, Psychology & Marketing 24(12), 2007
Обновлено 15 октября 2026

Маркетинговое агентство или система роста: что нужно на каждом этапе масштабирования
Агентство подходит, пока фаундер сам ведёт большую часть процессов. Когда бизнес начинает копировать себя в новые точки и регионы, нужна система, которая ставит цели, проверяет гипотезы и отвечает за результат.
Агентство медицинского маркетинга: почему работа с клиникой буксует и какую модель используем мы
Большинство агентств отвечают за клик, а за регистратуру не отвечает никто. Как мы строим маркетинг клиники в трёх горизонтах, на каких исследованиях это основано и что дал один год работы.
Тестирование рекламных каналов: почему тест затухает на третьем месяце
Большинство тестов нового рекламного канала заканчиваются не решением. Они заканчиваются, когда кончился бюджет, поменялась атрибуция или все тихо перестали открывать дашборд.