Прогнозирование временных рядов: методы
Прогнозирование временных рядов предсказывает метрику, например спрос или выручку, по её собственной истории: декомпозиция, экспоненциальное сглаживание, ARIMA или Prophet, а качество проверяют на данных, которых модель не видела.
Прогнозирование временных рядов — это расчёт будущих значений метрики (недельного спроса, месячной выручки) по закономерностям её прошлого. Обычный набор инструментов: разложение на тренд и сезонность, экспоненциальное сглаживание, ARIMA и Prophet. Модели сравнивают с простыми эталонами на скользящих тестах вне обучающей выборки и считают ошибку, например MASE.
- Автор
- Charles Holt, Peter Winters, George Box и Gwilym Jenkins, Cleveland с коллегами, Sean Taylor и Ben Letham, Holt 1957; Winters 1960; Box и Jenkins 1970; STL 1990; Prophet 2018
- Уровень
- 401 · Экспертный
- Подходит
- растущая компания, корпорация
- Время на внедрение
- один день на первый эталонный прогноз и скользящий тест по одной метрике
- Что понадобится
- регулярный ряд метрики минимум за два-три года, по одному значению в день, неделю или месяц · список известных событий, которые искажают ряд: акции, изменения цен, сбои, праздники · один человек, который отвечает за прогноз и записывает его до начала периода
Прогнозирование временного ряда — это расчёт будущих значений метрики по её собственной истории: недельных заказов, месячных броней, дневных транзакций. На этой странице разобран статистический набор инструментов для такой задачи. Прогнозы выручки по воронке и экспертные оценки описаны в статье про методы прогнозирования продаж. Два подхода дополняют друг друга, а меры ошибки ниже подходят обоим.
Можно ли вообще прогнозировать эту метрику?
По Робу Хайндману и Джорджу Атанасопулосу (Forecasting: Principles and Practice) метрика прогнозируется настолько, насколько выполняются четыре условия: вы понимаете её драйверы, данных достаточно, будущее похоже на прошлое, а прогноз не влияет на то, что прогнозируется. Краткосрочный спрос на электричество в домах проходит все четыре проверки, потому что его определяет температура. Валютные курсы не проходят большинство: кризисы ломают прежние закономерности, а опубликованные прогнозы могут сдвинуть сам курс. Книга сравнивает предсказание роста или падения курса с подбрасыванием монеты.
Бизнес-метрики лежат посередине. Сначала сделайте эту проверку: она решает, строить ли модель или обратиться к сценарному планированию.
Декомпозиция: тренд, сезонность, остаток
Декомпозиция делит ряд на медленный тренд, повторяющуюся сезонную составляющую и остаток. Классическая декомпозиция, которая появилась в 1920-х, усредняет каждый сезон по годам. Теперь учебник её не советует: она исходит из того, что сезонный рисунок не меняется, и плохо реагирует на необычные значения.
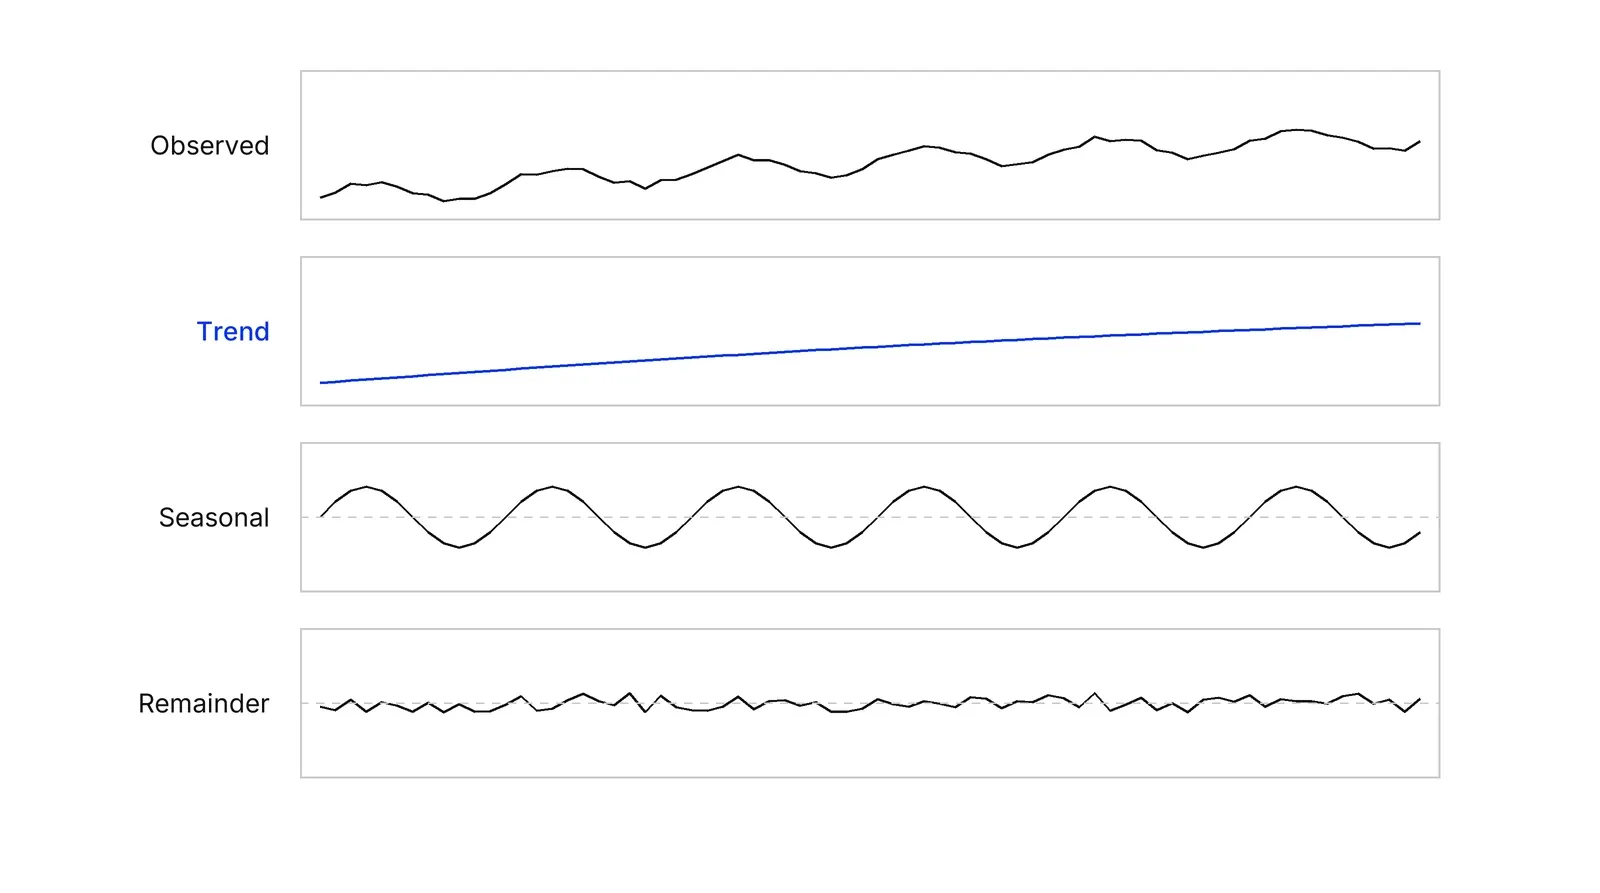
STL (seasonal and trend decomposition using loess, то есть сезонно-трендовая декомпозиция на основе локальной регрессии) опубликовали Роберт Кливленд, Уильям Кливленд, Джин Макрэй и Ирма Терпеннинг в Journal of Official Statistics в 1990 году. Учебник перечисляет её преимущества: сезонный рисунок может меняться со временем, подходит любой сезонный период, а специальная опция ограничивает влияние выбросов. По умолчанию сезонное окно — 11 наблюдений, а окно тренда для месячных данных — 21. Чем окна меньше, тем быстрее рисунок может меняться. Прежде чем строить модель, нарисуйте составляющие: так заметны скачок уровня или всплеск от акции.
Экспоненциальное сглаживание и семейство ETS
Экспоненциальное сглаживание прогнозирует взвешенным средним прошлых значений, где свежие данные весят больше. Хольт добавил в метод тренд в 1957 году, Уинтерс — сезонность в 1960-м, и метод Хольта — Уинтерса держит три сглаженные части: уровень, тренд и сезонный рисунок. Аддитивную форму берите, когда сезонные колебания остаются примерно одного размера, мультипликативную — когда они растут вместе с уровнем. По словам книги, затухающий тренд с мультипликативной сезонностью часто даёт точные прогнозы для сезонных данных.
Семейство ETS записывает каждый вариант как модель из трёх частей: ошибка (Error), тренд (Trend) и сезонность (Seasonal). Это даёт интервалы прогноза и позволяет программе выбирать модель по информационному критерию. Автоматический подбор и ETS, и ARIMA по множеству рядов описан в статье о пакете forecast.
ARIMA: моделируем автокорреляцию
ARIMA строит прогноз по прошлым значениям ряда и прошлым ошибкам прогноза, после того как дифференцирование превращает ряд в стационарный. У стационарного ряда статистические свойства не зависят от момента наблюдения. Тренд и сезонность это нарушают, а дифференцирование, при котором каждое значение заменяют его изменением от предыдущего, их убирает. Сезонная разность вычитает значение того же месяца прошлого года, и по практическому правилу из учебника её нужно брать, когда сила сезонности не меньше 0,64. Подход идёт от Джорджа Бокса и Гвилима Дженкинса, и их книга вышла уже в пятом издании.
Алгоритм Хайндмана и Хандакара автоматизирует выбор: повторные тесты KPSS определяют число разностей (0, 1 или 2), p-значение ниже 0,05 сигнализирует, что дифференцирование нужно, а затем пошаговый поиск снижает AICc. ETS и ARIMA пересекаются, но ни одна не содержит другую, а AICc не сравнивает модели из разных семейств, поэтому для такого сравнения нужна кросс-валидация. Примеры из учебника показывают, почему. На населении Австралии, несезонном ряду, у ETS кросс-валидационная RMSE была около 0,077 против 0,194 у ARIMA, а на сезонном производстве цемента ARIMA чуть опередила ETS на тестовой выборке: 216 против 222.
Prophet: тренд, сезонность и праздники для аналитиков
Prophet — инструмент прогнозирования с гибким трендом, сезонными циклами и таблицей праздников. Шон Тейлор и Бен Летам описывают его в статье, размещённой на сайте Meta Research (принадлежит компании Meta, признанной экстремистской организацией и запрещённой в России), как инструмент для множества бизнес-рядов при нехватке специалистов по прогнозированию: модель сочетается с понятными настройками, которые аналитик может менять сам. На вход идут два столбца: дата и значение.
Prophet ищет изменения тренда в 25 кандидатах на точки излома в первых 80% истории и оставляет мало точек за счёт разреженного априорного распределения, сила которого по умолчанию равна 0,05. Сезонность описывается рядами Фурье: по умолчанию порядок 10 для годовой и 3 для недельной. Праздники берутся из вашей таблицы с масштабом априорного распределения 10 по умолчанию, а для дополнительных регрессоров нужны их будущие значения. Модели маркетингового микса развивают идею дальше: регрессорами там служат расходы.
| Метод | Для чего лучше всего |
|---|---|
| Сезонный наивный | Эталон, который должна обойти любая модель |
| ETS | Ясные тренд и сезонность, автоматический подбор |
| ARIMA | Ряды с автокорреляцией после дифференцирования |
| Prophet | Дневные данные, несколько циклов, праздники, изломы тренда |
Как оценить прогноз?
Оценивайте прогноз на данных, которых модель не видела, через кросс-валидацию временных рядов: каждая тестовая точка прогнозируется только по наблюдениям до неё, а точка отсчёта движется вперёд. Диагностика в Prophet работает так же: по умолчанию начальное окно равно трём горизонтам, а точка отсчёта сдвигается каждые полгоризонта.
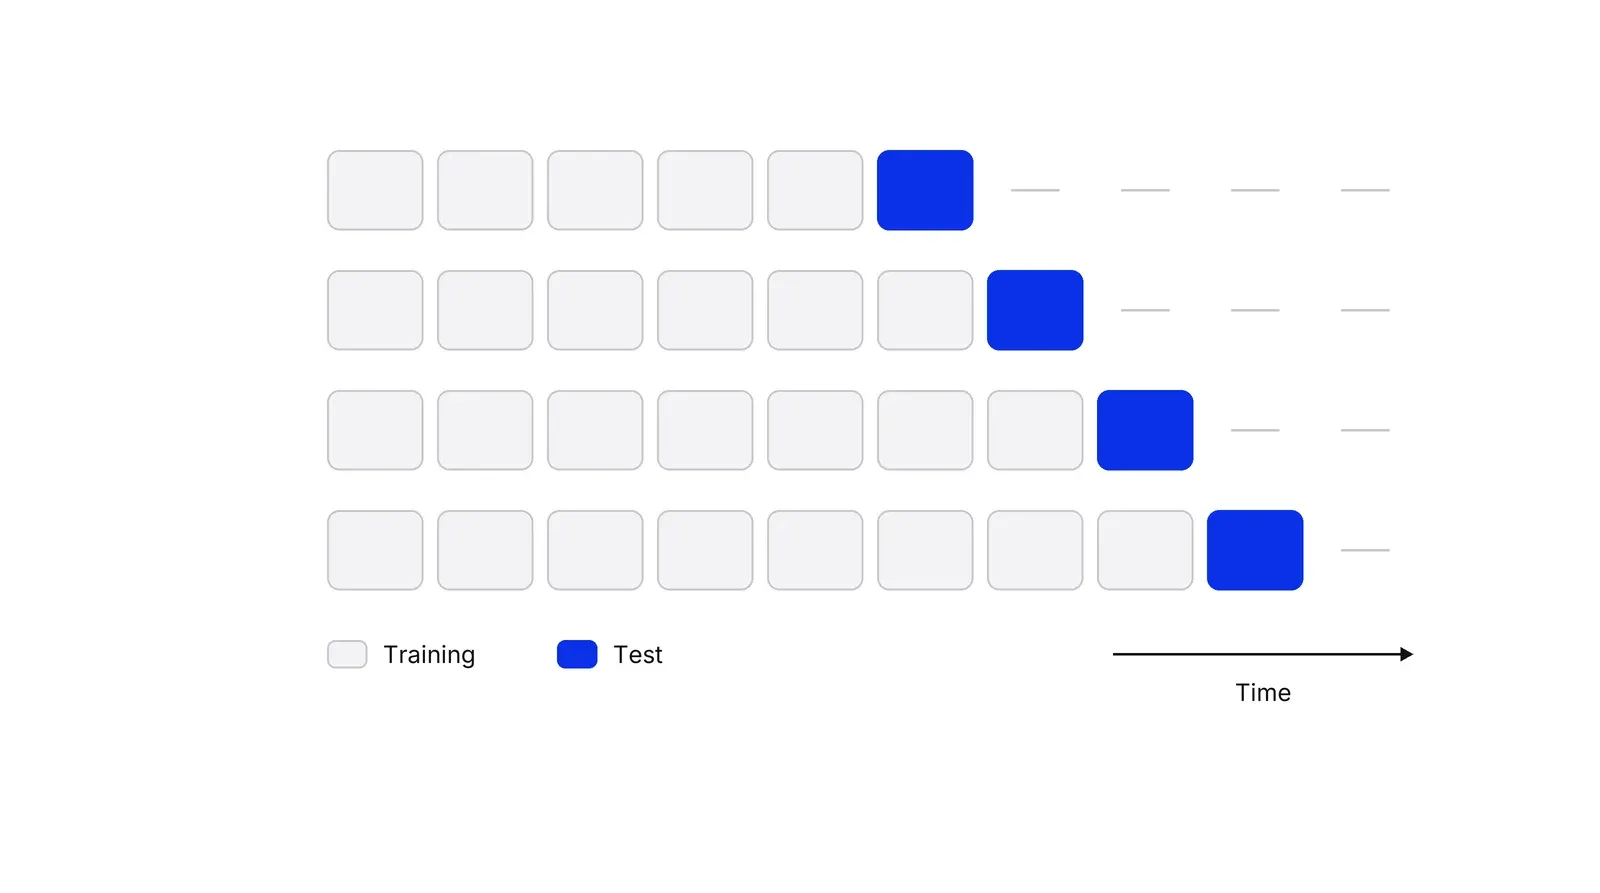
Затем выберите меру. MAE и RMSE выражены в единицах данных. MAPE даётся в процентах, но не определена, когда факт равен нулю. Роб Хайндман и Энн Кёлер предложили среднюю абсолютную масштабированную ошибку, когда обнаружили, что прежние меры часто не определены или вводят в заблуждение. MASE делит ошибку на ошибку наивного прогноза на обучающих данных, поэтому значение ниже единицы означает, что модель лучше наивной. Возьмём иллюстративную клинику, у которой сезонный наивный прогноз на обучающих данных ошибается в среднем на 50 записей в месяц (MAE). Если разделить MAE каждой модели на скользящих началах отсчёта на 50, получится её MASE:
| Метод | MAE (записи) | MASE | Лучше наивной? |
|---|---|---|---|
| Сезонный наивный | 50 | 1,00 | Эталон |
| ETS | 38 | 0,76 | Да |
| ARIMA | 41 | 0,82 | Да |
| Prophet | 53 | 1,06 | Нет |
Следите и за средней ошибкой со знаком: так видно систематическое смещение.
Вместе с числом показывайте диапазон. Интервал прогноза расширяется с ростом горизонта. Обычно берут уровни 80% и 95%, а при нормальных ошибках множители стандартного отклонения прогноза равны 1,28 и 1,96. Прогноз в 420 записей со стандартным отклонением 30 даёт 80%-й интервал от 382 до 458 и 95%-й от 361 до 479. Если две модели расходятся ненамного и на нескольких началах отсчёта, относитесь к разрыву так же осторожно, как к результату A/B-теста по правилам статистической значимости.
Что показали соревнования M
M-соревнования — открытые состязания под руководством Спироса Макридакиса с коллегами (в M3 — Мишель Ибон, в M4 и M5 — Евангелос Спилиотис и Василиос Ассимакопулос): команды прогнозируют одни и те же ряды, а оценивают их по отложенным данным. На практику влияют три результата. В 2018 году Макридакис с коллегами обнаружили, что на 1045 месячных рядах соревнования M3 популярные методы машинного обучения уступили восьми статистическим. В M4 12 из 17 самых точных методов были комбинациями в основном статистических подходов, а шесть чисто машинных методов показали слабый результат: ни один не превзошёл комбинированный эталон. Главной неожиданностью стал гибрид статистических и машинных признаков: его средняя sMAPE оказалась почти на 10% лучше этого эталона.
M5 изменил картину для розницы: на 42 840 рядах продаж Walmart в штуках лучший статистический эталон обошли только 415 команд, 7,5% участников, а пятёрка победителей обошла его больше чем на 20%, в основном с моделями LightGBM. Первое место занял Ёнджун Им, студент последнего курса бакалавриата, а 48,4% всех команд обошли простой наивный эталон. Победители M3 и M4 обгоняли свои эталоны менее чем на 10%. Урок в данных: тысячи связанных рядов с ценами и событиями выигрывают от машинного обучения, а один короткий ряд — от простых методов и хорошего эталона.
С чем это связано
Статистические прогнозы дают финансовой модели роста базовую линию, которую затем сценарии двигают вверх или вниз. Известные драйверы можно ввести как регрессоры, как показывает регрессия с временными рядами. План Growth Lab от Pushers начинается с истории ошибок прогноза: цель, поставленная на неоценённом прогнозе, остаётся догадкой.
Как применять: Прогнозирование временных рядов: методы по шагам
- Проверьте, что метрику вообще можно прогнозировать. Задайте четыре вопроса из первого раздела ниже: понятны ли драйверы, хватает ли истории, будет ли будущее похоже на прошлое, меняет ли сам прогноз результат. Результат: ответ «да» или «нет» на статистический прогноз и список того, что ломает закономерность.
- Нарисуйте ряд и разложите его. Разделите ряд на тренд, сезонную составляющую и остаток методом STL. Отметьте сезонный период (12 для месячных данных, 7 для дневных), выбросы и скачки уровня. Результат: понятная картина тренда и размера сезонности до выбора модели.
- Задайте эталоны. Сделайте прогноз наивным методом и сезонным наивным, который повторяет тот же период прошлого года. Любая следующая модель обязана обойти оба. Результат: два значения ошибки, которые сложная модель должна улучшить.
- Подберите две-три модели. Обучите ETS и ARIMA, а если важны праздники или несколько сезонных циклов, ещё и Prophet. Известные события добавьте как входные данные там, где их будущие значения известны. Результат: три набора прогнозов на одни и те же периоды.
- Оцените на скользящем начале отсчёта. Сдвигайте точку отсчёта вперёд по последним 12–24 периодам, каждый раз прогнозируйте на нужный вам горизонт и считайте MASE и смещение на этом горизонте. Результат: таблица ошибок по методам и горизонтам на данных, которых модель не видела.
- Покажите диапазон и ведите журнал. Давайте точечный прогноз вместе с 80%- или 95%-м интервалом, записывайте каждый прогноз до начала периода и раз в месяц пересчитывайте ошибку. Результат: прогноз с диапазоном и текущая история ошибок.
Примеры
Стоматологическая клиника планирует загрузку кресел
Иллюстративный пример. У клиники есть данные о числе приёмов за 36 месяцев: провал каждый август и рост каждый январь. STL отделяет медленный восходящий тренд от сезонных колебаний примерно в 15%. Эталоном служит сезонный наивный прогноз, а ETS и ARIMA проверяют на 12 скользящих началах отсчёта с горизонтом 3 месяца. Лучшая модель вместе со своим 80%-м интервалом задаёт график работы гигиенистов на квартал вперёд.
Платёжная компания прогнозирует объём транзакций
Иллюстративный пример. В дневном числе транзакций есть недельный цикл, годовой цикл, пики в конце месяца и государственные праздники. Prophet принимает таблицу праздников и сразу учитывает оба цикла, а ARIMA требует больше ручной настройки. Обе модели сравнивают с сезонным наивным эталоном на горизонте 28 дней. Новое направление выплат — это скачок уровня, поэтому его вводят как известное событие, а первые 4 недели проверяют вручную.
Когда применять
Применяйте, когда у метрики есть регулярная история и на ней надо строить планы: загрузка мощностей, запасы, денежный поток, штат, темп расходования рекламного бюджета. Лучше всего работает на сезонных рядах за устойчивым бизнесом.
Когда не применять
Не берите, если истории мало или бизнес только что изменился: новый продукт, прайс или рынок рвёт связь между прошлым и будущим. Не берите и тогда, когда прогноз сам меняет результат, как план продаж.
Частые ошибки
- Оценивать модель на тех же данных, на которых её обучали. Ошибка на обучающих данных всегда меньше, чем на новых. Используйте скользящее начало отсчёта.
- Пропускать эталон. Модель, которая не обходит сезонный наивный прогноз, добавляет затраты, но не точность.
- Показывать только MAPE. Она не определена при нулевом факте и по-разному наказывает за завышение и занижение. Добавьте MASE и смещение со знаком.
- Показывать одно число. Без 80%- или 95%-го интервала читатель не отличит уверенный прогноз от догадки.
Вопросы и ответы
Какой метод прогнозирования временных рядов лучший?
Универсального победителя нет. В соревновании M4 комбинации в основном статистических методов заняли 12 из 17 первых мест, а чистое машинное обучение показало слабый результат. В M5 на 42 840 связанных рядов розничных продаж выиграло машинное обучение. Начните с сезонного наивного эталона, затем проверьте на своих данных ETS, ARIMA и ещё один метод.
Чем ARIMA отличается от экспоненциального сглаживания?
Экспоненциальное сглаживание описывает уровень, тренд и сезонность взвешенными средними. ARIMA моделирует автокорреляцию, которая остаётся после дифференцирования, когда ряд становится стационарным. Подходы пересекаются, но ни один не включает другой, поэтому сравнивайте их кросс-валидацией, а не через AICc, который работает только внутри одного семейства.
Как измерить точность прогноза?
Считайте ошибки на данных, которых модель не видела, со скользящим началом отсчёта. MAE и RMSE выражены в единицах данных. MAPE даётся в процентах, но ломается около нуля. MASE делит ошибку на ошибку наивного прогноза на обучающих данных, поэтому значение ниже 1 означает, что модель лучше наивной. Следите и за смещением со знаком.
Сколько истории нужно для прогноза?
Столько, чтобы каждый моделируемый сезонный цикл прошёл больше одного раза. По документации Prophet, если нужна годовая сезонность, первое окно обучения должно охватывать как минимум год. Ряд из нескольких десятков точек, обычный для B2B-продаж, как правило, тянет только простые методы.
Источники
- Rob J Hyndman, George Athanasopoulos, Forecasting: Principles and Practice (3rd ed.), What can be forecast?
- Hyndman, Athanasopoulos, Forecasting: Principles and Practice, Classical decomposition
- Hyndman, Athanasopoulos, Forecasting: Principles and Practice, STL decomposition
- Hyndman, Athanasopoulos, Forecasting: Principles and Practice, Holt-Winters' seasonal method
- Hyndman, Athanasopoulos, Forecasting: Principles and Practice, Innovations state space models for exponential smoothing
- Hyndman, Athanasopoulos, Forecasting: Principles and Practice, Stationarity and differencing
- Hyndman, Athanasopoulos, Forecasting: Principles and Practice, ARIMA models
- Hyndman, Athanasopoulos, Forecasting: Principles and Practice, ARIMA modelling in fable
- Hyndman, Athanasopoulos, Forecasting: Principles and Practice, ARIMA vs ETS
- Hyndman, Athanasopoulos, Forecasting: Principles and Practice, Time series cross-validation
- Hyndman, Athanasopoulos, Forecasting: Principles and Practice, Evaluating point forecast accuracy
- Hyndman, Athanasopoulos, Forecasting: Principles and Practice, Some simple forecasting methods
- Hyndman, Athanasopoulos, Forecasting: Principles and Practice, Prediction intervals
- Hyndman, Athanasopoulos, Forecasting: Principles and Practice, Introduction to regression with time series
- Robert B. Cleveland, William S. Cleveland, Jean E. McRae, Irma Terpenning, STL: A seasonal-trend decomposition procedure based on loess, Journal of Official Statistics 6(1), 1990
- Rob J Hyndman, Yeasmin Khandakar, Automatic time series forecasting: the forecast package for R, Journal of Statistical Software 27(3), 2008
- Wiley, Box, Jenkins, Reinsel, Ljung, Time Series Analysis: Forecasting and Control, 5th edition
- Rob J Hyndman, Anne B Koehler, Another look at measures of forecast accuracy, International Journal of Forecasting 22(4), 2006
- Sean J. Taylor, Benjamin Letham, Forecasting at scale, The American Statistician 72(1), 2018, Meta Research page
- Prophet documentation, Quick start
- Prophet documentation, Trend changepoints
- Prophet documentation, Seasonality, holiday effects, and regressors
- Prophet documentation, Diagnostics
- Spyros Makridakis, Michele Hibon, The M3-Competition: results, conclusions and implications, International Journal of Forecasting 16(4), 2000
- Makridakis, Spiliotis, Assimakopoulos, Statistical and Machine Learning forecasting methods: concerns and ways forward, PLOS ONE 13(3), 2018
- Makridakis, Spiliotis, Assimakopoulos, The M4 Competition: results, findings, conclusion and way forward, International Journal of Forecasting 34(4), 2018
- Makridakis, Spiliotis, Assimakopoulos, M5 accuracy competition: results, findings, and conclusions, International Journal of Forecasting 38(4), 2022
- Makridakis, Spiliotis, Assimakopoulos, M5 accuracy competition, preprint with full results
Обновлено 20 октября 2026

Финансовый директор на аутсорсе или финансовые операции: чего не хватает именно вам
Финансовый директор на аутсорсе — это человек. Финансовые операции — это система. Компании, которые ищут одно, часто упускают другое, а то и не имеют ни того, ни другого.
Маркетинговое агентство или система роста: что нужно на каждом этапе масштабирования
Агентство подходит, пока фаундер сам ведёт большую часть процессов. Когда бизнес начинает копировать себя в новые точки и регионы, нужна система, которая ставит цели, проверяет гипотезы и отвечает за результат.
Агентство медицинского маркетинга: почему работа с клиникой буксует и какую модель используем мы
Большинство агентств отвечают за клик, а за регистратуру не отвечает никто. Как мы строим маркетинг клиники в трёх горизонтах, на каких исследованиях это основано и что дал один год работы.