Кластерный анализ и сегментация: этапы и пример
Сегментация по потребностям делит клиентов на группы по тому, чего они ждут от продукта. Для этого опрос обрабатывают кластерным анализом или моделью латентных классов, так что сегменты берутся из данных, а не из догадок.
Сегментация по потребностям — метод исследования, который группирует клиентов не по тому, кто они, а по тому, какие потребности и выгоды для них важны. Респонденты оценивают или ранжируют список потребностей, а затем кластерный анализ (чаще всего k-means) или модель латентных классов собирает людей с похожими ответами в группы. Аналитик выбирает число сегментов, проверяет, что они повторяются на пересобранных выборках, и только потом описывает их.
- Автор
- Рассел Хейли (сегментация по выгодам); Гириш Пундж и Дэвид Стюарт (метод кластерного анализа для маркетинга), 1968; 1983
- Уровень
- 401 · Экспертный
- Подходит
- растущая компания, корпорация
- Время на внедрение
- от шести до десяти недель: две на список потребностей и анкету, две-четыре в поле, две на анализ и описание сегментов
- Что понадобится
- список из 15–30 потребностей или выгод в формулировках самих клиентов, обычно по 20 и более интервью · выборка примерно из 70–100 респондентов на каждую потребность, по которой вы собираетесь кластеризовать · аналитик, который умеет запускать k-means и модели латентных классов в R, Python или в программе вроде Latent GOLD · одно бизнес-решение, которое должны подсказать сегменты
Сегментация по потребностям находит сегменты клиентов в данных, а не придумывает их на совещании. Вы спрашиваете выборку из рынка, насколько важна каждая потребность из списка, а алгоритм кластеризации собирает вместе людей со схожими ответами. Сегменты задаются тем, чего люди хотят, а кто эти люди, описывают уже потом.
Идея восходит к сегментации по выгодам Рассела Хейли (Russell Haley) 1968 года. Он доказывал, что описательные признаки плохо предсказывают покупки, а выгоды, которые люди ищут, — «основные причины существования настоящих рыночных сегментов». Статистика появилась немного позже. Обзор Гириша Пунджа и Дэвида Стюарта (Girish Punj, David Stewart) 1983 года в Journal of Marketing Research описал, как маркетологам проводить кластерный анализ, а учебник Мишеля Веделя и Вагнера Камакуры (Michel Wedel, Wagner Kamakura) добавил модели конечных смесей. Самое практичное современное руководство — книга в открытом доступе Сары Дольникар, Беттины Грюн и Фридриха Лайша (Sara Dolnicar, Bettina Grün, Friedrich Leisch), которая раскладывает весь процесс на десять шагов.
Эта страница о самом анализе. О том, как выбирать основания сегментации и какие проверки должен проходить сегмент, читайте в материале про сегментацию рынка.
Что попадает в модель
В кластеризацию попадают только потребности. Это формулировки того, чего клиент хочет добиться или избежать, и каждый респондент оценивает их по важности. Возраст, отрасль, расходы и канал остаются за её пределами: ими потом описывают сегменты и ищут их в CRM.
Причина практическая. Если добавить демографию, алгоритм сгруппирует людей по демографии, и вы вернётесь к сегментам, которые у вас уже были. Тони Ульвик (Tony Ulwick) из Strategyn доказывает, что признаки вроде возраста или образования «почти никогда не объясняют», почему у клиентов разные неудовлетворённые потребности. В его методе, построенном на желаемых результатах (outcome-based), людей спрашивают, насколько важен каждый такой результат и насколько они довольны тем, как он достигается сейчас, а кластеризуют по разрыву между этими оценками.
Имеет значение и то, как измерять важность. На шкалах оценок люди называют важным всё подряд, и это сглаживает различия, от которых зависит кластеризация. Sawtooth Software сообщает, что модели латентных классов на данных MaxDiff «гораздо успешнее находят сегменты по потребностям», чем кластеризация данных со шкалами оценок.
Как k-means находит группы
K-means — алгоритм по умолчанию. Вы задаёте число сегментов k. Алгоритм ставит k центральных точек, относит каждого респондента к ближайшей, сдвигает каждый центр в среднее по попавшим к нему респондентам и повторяет это, пока центры не перестанут сдвигаться. Название k-means дал процедуре в 1967 году Дж. Маккуин (J. MacQueen).
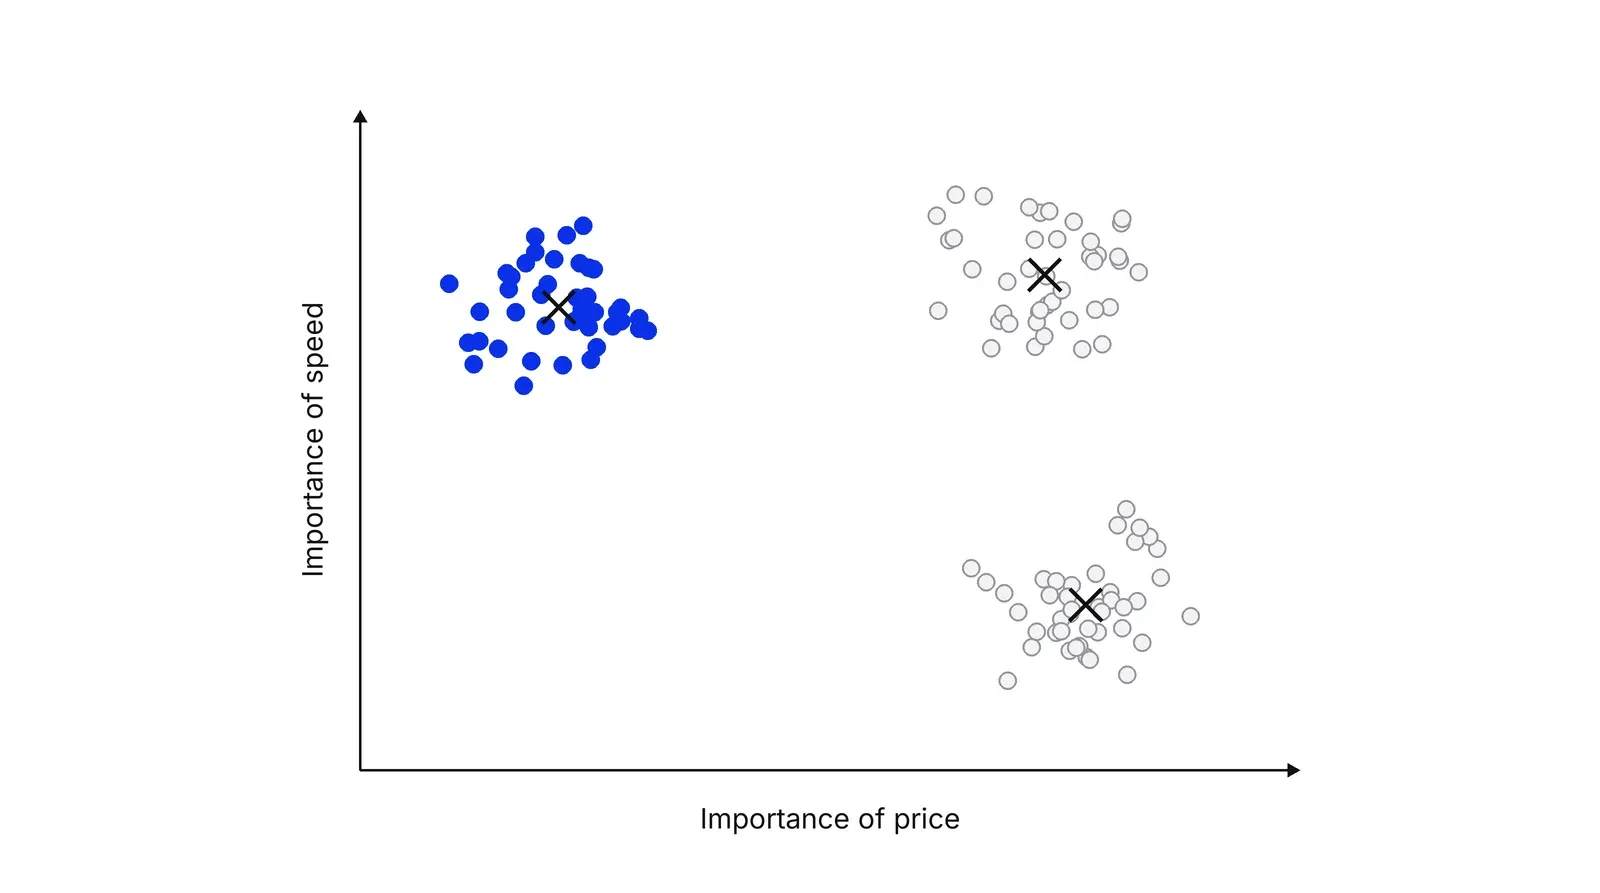
В настоящих опросах измерений не два, а от 15 до 30, но логика та же. Из принципа работы алгоритма следуют три предостережения. В зависимости от того, откуда стартуют центры, алгоритм может остановиться на плохом решении, поэтому руководство scikit-learn советует несколько запусков и более умный выбор стартовых точек, например k-means++. Алгоритм любит круглые группы похожего размера. И он чувствителен к масштабу, так что переменные с разными диапазонами сначала нужно стандартизировать. Все эти решения подробно разбирает обзор полувековой истории k-means Дугласа Стейнли (Douglas Steinley).
Пундж и Стюарт рекомендовали два этапа: найти стартовое решение методом минимальной дисперсии Уорда — иерархической процедурой 1963 года, а затем уточнить его итеративным методом вроде k-means. Команда Дольникар добавляет, что иерархические методы подходят для малых выборок, а k-means предпочтительнее примерно от 1000 респондентов.
Латентные классы: модель вместо расстояния
Анализ латентных классов, он же моделирование конечных смесей, исходит из того, что выборка — смесь скрытых групп, и оценивает размер каждой группы и её рисунок ответов. Каждый респондент получает вероятность принадлежности к каждому сегменту, а не жёсткую метку.
В симуляции, где истинные группы были известны, Магидсон и Вермунт обнаружили, что латентные классы неверно классифицировали 1,3% из 300 случаев, а k-means — 8%, k-means на стандартизованных переменных — 5%. Латентные классы также принимают вместе категориальные, порядковые и непрерывные переменные и не требуют стандартизации. Минус — затраты: нужна специальная программа, а совету директоров такой метод объяснять дольше.
| Метод | Как группирует | Лучше подходит для | На что смотреть |
|---|---|---|---|
| Иерархический (Уорд) | Шаг за шагом объединяет ближайших людей | Выборки до 1000 человек, стартовые решения | Медленный и трудный для чтения на больших данных |
| K-means | Относит каждого человека к ближайшему центру | Большие выборки, быстрый первый проход | Случайные старты, круглые кластеры, масштаб |
| Латентные классы | Оценивает скрытые группы и вероятности принадлежности | Смешанные типы данных, данные о выборе вроде MaxDiff | Программа, время расчёта, сложнее объяснить |
Сколько сегментов?
Единого правила для выбора k нет. Запустите анализ для каждого k от 2 до примерно 8 и сравните несколько показателей.
На графике локтя откладывают разброс внутри сегментов против k и ищут изгиб, после которого новые сегменты уже мало что дают. Команда Дольникар предупреждает, что он помогает только при хорошо разделённых сегментах, а в опросных данных сегменты часто разделены плохо.
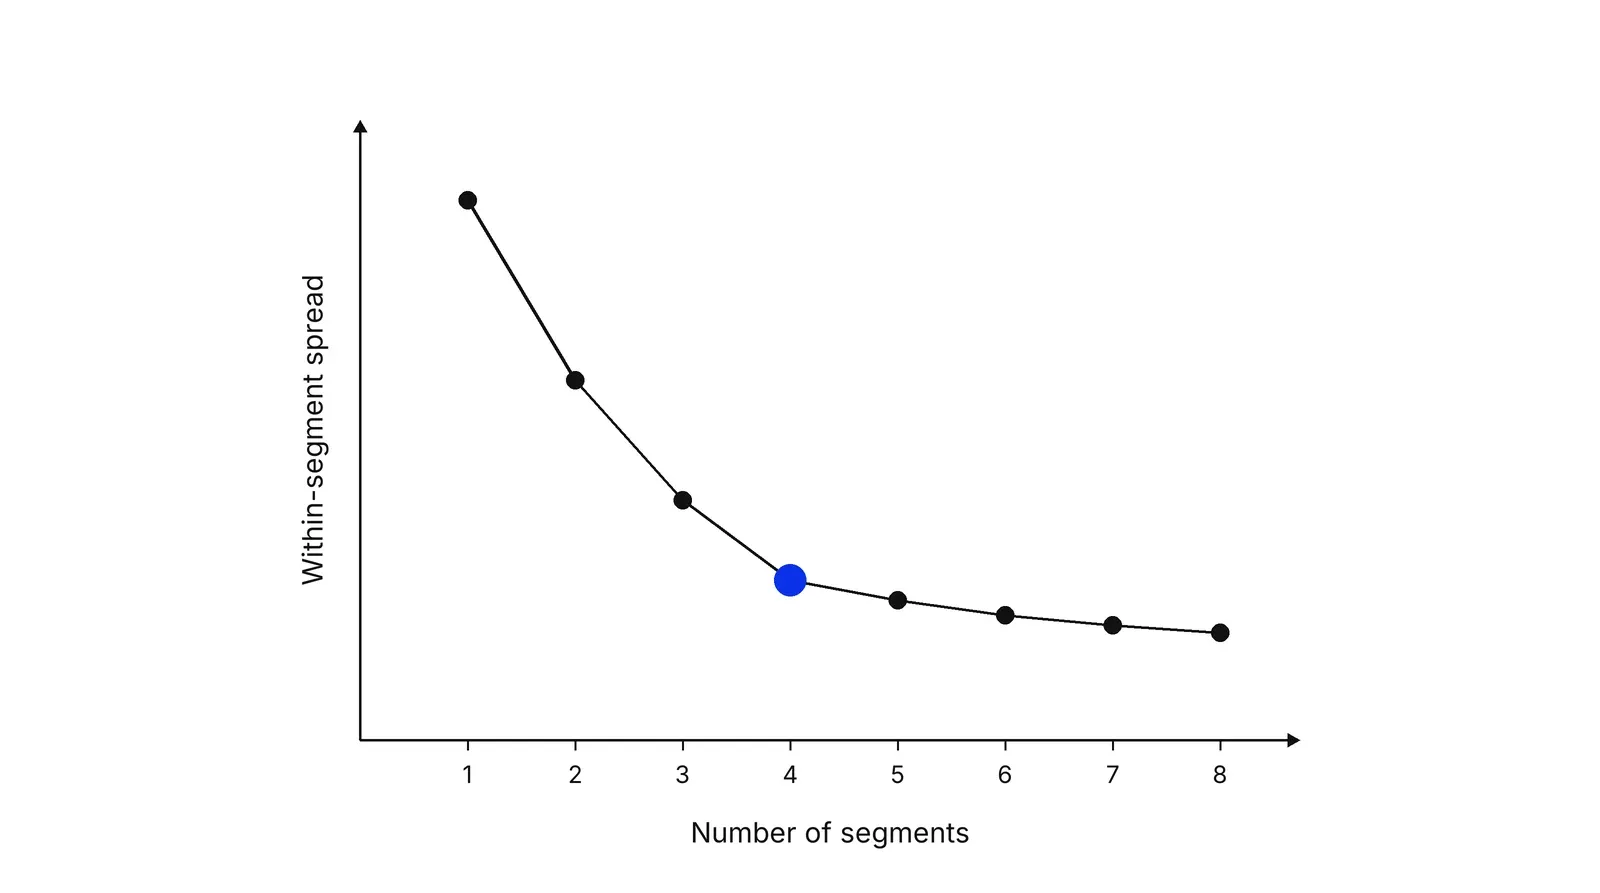
Другие индексы дают число, а не картинку. Индекс Калинского — Харабаша сравнивает разброс между сегментами с разбросом внутри них; Миллиган и Купер (Milligan, Cooper) проверили 30 правил остановки в 1985 году и, как резюмирует руководство Stata, выделили его как один из лучших. Силуэт Руссеу (Rousseeuw) измеряет, насколько каждый человек ближе к своему сегменту, чем к следующему. Статистика разрыва сравнивает качество подгонки с тем, что дали бы случайные данные. Для моделей латентных классов эту задачу решают информационные критерии, такие как BIC. Они могут расходиться: на одном наборе данных из книги Дольникар ICL указал на 4 сегмента, BIC — на 6, а AIC — не меньше чем на 8.
Настоящие ли это сегменты?
Действовать по сегментации имеет смысл, только если при небольшом изменении данных возвращаются те же сегменты. Команда Дольникар различает три случая. Естественные сегменты чётко различимы и устойчивы. Воспроизводимые сегменты повторяются от запуска к запуску, хотя ясных кластеров в данных нет. Конструктивные сегменты искусственны, и аналитик сам помогает выбрать самое полезное деление.
Проверка — бутстреп. Берите пары пересобранных выборок, выделяйте в каждой сегменты и сравнивайте их по скорректированному индексу Рэнда: 1 означает полное совпадение, 0 — совпадение на уровне случайности. Книга рекомендует 100 пар. Чтобы проверить отдельные сегменты, инструмент clusterboot Кристиана Хеннига (Christian Hennig) сообщает, как часто каждый из них удаётся восстановить; в его руководстве средний коэффициент Жаккара от 0,75 считается признаком устойчивости, а 0,5 и ниже — признаком распада.
Две привычки, от которых стоит отказаться
Первая — факторно-кластерный анализ: свести потребности к нескольким факторам, а затем кластеризовать факторные баллы. На четырёх наборах данных команда Дольникар обнаружила, что факторный шаг отбрасывает от 46 до 53% вариации, а Дольникар и Грюн показали, что он не превосходит кластеризацию исходных данных. Вторая — запустить один алгоритм один раз и строить план по результату. В нашей работе по Growth Lab сегмент становится целью только тогда, когда он выдержал пересборку выборки и кто-то может назвать оффер, который для него изменится.
Как применять: Кластерный анализ и сегментация: этапы и пример по шагам
- Назовите решение и составьте список потребностей. Договоритесь, для чего нужны сегменты: для новой линейки, тарифной сетки или разделения продаж. Затем превратите интервью с клиентами в 15–30 формулировок потребностей: одна мысль в каждой и слова самого клиента, например «получать выплату в тот же день». Демографию в этот список не включайте. Результат: список потребностей и одно решение, которому он служит.
- Измерьте, насколько важна каждая потребность. Опросите выборку рынка о важности каждой потребности. Шкалы оценок заполняются быстро, но ответы на них сбиваются в кучу; MaxDiff заставляет выбирать и лучше разводит людей. Выборку считайте от числа потребностей: в симуляциях Дольникар (Dolnicar) и коллег хватало 70 респондентов на переменную, а в их более поздней книге рекомендуют 100. Результат: чистая оценка важности каждой потребности для каждого респондента.
- Подготовьте данные, не сжимая их. Уберите тех, кто проходил анкету слишком быстро, и тех, кто на все пункты ответил одинаково. Кластеризуйте сами оценки потребностей, а не факторные баллы, посчитанные по тем же данным: при таком сжатии часть информации теряется. Для k-means приведите все переменные к одной шкале. Результат: одна таблица, где строка — респондент, а столбец — потребность.
- Выделите сегменты для набора значений k. Запустите k-means с большим числом случайных стартов или модель латентных классов для каждого числа сегментов от 2 примерно до 8. Для каждого k оставьте лучший из запусков: k-means может остановиться на плохом локальном решении. Результат: для каждого k — одно решение-кандидат и его показатели качества.
- Выберите k и проверьте устойчивость. Сравните качество при разных k: для k-means по графику локтя, индексу Калинского — Харабаша или силуэту, для латентных классов — по BIC. Затем сделайте бутстреп: повторите анализ на пересобранных выборках и посмотрите, как часто возвращается каждый сегмент. Результат: число сегментов, которое и хорошо описывает данные, и воспроизводится; неустойчивые сегменты помечены.
- Опишите, назовите и распределите. Опишите каждый сегмент через главные потребности, а затем через демографию, поведение и ценность — их мы оставляли за пределами кластеризации. Дайте каждому простое имя и напишите короткий набор вопросов или правил для CRM, по которым новых клиентов относят к сегменту. Результат: именованные сегменты, которые отделы продаж и продукта могут найти в своих данных.
Примеры
Банк делит клиентов по набору счетов
Джей Магидсон и Йерун Вермунт (Jay Magidson, Jeroen Vermunt) описывают модель латентных классов, построенную по типам счетов у клиентов банка. Они подобрали модели с разным числом кластеров и оставили ту, у которой BIC ниже всех. Получилось четыре сегмента: «Ищущие выгоду» (Value Seekers) — 15%, «Консервативные вкладчики» (Conservative Savers) — 35%, «Середняки» (Mainstreamers) — 40% и «Инвесторы» (Investors) — 10%. По словам авторов, у «Инвесторов» было больше 30% депозитов банка. Затем данные опроса показали, чем этот сегмент доволен меньше всего, а дополнительная модель связала его недовольство с оттоком.
Телемедицинский сервис и 18 потребностей
Иллюстративный пример, реальная компания не подразумевается. Телемедицинский сервис пишет 18 формулировок потребностей — от «попасть к врачу в течение часа» до «один врач, который знает мою историю». При 70–100 респондентах на потребность он планирует получить 1 260–1 800 заполненных анкет. K-means для k от 2 до 8 не даёт чёткого локтя, поэтому команда сравнивает 3, 4 и 5 сегментов с помощью бутстрепа. Четыре сегмента возвращаются стабильно, а одна из групп в пятисегментном решении распадается в большинстве пересборок, так что команда оставляет четыре.
Платёжная компания выбирает, что разрабатывать
Иллюстративный пример, реальная компания не подразумевается. Платёжный стартап просит 1 600 продавцов (по 100 на потребность, по правилу Дольникар) проранжировать 16 потребностей в опросе MaxDiff и строит модель латентных классов по их выбору. Получаются три сегмента: продавцам важнее всего скорость выплат, низкие комиссии или поддержка нескольких валют. Профиль сегментов показывает, что третья группа небольшая, но продаёт за рубеж, — этого не выявило ни одно демографическое деление.
Когда применять
Применяйте метод, когда подозреваете, что клиенты хотят разного, но не можете сказать, какие группы существуют; когда демографические сегменты не предсказывают, кто купит; и перед решением о продукте, цене или позиционировании, которое обойдётся дороже исследования. Нужен рынок, на котором можно опросить тысячу человек и больше.
Когда не применять
Не берите его, если достижимых клиентов меньше нескольких сотен: поговорите с ними и сгруппируйте вручную. Не берите, когда решение зависит от наблюдаемых признаков вроде размера компании или региона: деление по правилам дешевле, и по нему проще действовать. И не используйте его, чтобы ранжировать функции для одной аудитории: для этого хватит одного MaxDiff.
Частые ошибки
- Кластеризовать по демографии и называть результат сегментацией по потребностям. Потребности входят в модель, а демография появляется только при описании сегментов.
- Сначала делать факторный анализ, а потом кластеризовать факторные баллы. По данным Дольникар, Грюн и Лайша (2018), на четырёх наборах данных этот шаг отбросил от 46 до 53% вариации.
- Принимать за ответ первый запуск k-means. Разные случайные старты дают разные сегменты, поэтому делайте много запусков и оставляйте лучший.
- Выбирать k по одному графику. У локтя часто нет явного изгиба; сочетайте индексы качества с проверкой устойчивости и вопросом, достаточно ли велик каждый сегмент, чтобы с ним работать.
- Не делать инструмент распределения. Сегменты, которые живут только в презентации исследователей, нельзя ни таргетировать, ни измерять, ни продавать им.
Вопросы и ответы
Чем сегментация по потребностям отличается от демографической?
Демографическая сегментация группирует людей по видимым признакам: возрасту, доходу, размеру компании. Сегментация по потребностям группирует их по тому, что они хотят от продукта. Результаты часто расходятся: Тони Ульвик (Tony Ulwick) из Strategyn утверждает, что демографические признаки почти никогда не объясняют, почему у клиентов разные неудовлетворённые потребности. Демографию используют потом, чтобы описать каждый сегмент и достучаться до него.
Как выбрать число кластеров в сегментации?
Запустите анализ для набора значений k, обычно от 2 до 8, и сравните качество по графику локтя, индексу Калинского — Харабаша, силуэту, статистике разрыва (gap statistic) или BIC. Они нередко расходятся, поэтому добавьте проверку устойчивости: повторите анализ на пересобранных выборках и оставьте то k, чьи сегменты возвращаются. В конце проверьте, что каждый сегмент достаточно велик для работы.
Что лучше для сегментации: k-means или анализ латентных классов?
Анализ латентных классов обычно точнее. По симуляции Магидсона и Вермунта (2002), он неверно классифицировал 1,3% случаев против 8% у k-means. Он также работает со смешанными типами данных и даёт BIC для выбора k. K-means быстрее, его проще объяснить, и он есть в любом инструменте, поэтому для первого прохода он по-прежнему годится.
Какая выборка нужна для кластерного анализа?
Считайте от числа переменных, по которым кластеризуете. Симуляция Дольникар, Грюн, Лайша и Шмидт (2014) показала, что достаточно 70 респондентов на переменную; в их книге 2018 года рекомендовано не меньше 100. Для 20 потребностей это 1 400–2 000 респондентов. Нишевым сегментам, которые вам важны, нужно больше.
Нужно ли делать факторный анализ перед кластерным?
Обычно нет. Двухшаговый подход «факторы, затем кластеры» теряет информацию до того, как выделены сегменты, и, по данным Дольникар и Грюн (Journal of Travel Research, 2008), не обошёл кластеризацию исходных переменных даже на данных, построенных по факторной модели. Кластеризуйте исходные оценки потребностей, а пункты, которые дублируют друг друга, уберите до опроса.
Источники
- Girish Punj and David W. Stewart, Cluster Analysis in Marketing Research: Review and Suggestions for Application, Journal of Marketing Research 20(2), 1983
- Michel Wedel and Wagner A. Kamakura, Market Segmentation: Conceptual and Methodological Foundations, 2nd ed., Springer, 2000
- Sara Dolnicar, Bettina Grün and Friedrich Leisch, Market Segmentation Analysis: Understanding It, Doing It, and Making It Useful, Springer (open access), 2018
- Dolnicar, Grün and Leisch, Step 5: Extracting Segments, in Market Segmentation Analysis, 2018
- Sara Dolnicar, Bettina Grün, Friedrich Leisch and Kathrin Schmidt, Required Sample Sizes for Data-Driven Market Segmentation Analyses in Tourism, Journal of Travel Research 53(3), 2014
- Sara Dolnicar and Bettina Grün, Challenging Factor-Cluster Segmentation, Journal of Travel Research 47(1), 2008
- Russell I. Haley, Benefit Segmentation: A Decision-oriented Research Tool, Journal of Marketing 32(3), 1968
- J. MacQueen, Some Methods for Classification and Analysis of Multivariate Observations, Fifth Berkeley Symposium on Mathematical Statistics and Probability, 1967
- Joe H. Ward Jr., Hierarchical Grouping to Optimize an Objective Function, Journal of the American Statistical Association 58(301), 1963
- David Arthur and Sergei Vassilvitskii, k-means++: The Advantages of Careful Seeding, SODA 2007
- Douglas Steinley, K-means Clustering: A Half-Century Synthesis, British Journal of Mathematical and Statistical Psychology 59(1), 2006
- Jay Magidson and Jeroen K. Vermunt, Latent Class Models for Clustering: A Comparison with K-means, Canadian Journal of Marketing Research 20, 2002
- Jay Magidson and Jeroen K. Vermunt, A Nontechnical Introduction to Latent Class Models, Statistical Innovations
- Sawtooth Software, The MaxDiff System Technical Paper, Version 9, 2020
- Glenn W. Milligan and Martha C. Cooper, An Examination of Procedures for Determining the Number of Clusters in a Data Set, Psychometrika 50, 1985
- T. Caliński and J. Harabasz, A Dendrite Method for Cluster Analysis, Communications in Statistics 3(1), 1974
- StataCorp, Stata Multivariate Statistics Reference Manual: cluster stop
- Peter J. Rousseeuw, Silhouettes: A Graphical Aid to the Interpretation and Validation of Cluster Analysis, Journal of Computational and Applied Mathematics 20, 1987
- Robert Tibshirani, Guenther Walther and Trevor Hastie, Estimating the Number of Clusters in a Data Set via the Gap Statistic, Journal of the Royal Statistical Society B 63(2), 2001
- Gideon Schwarz, Estimating the Dimension of a Model, Annals of Statistics 6(2), 1978
- Lawrence Hubert and Phipps Arabie, Comparing Partitions, Journal of Classification 2, 1985
- Christian Hennig, Cluster-wise Assessment of Cluster Stability, Computational Statistics and Data Analysis 52(1), 2007
- Christian Hennig, fpc package reference manual (clusterboot), CRAN
- scikit-learn developers, Clustering: user guide
- Tony Ulwick, What Hidden Segments Exist in Your Market?, Strategyn
Обновлено 15 октября 2026

Маркетинговое агентство или система роста: что нужно на каждом этапе масштабирования
Агентство подходит, пока фаундер сам ведёт большую часть процессов. Когда бизнес начинает копировать себя в новые точки и регионы, нужна система, которая ставит цели, проверяет гипотезы и отвечает за результат.
Агентство медицинского маркетинга: почему работа с клиникой буксует и какую модель используем мы
Большинство агентств отвечают за клик, а за регистратуру не отвечает никто. Как мы строим маркетинг клиники в трёх горизонтах, на каких исследованиях это основано и что дал один год работы.
Тестирование рекламных каналов: почему тест затухает на третьем месяце
Большинство тестов нового рекламного канала заканчиваются не решением. Они заканчиваются, когда кончился бюджет, поменялась атрибуция или все тихо перестали открывать дашборд.