Сущности в SEO: что это и граф знаний
SEO сущностей — работа над тем, чтобы поисковик однозначно понимал, что такое ваш бренд, ваши люди и продукты, и связывал всё, что пишут о вас в сети, с одной известной ему записью в графе знаний.
Сущности в SEO — это подход, при котором бренд, людей и продукты описывают как отдельные, узнаваемые объекты, а не как набор ключевых слов. Поисковики хранят такие объекты в графе знаний; у Google он существует с 2012 года и содержит миллиарды сущностей. Помочь ему узнать вашу компанию можно единым названием везде, разметкой Organization со ссылками sameAs, справочными профилями вроде Wikidata и подтверждённой панелью знаний, если она есть.
- Автор
- Google (анонс: Амит Сингхал); идентификаторы дают словарь schema.org и Wikidata, 2012
- Уровень
- 301 · Продвинутый
- Подходит
- малый и средний бизнес, растущая компания
- Время на внедрение
- один день на аудит и разметку, затем несколько недель, пока устоятся внешние профили
- Что понадобится
- доступ на запись к шаблону главной страницы · юридическое название, регистрационный номер и список профилей, которыми вы управляете · аккаунт Google, через который можно подтвердить сайт в Search Console
SEO сущностей — это работа над тем, чтобы поисковик воспринимал ваш бренд, людей и продукты как отдельные объекты и мог связать любое упоминание о вас в сети с одной записью. Такие записи поисковик хранит в графе знаний: базе данных об объектах и связях между ними. Это термин практиков, а не продукт Google.
Почему поиск перешёл от строк к объектам
Google объявил о своём графе знаний 16 мая 2012 года в записи Амита Сингхала с заголовком «things, not strings» («объекты, а не строки»). На старте в нём было больше 500 миллионов объектов и 3,5 миллиарда фактов о них. В качестве примера взяли Тома Круза: его панель отвечает на 37 процентов следующих запросов, которые люди задают о нём. Первой решённой задачей стала неоднозначность: запрос «Taj Mahal» может означать и памятник, и музыканта, а граф помогает поиску понять, о чём речь. Среди открытых источников в записи названы Freebase, Wikipedia и CIA World Factbook, а на примере Марии Кюри показано, как появляется краткая сводка о рождении, образовании и открытиях.
С тех пор масштаб вырос. В записи Google 2020 года говорится о более чем 500 миллиардах фактов о пяти миллиардах сущностей: их берут из сотен веб-источников, лицензированных баз и структурированной разметки, которую публикуют владельцы сайтов. Научная статья Knowledge Vault (KDD 2014, Нью-Йорк, 24–27 августа) Xin Luna Dong и восьми соавторов из Google описывает, как факты, извлечённые из текстов, таблиц и структуры страниц, объединяются с уже накопленными знаниями и получают оценку вероятности того, что они верны. Freebase, один из источников 2012 года, работал с 2007 по 2015 год, сказано на архивной странице Google; архивный дамп примерно на 1,9 миллиарда фактов больше не поддерживается.
Ключевые даты по перечисленным источникам:
| Год | Событие | Источник |
|---|---|---|
| 2007–2015 | Freebase работает как проект с открытыми данными | Google for Developers |
| 2012 | Запуск Knowledge Graph: 500 миллионов объектов и 3,5 миллиарда фактов | Амит Сингхал, Google |
| 2014 | Статья Knowledge Vault представлена на KDD в Нью-Йорке | Dong et al., Google |
| 2020 | JSON-LD 1.1 становится рекомендацией W3C, 16 июля | W3C |
| 2020 | Google сообщает о более чем 500 миллиардах фактов о пяти миллиардах сущностей | Google, 20 мая |
Сущность — это отдельный, опознаваемый объект: компания, человек, продукт, место. В графе знаний у неё есть идентификатор, тип, атрибуты и связи с другими сущностями. Как такие графы работают с идентичностью, схемой и контекстом, разбирает обзор Хогана (Hogan) и 17 соавторов в ACM Computing Surveys 54(4), 2021.
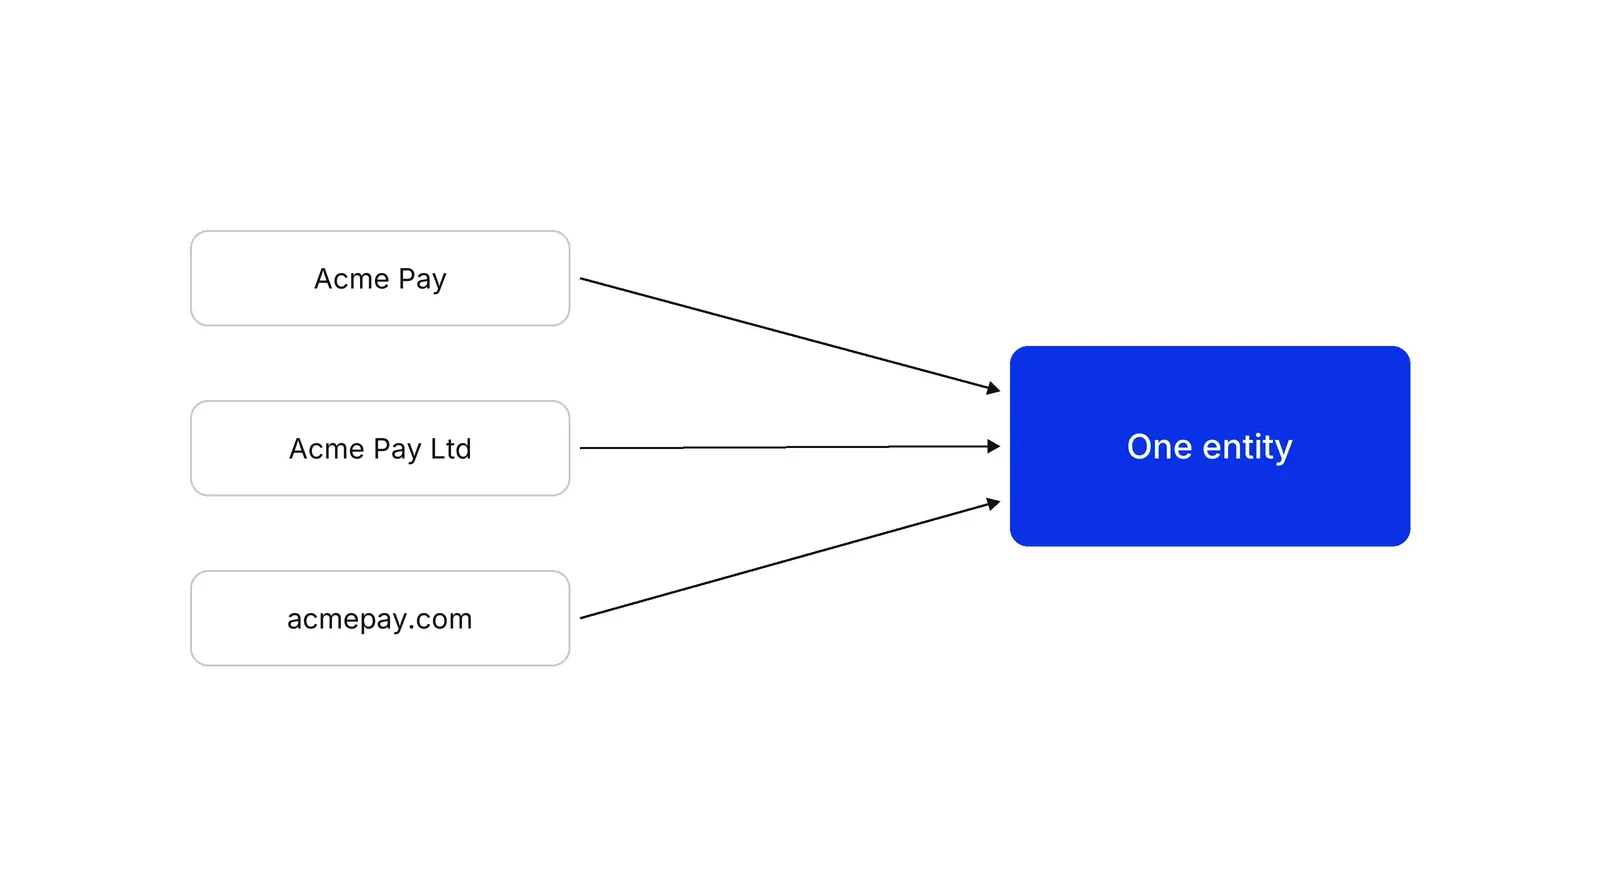
Как опознают сущности
Каждая система присваивает сущности свой идентификатор. В таблице три примера.
| Система | Кто ведёт | Идентификатор, который вы видите | Можно ли править? |
|---|---|---|---|
| Граф знаний Google | Машинный ID вроде kg:/m/0dl567 — пример для Тейлор Свифт в Search API |
Нет. Можно заявить права на часть панелей и отправить отзыв | |
| Wikidata | Сообщество Wikimedia | Номер Q, например Q42 для Дугласа Адамса | Да, если соблюдать правила значимости и подтверждения источниками |
| Разметка вашего сайта | Вы | url и @id в JSON-LD |
Да, полностью |
Ту же идею показывает Natural Language API Google: для известных сущностей, найденных в тексте, он может вернуть машинный ID графа знаний (mid) и ссылку на Wikipedia, а также тип вроде PERSON или LOCATION и оценку значимости (salience). Wikidata открыта. Её элемент о Дугласе Адамсе — Q42, это стандартный пример из её собственного введения. У каждого элемента есть номер Q, у каждого свойства — номер P (P69 означает «учился в»), данные опубликованы под лицензией CC0, а каждое утверждение должно иметь источник. Читать данные можно через Wikidata Query Service (SPARQL), MediaWiki Action API (до 50 сущностей за запрос) или полные дампы, как написано на странице о доступе к данным. По критерию значимости подходит элемент, у которого есть действующая ссылка на проект Wikimedia, который описывает чётко идентифицируемый объект с серьёзными публичными источниками или который закрывает структурную потребность.
Разметка — ваша реплика в разговоре
Структурированные данные Organization сообщают Google, кто вы, на вашей собственной странице. По документации Google, они помогают понять административные сведения об организации и отличить её от других. Рекомендованные поля — name, url, sameAs, logo (не меньше 112×112 пикселей) и legalName, плюс идентификаторы вроде iso6523Code: это код из международного обозначения схемы (International Code Designator) и самого идентификатора, где 0060 обозначает номер DUNS, 0088 — GLN, 0199 — LEI. Google на этой странице советует указывать iso6523Code, а не более старое поле leiCode по стандарту ISO 17442. Schema.org определяет те же поля, а ещё taxID, vatID, naics и globalLocationNumber, и добавляет parentOrganization и subOrganization для структуры групп компаний.
Основную нагрузку по идентификации несёт свойство sameAs. Schema.org определяет его как URL справочной страницы, однозначно указывающей на идентичность объекта; в примерах — Wikipedia, Wikidata и официальный сайт. Руководство Google добавляет, что это может быть профиль в соцсети или на площадке отзывов.
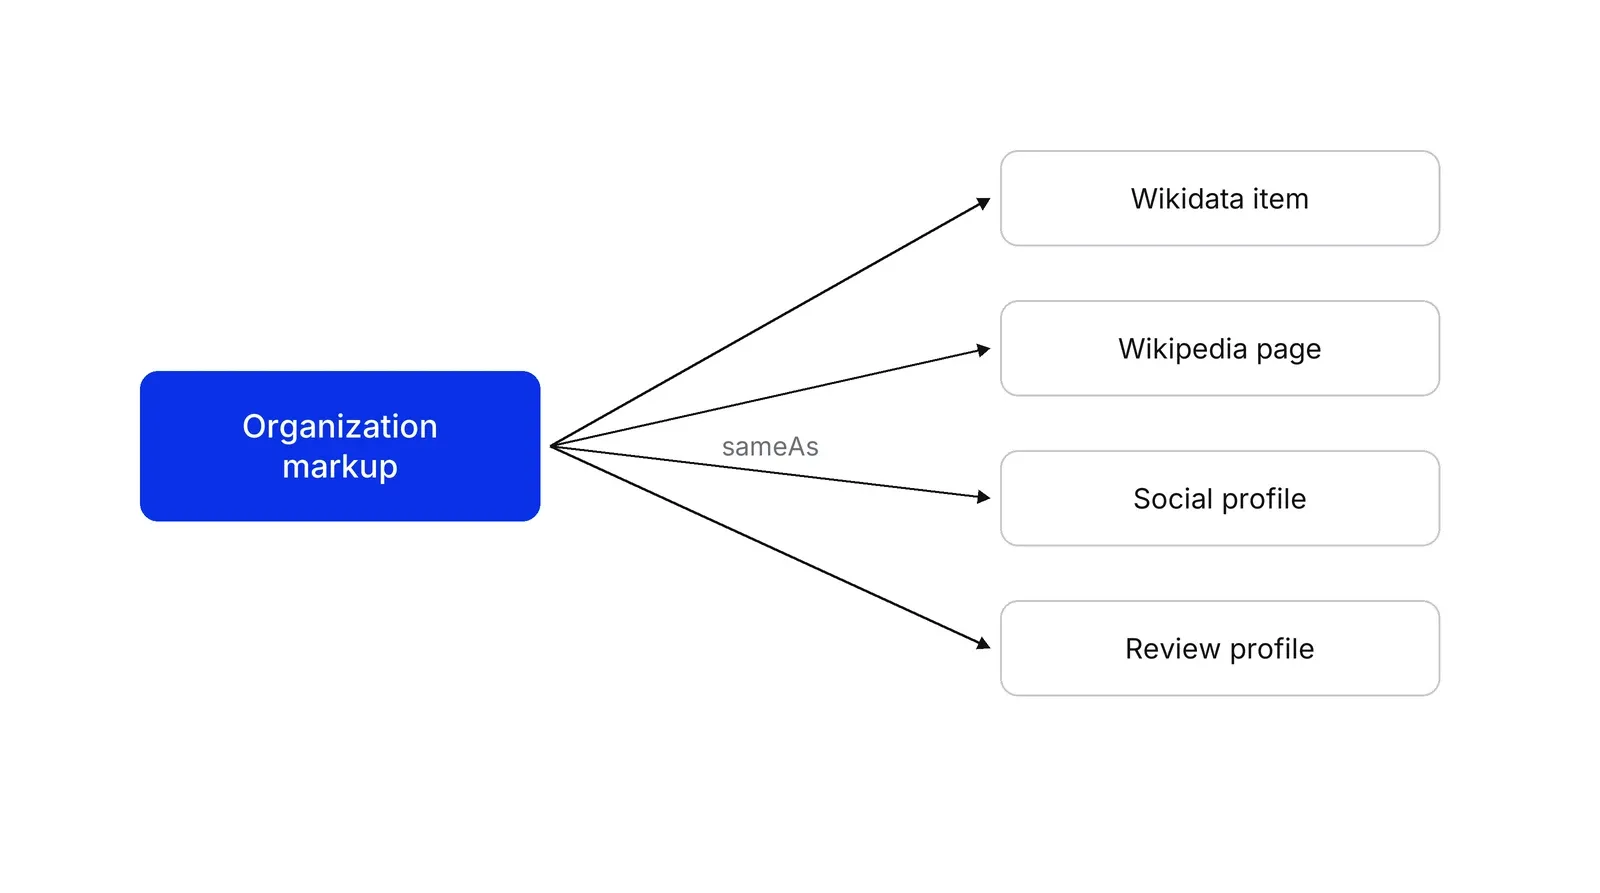
Помогают ещё два элемента. Google составляет название сайта из содержимого главной страницы и ссылок на неё, и самый большой вес имеет разметка WebSite с name и alternateName; Google советует везде писать название одинаково и повторять разметку на каждой дублирующей главной, например в версиях HTTP и HTTPS или с www и без. Для людей разметка ProfilePage указывает, о каком человеке или организации страница, и принимает sameAs; единственное обязательное свойство — mainEntity. Всё это записывают в JSON-LD, который Google рекомендует во введении в структурированные данные.
Панели знаний и что вы контролируете
Панель знаний — информационный блок, который Google показывает для сущности. Заявить права можно на многие панели. По справке Google, тот, о ком панель, должен найти себя в поиске, нажать «Claim this knowledge panel», если кнопка есть, и войти в официальный профиль, например YouTube или Search Console. Не каждую панель можно заявить, а подтверждение не даёт права править напрямую: изменения предлагают через обратную связь, со ссылками на страницы-подтверждения. Если панель уже подтвердил кто-то другой, Google пишет текущим владельцам, и если за 3 рабочих дня ответа нет, панель снова становится доступной для заявки. Владельцы и менеджеры могут добавлять пользователей, а участники (contributors) — только предлагать правки. Локальный бизнес управляет сведениями через профиль компании (Business Profile). Google также сообщает, что связи с Twitter и Facebook (принадлежит компании Meta, признанной экстремистской организацией и запрещённой в России) сохраняются автоматически.
По правилам Google, корректная разметка не гарантирует расширенного результата, а размечать нужно то, что видят читатели. Ни на одной странице Google, которую мы нашли, не сказано, что разметка сущностей поднимает позиции. Оценивайте работу по тому, правильно ли распознана сущность.
Проверьте, что Google уже о вас знает
Knowledge Graph Search API возвращает подходящие сущности в виде JSON-LD по schema.org: с названием, типами, описанием и оценкой совпадения. В справочнике REST перечислено 7 параметров: query, ids, languages, types, prefix, limit и indent. Типы — из schema.org, например Person, Organization и Place. API работает только на чтение, по умолчанию выдаёт 20 результатов (через limit — до 500), возвращает отдельные элементы EntitySearchResult, а не графы, и, по словам Google, не подходит для критичных производственных сервисов. Более новое место для этих возможностей — Enterprise Knowledge Graph: он умеет ещё и сводить воедино ваши собственные таблицы сущностей.
Работа с сущностями стоит рядом с E-E-A-T и техническим SEO: сначала идентичность, потом доказательства доверия, потом сайт, который можно сканировать. План Growth Lab начинается с карточки сущности, которая получается в результате этой работы.
Как применять: Сущности в SEO: что это и граф знаний по шагам
- Определитесь с одним названием и одним описанием. Запишите точное название бренда, альтернативные названия, юридическое название и описание в одно предложение. Везде, где можете, используйте именно эти формулировки. Результат: одностраничная карточка сущности, из которой все профили и страницы берут формулировки.
- Найдите себя как сущность. Введите название бренда в Google и посмотрите, появляется ли панель знаний и что в ней написано. Затем отправьте название в Knowledge Graph Search API с параметром `limit=5` и прочитайте тип, описание и идентификатор, если они вернутся. Результат: исходная точка для сравнения.
- Добавьте разметку Organization на главную. Опубликуйте JSON-LD с полями name, url, logo размером не меньше 112×112 пикселей, legalName и iso6523Code — например, номер DUNS с префиксом 0060. Добавьте разметку WebSite с name и alternateName для названия сайта. Результат: на вашей собственной странице машиночитаемо сказано, кто вы.
- Свяжите профили, которые подтверждают, что это вы. Перечислите в sameAs 3–5 официальных профилей: соцсети, площадки отзывов, реестры. Убедитесь, что в каждом указана та же компания и есть ссылка на ваш сайт. Результат: двусторонние ссылки, по которым машина может подтвердить совпадение.
- Создайте или исправьте справочные записи. Если вы проходите правила значимости Wikidata, создайте или поправьте свой элемент, подкрепив утверждения источниками. Заявите права на панель знаний и профиль компании, если вам это доступно, а об ошибочных фактах сообщайте через форму обратной связи со ссылками на подтверждения. Результат: справочные записи, совпадающие с вашей карточкой сущности.
- Проверяйте раз в 3 месяца. Повторите поиск, сравните панель знаний и ответ API с карточкой и исправьте расхождения в источнике. Результат: короткий журнал изменений.
Примеры
Платёжный стартап, у которого название совпало с чужим
Иллюстративный пример. Платёжная компания Acme Pay, лицензированная в двух странах, делит название с приложением лояльности. В выдаче по бренду результаты вперемешку. Команда публикует разметку Organization с юридическим названием, регистрационным идентификатором и ссылками sameAs на страницу в LinkedIn и запись в реестре лицензий, а название во всех профилях приводит к одному виду. Google панель не обещает, поэтому команда следит за результатами проверки сущности, а не за позициями.
Стоматологическая клиника с тремя адресами
Иллюстративный пример. У сети клиник один бренд и три адреса в двух городах. На главной странице сеть размечена как одна Organization, каждый из трёх филиалов — как LocalBusiness с адресом и часами работы на своей странице, а связь с головной организацией задана через parentOrganization. Каждый филиал заявил права на свой профиль компании. Результат: четыре корректно связанных объекта вместо трёх почти одинаковых названий.
Консалтинг, который продаётся под именем основательницы
Иллюстративный пример. Консалтинговая компания продаёт услуги под именем основательницы. На сайте появляется ProfilePage основательницы со ссылками sameAs на её биографии на конференциях и профессиональные профили. У человека тоже может быть панель знаний, на которую можно заявить права, поэтому основательница ищет кнопку заявки и, если та есть, подтверждает права через официальный профиль. Результат: человек и компания описаны согласованно и связаны разметкой.
Когда применять
Подходит, когда название вашего бренда носят другие объекты, когда поиск о вас ничего не показывает или когда факты о вас в поиске и в ответах ИИ неверны либо перепутаны с чужими.
Когда не применять
Не начинайте с этого, если сайт не сканируется, если настоящая проблема в качестве контента или если вы надеетесь, что разметка заставит Google показать панель знаний. Google пишет, что структурированные данные не гарантируют ни одной функции поиска.
Частые ошибки
- Считать панель знаний целью. Google собирает панели из многих источников и не описывает пути к ней ни за деньги, ни через одну только разметку.
- Разные названия. Бренд, юридическое название, имя аккаунта и домен отличаются от профиля к профилю, и машина не понимает, что речь об одном объекте.
- Ссылки sameAs на страницы, которые вас не идентифицируют. Ссылка на карточку другой компании добавляет шум.
- Разметка фактов, которых никто не видит. По правилам Google нельзя размечать то, чего нет в видимом читателю содержимом, а вводящая в заблуждение разметка может привести к ручным мерам.
- Создавать элемент Wikidata для бизнеса, который не проходит по критериям значимости. Элементы без источников могут удалить.
Вопросы и ответы
Что такое SEO сущностей?
Это оптимизация под объекты, а не под ключевые слова: бренд, людей и продукты описывают так, чтобы поисковик мог сопоставить их с одной записью в своём графе знаний. На практике это единое название везде, структурированные данные Organization, ссылки sameAs на справочные профили и точные записи у третьих сторон.
Что такое граф знаний Google?
Это база данных Google о реальных объектах и связях между ними. Google объявил о нём 16 мая 2012 года, а о его росте рассказал 20 мая 2020 года. На графе построены панели знаний, и он помогает поиску различать объекты с одинаковым названием.
Как получить панель знаний?
Запросить её напрямую нельзя. Google создаёт панели из источников, которым доверяет, и заявить права можно не на все. Если панель о вас уже есть, найдите кнопку Claim this knowledge panel и подтвердите права через официальный профиль, например YouTube или Search Console. Локальный бизнес управляет данными через профиль компании (Business Profile).
Улучшает ли разметка sameAs позиции в выдаче?
В документации Google sameAs описан как указатель на другие страницы с информацией об организации, а влияние на ранжирование не заявлено. Заявленная цель — помочь Google отличить вашу организацию от других. Относитесь к ней как к данным об идентичности.
Нужен ли элемент в Wikidata?
Только если вы подходите хотя бы под один из трёх критериев значимости: действующая ссылка на проект Wikimedia, чётко идентифицируемый объект, описанный в серьёзных публичных источниках, или структурная необходимость. Кроме того, каждое утверждение должно иметь источник. Ни в одном источнике не сказано, что Google требует такой элемент.
Источники
- Google, The Keyword, Amit Singhal, Introducing the Knowledge Graph: things, not strings, May 16, 2012
- Google, The Keyword, A reintroduction to our Knowledge Graph and knowledge panels, May 20, 2020
- Google Search Central, Organization structured data
- Google Search Central, Introduction to structured data markup
- Google Search Central, General structured data guidelines
- Google Search Central, Site names in Google Search
- Google Search Central, Profile page structured data
- Google Search Central, Local business structured data
- Google for Developers, Knowledge Graph Search API
- Google for Developers, Knowledge Graph Search API REST reference (entities.search)
- Google Cloud, Enterprise Knowledge Graph overview
- Google Cloud, Natural Language API, Analyzing entities
- Google Knowledge Panel Help, Get verified on Google
- Google for Developers, Freebase data dumps
- Dong et al., Knowledge Vault: A Web-Scale Approach to Probabilistic Knowledge Fusion, KDD 2014
- Hogan et al., Knowledge Graphs, ACM Computing Surveys 54(4), 2021
- Schema.org, sameAs property
- Schema.org, Organization type
- Schema.org, Data model
- W3C, JSON-LD 1.1, Recommendation of July 16, 2020
- Wikidata, Introduction
- Wikidata, Notability policy
- Wikidata, Verifiability policy
- Wikidata, Data access
Обновлено 15 октября 2026

Маркетинг в финтехе: где реклама упирается в комплаенс, KYC и лицензии
Агентство может собрать кампании. Но проверку рекламных обещаний, отвал на KYC и лицензионные правила разных рынков оно не контролирует, а именно они решают, станет ли лид клиентом.
Аудит маркетинга: чек-лист из 24 вопросов, который мы проходим в первую неделю
24 вопроса в пяти блоках, у каждого — чёткое условие зачёта. По этому чек-листу команда маркетинга оценит свою операционную часть до того, как звать помощь со стороны.
Директор по маркетингу на аутсорсе: что он даёт и что должно работать под ним
Приходящий директор по маркетингу приносит стратегию и опыт. Без отчётности, порядка в CRM и владельца у каждой цифры результатом его работы станет презентация, а не система.