ICE-приоритизация: метод и пример расчёта
ICE-скоринг оценивает каждую идею роста по влиянию, уверенности и простоте, чтобы команда за несколько минут решила, какой эксперимент запускать первым.
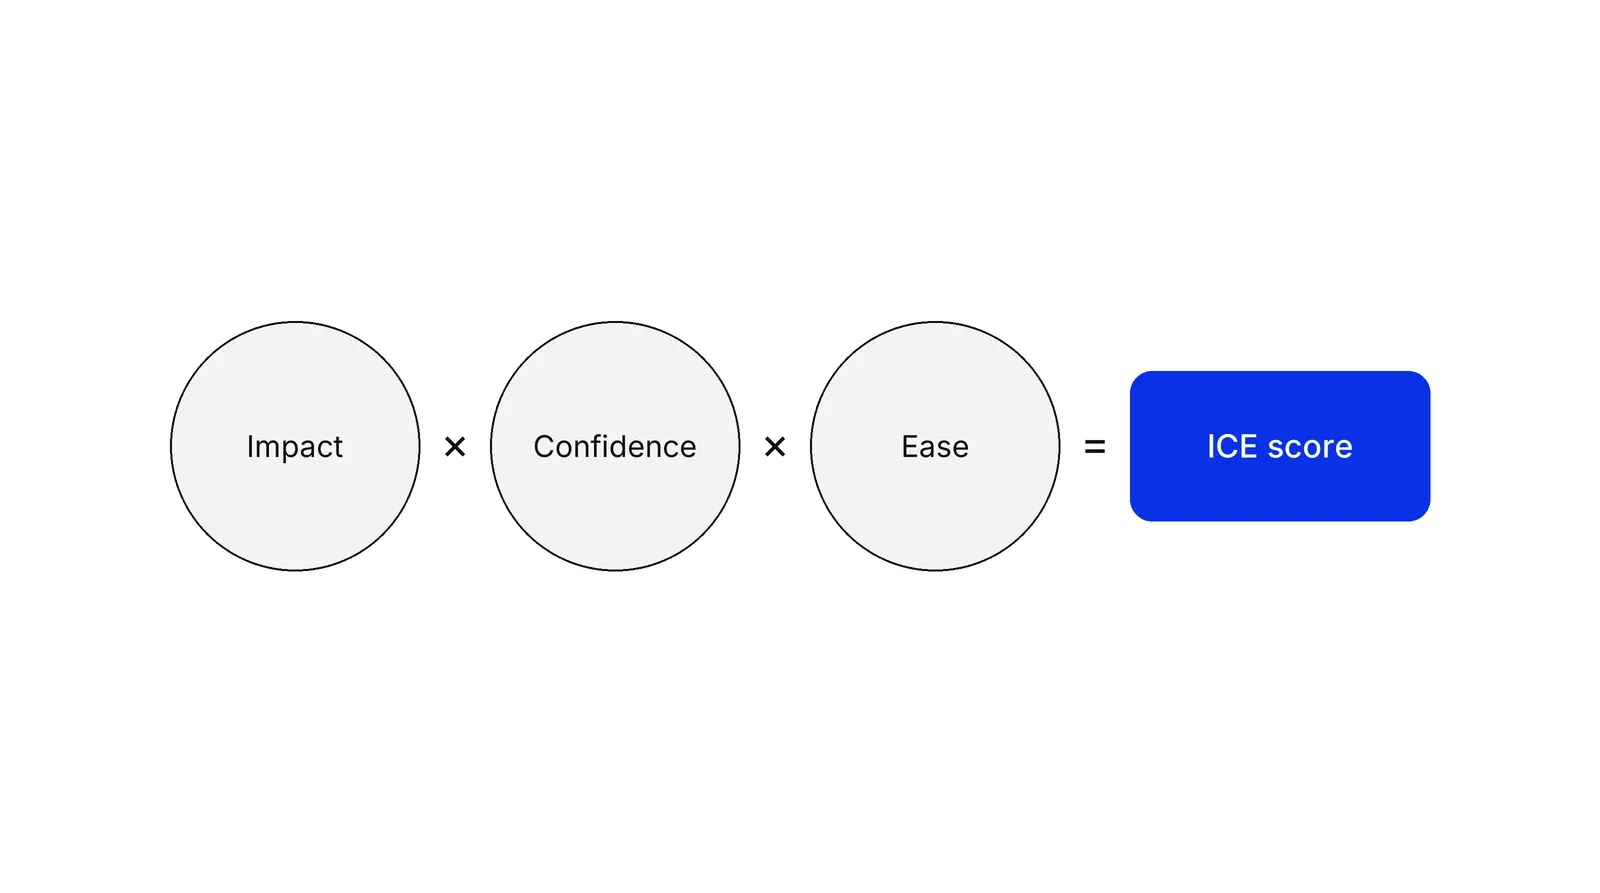
ICE-скоринг — метод приоритизации, где каждая идея получает оценку от 1 до 10 по трём вопросам: насколько она сдвинет целевую метрику (impact), насколько команда уверена в этой оценке (confidence) и как мало работы она требует (ease). Оценки сводят в один балл, и по нему выстраивают очередь экспериментов. Метод приписывают Шону Эллису из GrowthHackers.
- Автор
- Шон Эллис (приписывается); Итамар Гилад (Confidence Meter), 2010-е, датированный оригинал не найден; Confidence Meter, 2018
- Уровень
- 201 · Инструмент
- Подходит
- стартап, малый и средний бизнес, растущая компания
- Время на внедрение
- около часа на первый бэклог из 20–30 идей, затем несколько минут на каждую новую идею
- Что понадобится
- одна целевая метрика, по которой оценивается весь бэклог · письменный список идей, каждая сформулирована как проверяемое изменение · инженер или исполнитель, который может оценить трудозатраты · всё, что у вас уже есть из доказательств: аналитика, интервью, результаты прошлых тестов
ICE-скоринг — способ выстроить список идей по очереди, задав о каждой три вопроса. Насколько она сдвинет целевую метрику, если сработает? Насколько мы в этом уверены? Сколько работы она потребует? Каждый ответ становится оценкой, обычно от 1 до 10, а оценки сводятся в один балл. Команда сначала проверяет идеи с самым высоким баллом.
Метод пришёл из growth-маркетинга. Итамар Гилад, бывший руководитель продукта в Google, называет автором Шона Эллиса, придумавшего ICE для ранжирования экспериментов роста; то же пишет Lenny’s Newsletter. Эллис ввёл термин growth hacking и в 2017 году вместе с Морганом Брауном написал Hacking Growth, книгу о тестировании в быстром темпе. Датированного оригинального поста GrowthHackers, где определён ICE, мы не нашли, поэтому год его появления не задокументирован. Сегодня метод встречается в открытых источниках вроде шаблона экспериментов GitLab и руководств Atlassian по Jira.
Что значат impact, confidence и ease
Impact — насколько идея сдвинет целевую метрику, если сработает. Confidence — сколько доказательств стоит за оценкой влияния. Ease — обратная сторона трудозатрат: изменение, которое один человек выпускает за день, получает высокую оценку, проект на квартал — низкую. По Гиладу, все три — относительные оценки: каждая команда сама решает, что значат числа, лишь бы их смысл со временем не менялся.
Шкала работает, только когда у неё есть опорные точки. Возьмём клинику, которой нужно больше записей на первичный приём в неделю. Impact 10 может значить «вероятно, даёт на 20% больше записей», impact 5 — «около 5%», impact 1 — «почти незаметно». Ease 10 — «меньше дня работы», ease 1 — «больше месяца». Без таких опор два человека могут поставить одной идее 3 и 8 и оба будут честны.
Умножать или усреднять
Команды делают и так и так, а ранжирование от выбора меняется. Гилад умножает три оценки, как и правило автоматизации Atlassian для Jira. В шаблоне GitLab балл равен среднему трёх оценок; в одной из его задач с экспериментом стояли 7, 8 и 9, а записан балл 8.
| Идея | Impact | Confidence | Ease | Среднее | Произведение |
|---|---|---|---|---|---|
| A | 9 | 9 | 1 | 6,3 | 81 |
| B | 5 | 5 | 5 | 5,0 | 125 |
По среднему первой идёт идея A. По произведению первой идёт идея B, потому что одна очень низкая оценка тянет вниз весь балл. Умножение подойдёт команде, которая хочет отсеивать идеи с одним серьёзным изъяном, например крупный выигрыш за полгода работы. Среднее мягче, и его проще объяснить. Любой способ защитим, если команда применяет один и тот же всегда.
Почему сложнее всего оценить confidence
Большинство идей не работает, а те, кто их предлагает, плохо угадывают, какие сработают. Рон Кохави с коллегами сообщили, что в Microsoft лишь около трети идей улучшили метрики, ради которых их затевали. В статье Harvard Business Review 2017 года Кохави и Стефан Томке оценили долю экспериментов с положительным результатом в Google и Bing всего в 10–20%.
Поэтому confidence, взятый из интуиции автора, окажется завышенным у большинства идей. Ответ Гилада — Confidence Meter, шкала от 0 до 10, где балл зависит от типа доказательств. Личная убеждённость, презентация, совпадение со стратегией и чужие мнения стоят около нуля. Дальше идут оценки и планы, потом отдельные свидетельства вроде нескольких запросов от продаж. Рыночные данные и прямые данные о клиентах, такие как интервью и MVP, лежат в середине. Результаты тестов и данные после запуска оцениваются выше всего.
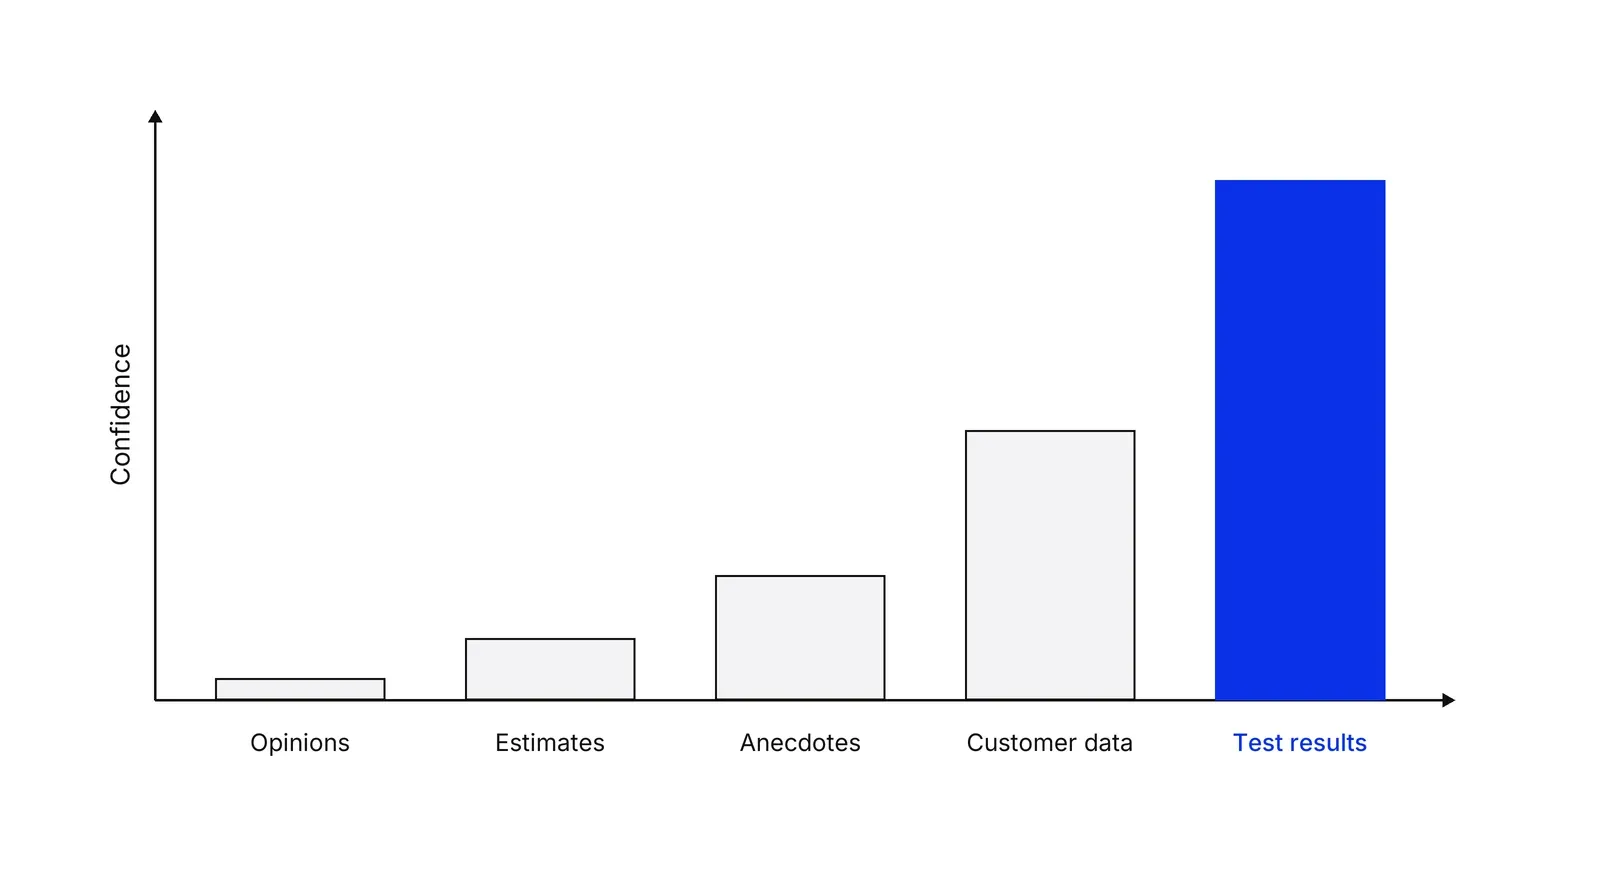
Это снижает и шум между оценщиками. Даниэль Канеман с соавторами показал в Harvard Business Review, что профессионалы, работающие по одним правилам, могут вынести очень разные суждения об одном и том же случае. Если привязать confidence к фиксированному списку типов доказательств, разброс сужается.
Почему ease обычно завышают
Люди недооценивают, сколько времени займёт их собственная работа. В исследовании, опубликованном в 1994 году, Роджер Бюлер с коллегами просили студентов предсказать, когда они закончат дипломные работы. Среднее предсказание — 33,9 дня, средний фактический срок — 55,5 дня. В выборке из 1471 IT-проекта Бент Фливбьерг и Александр Будзир обнаружили, что каждый шестой превысил бюджет в среднем примерно на 200%.
Помогают две привычки. Пусть ease оценивает тот, кто будет делать работу, как этого требует шаблон GitLab от инженеров. И оценивайте ease диапазонами дней, а не ощущением «просто» или «сложно».
ICE в сравнении с RICE, PIE и WSJF
ICE — самый лёгкий из распространённых методов скоринга. Остальные добавляют фактор или меняют один из них.
| Метод | Факторы | Для чего лучше всего |
|---|---|---|
| ICE | Impact, confidence, ease, каждый от 1 до 10 | Быстрое ранжирование небольших тестов роста |
| RICE | Reach × impact × confidence ÷ effort | Функции продукта, которые затрагивают очень разное число пользователей |
| PIE | Potential, importance, ease | Выбор страниц сайта, которые тестировать первыми |
| WSJF | Cost of delay ÷ job size | Крупные задачи, где важны сроки |
В RICE, который Шон Макбрайд опубликовал в Intercom в 2016 году, охват считают числом людей за период, confidence задают как 100%, 80% или 50%, а трудозатраты берут в человеко-месяцах. PIE Криса Гоуарда ранжирует страницы по тому, сколько у них места для улучшения, насколько ценен их трафик и как легко их тестировать. WSJF из Scaled Agile Framework делит стоимость задержки на размер работы. А если трудный вопрос — что поместится до жёсткого срока, лучше любого балла ответит приоритизация MoSCoW.
Где ICE стоит в процессе роста
ICE задаёт порядок тестов, а вокруг него должен работать цикл тестирования. В HADI-цикле он стоит между гипотезой и действием: команда пишет гипотезы, оценивает их, запускает несколько лучших и возвращает результаты в колонку confidence. Пересчёт после каждого цикла, а не раз в квартал, удерживает ранжирование честным, и именно в таком ритме работает Growth Lab.
Как применять: ICE-приоритизация: метод и пример расчёта по шагам
- Зафиксируйте целевую метрику и шкалы. Выберите одну метрику, которую идеи должны сдвинуть, например число активированных аккаунтов в неделю. Затем запишите, что значат 1, 5 и 10 по каждой букве: impact относительно этой метрики, ease в примерных человеко-днях. Результат: одностраничный ключ оценок, благодаря которому семёрка через месяц значит то же самое.
- Запишите каждую идею как тест. Превратите каждую идею в изменение, ожидаемый эффект и способ его измерить. «Улучшить онбординг» оценить нельзя, а «сократить форму регистрации с девяти полей до четырёх, чтобы выросла доля завершивших» — можно. Результат: бэклог идей, достаточно конкретных для оценки.
- Оцените impact и ease отдельно, потом сравните. Каждый оценивает один, до всякого обсуждения, а ease ставит тот, кто ближе всех к работе. Шаблон экспериментов GitLab по той же причине просит инженеров заполнять колонку ease. Результат: набор независимых оценок, где сильные расхождения отмечены для короткого разговора.
- Ставьте confidence по доказательствам, а не по настроению. Спросите, что подтверждает оценку влияния. Догадка, слайд или мнение руководителя почти ничего не стоят; данные о клиентах и результаты тестов дают большую часть шкалы. Готовую лестницу даёт Confidence Meter Итамара Гилада. Результат: число confidence, которое команда может защитить, указав на доказательства.
- Сведите оценки, отранжируйте и выберите несколько лучших. Перемножьте три оценки или усредните их и отсортируйте бэклог. Выберите один способ и держитесь его: два способа могут расставить те же идеи по-разному. Результат: ранжированный список и решение о следующих двух-трёх тестах.
- Пересчитывайте оценки после каждого результата. Когда тест завершён, обновите confidence у связанных идей и уберите те, что результат опроверг. Результат: бэклог, который с каждым циклом становится точнее, а не ранжирование, застывшее в первый день.
Примеры
Шаблон экспериментов GitLab
GitLab ведёт продуктовые эксперименты в открытых задачах, а в его шаблоне Experiment Idea есть таблица ICE, где балл равен среднему трёх оценок. Заполнить ease просят инженеров, и пока не заполнены все три значения, у задачи висит метка «ICE Score Needed». В одной задаче 2022 года предлагали перенести пункт Pages из настроек в меню деплоя: impact 7, confidence 8, ease 9, среднее 8. В тесте сравнивали число открытий страницы у двух групп одинакового размера.
Недооценённая идея с заголовками в Bing
Рон Кохави и Стефан Томке в Harvard Business Review описывают предложение сотрудника Bing 2012 года изменить показ заголовков рекламы. На него требовалось несколько дней инженерной работы, но менеджеры программ сочли его малоприоритетным, и оно пролежало больше полугода. Когда инженер наконец проверил идею, выручка выросла на 12%, то есть больше чем на $100 миллионов в год в США. В терминах ICE простота была очевидна, а влияние сильно занижено — это довод в пользу дешёвых тестов на простых идеях.
Платёжное приложение оценивает три идеи
Иллюстративный пример, реальной компании нет. Приложение для международных платежей оценивает три идеи по шкале от 1 до 10, а для confidence берёт лестницу доказательств Гилада. Мгновенные выплаты на карты: impact 8, ease 3, доказательства — два запроса от продаж, значит confidence 1, балл 24. Показ полной комиссии до ввода суммы: impact 5, ease 8, доказательства — 20 интервью с пользователями и юзабилити-тест, значит confidence 3, балл 120. Больший бонус за приглашение: impact 6, ease 9, доказательство — мнение команды, значит confidence 0,2, балл около 11. Первой идёт правка с комиссией.
Когда применять
Используйте ICE, когда у команды роста или продукта идей больше, чем она может проверить, и нужен быстрый общий способ выбрать несколько следующих. Метод подходит для недельных и двухнедельных циклов тестирования, для ранних компаний, у которых нет данных для более полной модели, и для любого бэклога, где идеи небольшие и неверный выбор стоит дней, а не кварталов.
Когда не применять
Не берите его для крупных дорогих ставок: выход на новый рынок, перестройка платформы, регулируемый запуск. Там балл из трёх чисел скрывает слишком многое, лучше бизнес-кейс, стоимость задержки или более полная модель. Он плохо подходит и тогда, когда идеи затрагивают очень разное число пользователей: RICE справляется с этим, оценивая охват отдельно.
Частые ошибки
- Позволять автору идеи ставить confidence в одиночку: тогда confidence измеряет энтузиазм.
- Менять смысл чисел от месяца к месяцу, из-за чего старые и новые баллы нельзя сравнивать.
- Смешивать способы: одни идеи умножать, другие усреднять. Бэклог переставляется без всякой причины.
- Считать балл решением. Две идеи с 6,2 и 6,0 — это ничья, и думать всё равно придётся команде.
- Никогда не пересчитывать оценки после теста, так что бэклог продолжает ранжировать идеи по доказательствам, которые команда уже заменила.
Вопросы и ответы
Что означает ICE?
ICE — это impact, confidence и ease, то есть влияние, уверенность и простота. Impact — насколько идея сдвинет целевую метрику, если сработает. Confidence — насколько команда уверена в этом влиянии. Ease — как мало времени и усилий она требует. Каждый показатель обычно оценивают от 1 до 10, а три оценки сводят в один балл.
Чем ICE отличается от RICE?
RICE добавляет охват (reach) и заменяет ease на трудозатраты. В RICE от Intercom охват, влияние и уверенность перемножают, а затем делят на трудозатраты в человеко-месяцах, причём уверенность задают в процентах. В ICE охват входит в impact, и всё оценивается по одной шкале от 1 до 10. Приоритизация RICE занимает больше времени, зато отдельно показывает, скольких людей затрагивает идея и что она меняет для каждого из них.
Баллы ICE нужно умножать или усреднять?
Используют оба способа. Итамар Гилад и руководство Atlassian по автоматизации Jira умножают; шаблон экспериментов GitLab усредняет. Умножение наказывает идею, у которой низкая оценка по любой из букв: идея с оценками 9, 9 и 1 окажется ниже идеи с 5, 5 и 5. Среднее позволяет сильной оценке скрыть слабую. Выберите один способ и держитесь его.
Как оценивать confidence в ICE?
Опирайтесь на доказательства, а не на то, как сильно люди чувствуют. Confidence Meter Итамара Гилада оценивает доказательства по шкале от 0 до 10: личная убеждённость, презентации и чужие мнения стоят около нуля, оценки и случаи из практики дают мало, рыночные данные и свидетельства клиентов стоят посередине, а результаты тестов и запуска — выше всего.
Кто придумал ICE-скоринг?
Метод приписывают Шону Эллису, который ввёл термин growth hacking и основал GrowthHackers; сначала его применяли, чтобы ранжировать эксперименты роста. Датированного оригинального поста, где ICE определён, мы не нашли, поэтому точный год и исходная формула Эллиса не задокументированы. Позже Итамар Гилад добавил Confidence Meter для оценки confidence.
Источники
- Itamar Gilad, Product discovery with ICE and the Confidence Meter
- Itamar Gilad, Confidence Meter calculator
- Itamar Gilad, Evidence-Guided: Creating High-Impact Products in the Face of Uncertainty
- Penguin Random House, Hacking Growth by Sean Ellis and Morgan Brown (2017)
- Lenny's Newsletter, The original growth hacker: Sean Ellis (2024)
- GitLab, Experiment Idea issue template
- GitLab, Move Pages menu entry under Deploy (experiment issue 373547)
- GitLab, Geo failover container registry migration (experiment issue 458448)
- Atlassian, How to create a rule that calculates ICE score and prioritizes tickets
- Atlassian, Jira Product Discovery fields reference
- Kohavi, Crook, Longbotham et al., Online Experimentation at Microsoft (2009)
- Harvard Business Review, Kohavi and Thomke, The Surprising Power of Online Experiments (2017)
- Cambridge University Press, Kohavi, Tang and Xu, Trustworthy Online Controlled Experiments (2020)
- Harvard Business Review, Thomke, Building a Culture of Experimentation (2020)
- Harvard Business Review, Kahneman, Rosenfield, Gandhi and Blaser, Noise (2016)
- Harvard Business Review, Schoemaker and Tetlock, Superforecasting: How to Upgrade Your Company's Judgment (2016)
- Journal of Personality and Social Psychology, Buehler, Griffin and Ross, Exploring the planning fallacy (1994)
- Flyvbjerg and Budzier, Why Your IT Project May Be Riskier Than You Think (Harvard Business Review, 2011; arXiv)
- Harvard Business Review, Lovallo and Kahneman, Delusions of Success (2003)
- Intercom, RICE: Simple prioritization for product managers
- Scaled Agile Framework, Weighted Shortest Job First
- Practical Ecommerce, Chris Goward, Use the PIE Method to Prioritize Ecommerce Tests (2013)
Обновлено 15 октября 2026

Маркетинговое агентство или система роста: что нужно на каждом этапе масштабирования
Агентство подходит, пока фаундер сам ведёт большую часть процессов. Когда бизнес начинает копировать себя в новые точки и регионы, нужна система, которая ставит цели, проверяет гипотезы и отвечает за результат.
Агентство медицинского маркетинга: почему работа с клиникой буксует и какую модель используем мы
Большинство агентств отвечают за клик, а за регистратуру не отвечает никто. Как мы строим маркетинг клиники в трёх горизонтах, на каких исследованиях это основано и что дал один год работы.
Тестирование рекламных каналов: почему тест затухает на третьем месяце
Большинство тестов нового рекламного канала заканчиваются не решением. Они заканчиваются, когда кончился бюджет, поменялась атрибуция или все тихо перестали открывать дашборд.