Программа экспериментов в маркетинге: что это и как выстроить
Программа экспериментов — это набор метрик, инструментов, проверок достоверности и ролей в команде, который позволяет запускать десятки A/B-тестов в месяц и опираться на результаты, которым можно верить.
Программа экспериментов в маркетинге — это операционная система вокруг A/B-тестирования в больших масштабах. В ней одна согласованная метрика успеха (OEC), защитные метрики, которые не должны ухудшаться, автоматические проверки достоверности вроде перекоса выборки (SRM) и понятные владельцы запуска и разбора тестов. Рон Кохави, Диана Тан и Я Сюй описывают четыре фазы, через которые компании строят такую программу: ползём, идём, бежим, летим (crawl, walk, run, fly).
- Автор
- Рон Кохави, Диана Тан и Я Сюй (книга); Александр Фабиян и коллеги (модель crawl, walk, run, fly); Кохави и Стефан Томке (HBR), с 2017 по 2020
- Уровень
- 301 · Продвинутый
- Подходит
- растущая компания
- Время на внедрение
- месяц, чтобы согласовать OEC и провести первые достоверные тесты; год и больше, чтобы выйти на фазу run
- Что понадобится
- тысячи пользователей или сессий в неделю на продукте, который вы хотите тестировать · логирование событий, которое сможет прочитать человек не из команды фичи · аналитик, который разбирается в рандомизации, доверительных интервалах и A/A-тестах · руководитель, готовый принять результат теста, который противоречит его мнению
Программа экспериментов — это набор метрик, инструментов, проверок и ролей, благодаря которому компания запускает много A/B-тестов одновременно и действует по их результатам, не споря о них. Стандартный источник — книга Trustworthy Online Controlled Experiments (Cambridge University Press, 2020) Рона Кохави, Дианы Тан и Я Сюй, которые строили системы тестирования в Microsoft, Google и LinkedIn. Проблему они формулируют так: получить цифры легко, получить цифры, которым можно верить, трудно.
Одному A/B-тесту нужен аналитик. Тридцати тестам в месяц нужна система: иначе команды начнут выкатывать изменения по результатам, которые сломаны, противоречат друг другу или подобраны под нужный ответ.
Почему одного теста за раз мало
Большинство идей не работает, поэтому компании приходится проверять много идей, чтобы найти те немногие, что сработают. Кохави и Стефан Томке сообщили в Harvard Business Review в 2017 году, что примерно треть экспериментов Microsoft улучшила целевую метрику, треть оказалась нейтральной, а треть её ухудшила. В Google и Bing положительными были только от 10 до 20% тестов. В той же статье сказано, что каждая из компаний — Microsoft, Amazon, Booking.com, Facebook (принадлежит компании Meta, признанной экстремистской организацией и запрещённой в России) и Google — проводила больше 10 000 контролируемых экспериментов в год.
Отдача приходит с объёмом. Самый известный случай авторов — смена заголовков объявлений в Bing: изменение полгода лежало несделанным, а когда его наконец протестировали, выручка выросла на 12%. Вывод они делают в первой главе книги: накладные расходы на запуск эксперимента должны быть малы, иначе хорошие идеи так и не будут испытаны.
Книга называет три условия, без которых программа не заработает. Компания хочет принимать решения на данных и имеет формальный OEC. Она готова вкладываться в инфраструктуру и в проверки, делающие результаты достоверными. И она признаёт, что плохо оценивает идеи заранее.
Четыре фазы зрелости: crawl, walk, run, fly
Программа растёт фазами, и если пропустить одну, пробел обнаружится на следующей. Четыре фазы описали Александр Фабиян, Павел Дмитриев, Хелена Хольмстрём Ульссон и Ян Бош в статье для ICSE 2017 на опыте Microsoft, и с той же модели начинается четвёртая глава книги.
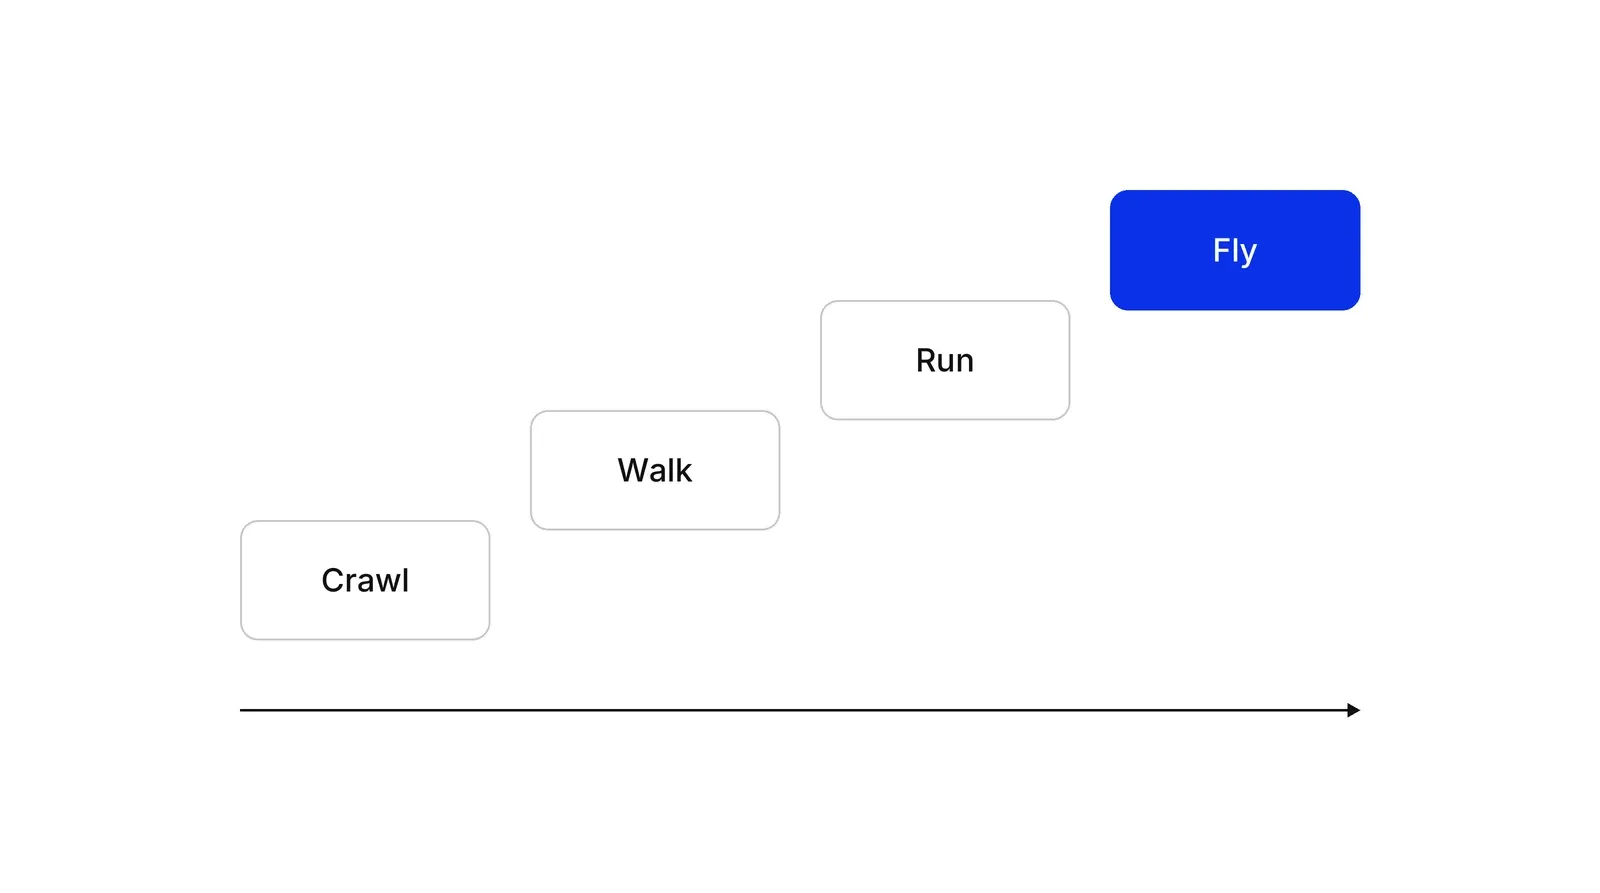
| Фаза | Что строят | Кто запускает тесты | Состояние OEC |
|---|---|---|---|
| Crawl («ползём») | Читаемое логирование событий; первые тесты вручную, платформы ещё нет | Команда по работе с данными | Первая версия из нескольких ключевых сигналов |
| Walk («идём») | Метрики из событий; платформа с расчётом мощности и A/A-тестами | Продакт-менеджеры настраивают тесты, аналитики запускают | Метрики успеха, защитные метрики и метрики качества данных |
| Run («бежим») | Оповещения, постепенное расширение с малой доли трафика, защита от эффектов переноса | Продуктовые команды запускают свои тесты, аналитики проверяют | Доведён до одной взвешенной метрики |
| Fly («летим») | Автоматическая остановка вредных тестов, поиск взаимодействий между тестами, журнал экспериментов с поиском | Продуктовые команды, центральная проверка по запросу | Стабилен, меняется примерно раз в год |
Переход к фазе run в статье относят примерно к 100 экспериментам в год — к точке, где ручная проверка перестаёт справляться. На фазе fly одновременно идут тысячи тестов, и через тест выходит почти любое изменение, вплоть до исправления ошибок.
OEC: одно число, по которому судят каждый тест
Overall evaluation criterion (OEC) — количественный показатель, по которому оценивают каждый эксперимент. Он должен меняться за тест длиной в одну-две недели и предсказывать долгосрочный успех. Без него каждая команда выбирает метрику, по которой её тест выглядит лучше.
Выбор OEC не обходится без споров. Долгосрочные цели Bing — доля запросов и доход от рекламы, но ухудшение поисковой выдачи на какое-то время подняло бы обе: пользователи ищут повторно и чаще кликают по рекламе. Руководители Bing остановились на другом: меньше запросов на задачу и больше задач на пользователя, сообщает HBR. Прибыль в роли OEC книга исключает по той же причине: повышение цен поднимет её в этом квартале и лишит клиентов в следующем году.
В статье 2019 года по итогам саммита, где собрались 34 эксперта из компаний, среди которых Airbnb, Google, Netflix и Uber, названы четыре свойства хорошего OEC: он предсказывает долгосрочные результаты, его трудно «накрутить», он достаточно чувствителен, чтобы сдвинуться в обычном тесте, и его дёшево считать. Кохави и Томке рекомендуют корректировать его раз в год.
Защитные метрики и проверки достоверности
Защитные метрики (guardrails) — показатели, которые тест не пытается улучшить, но которым не должен навредить. В статье Алекса Дэна и Сяолинь Ши для KDD 2016 типичными примерами названы выручка на пользователя и задержка загрузки страницы. Проверки достоверности стоят на уровень ниже: они выясняют, сработал ли сам эксперимент, прежде чем кто-то читает его итог.
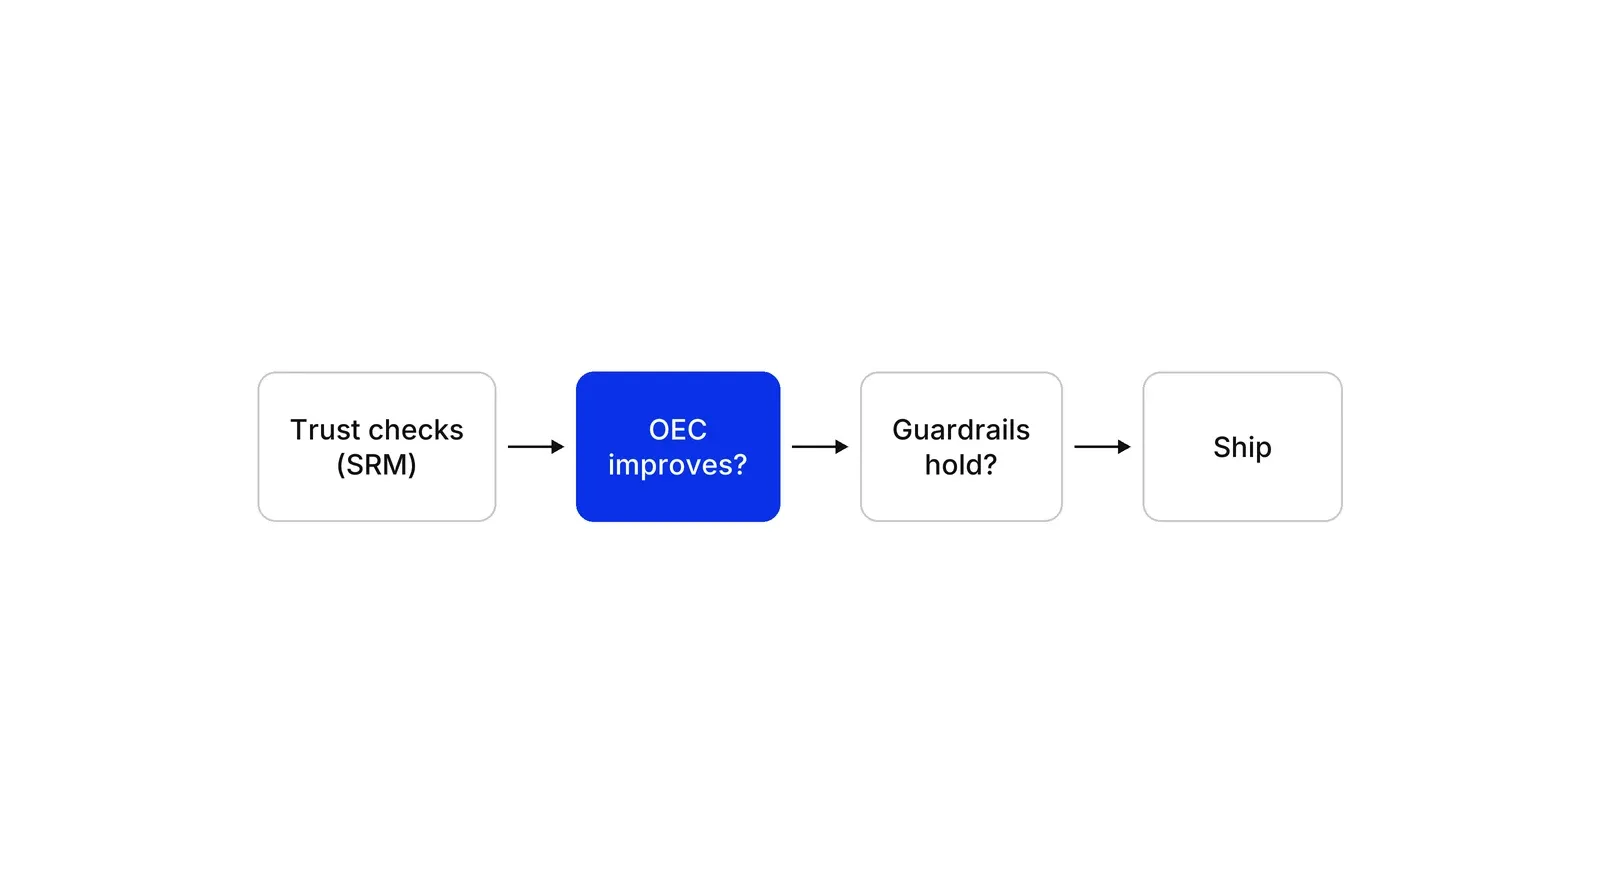
Самая распространённая проверка — перекос выборки (sample ratio mismatch, SRM): расхождение между заданным и фактическим разделением трафика. В исследовании Microsoft и Booking.com 2019 года приведён пример: 821 588 пользователей против 815 482 выглядят как 50,2/49,8, но при честном разделении 50/50 вероятность такого расхождения меньше 1 к 500 000. У примерно 6% экспериментов Microsoft обнаружился SRM, говорится в том же исследовании, и в большинстве случаев он делает результат недействительным.
Spotify публикует своё правило запуска. Изменение выходит, только если оно лучше контроля хотя бы по одной метрике успеха, не хуже ни по одной защитной метрике и проходит все проверки качества, включая SRM, — так пишут Мортен Шульцберг и коллеги. Правило фиксируют до старта теста. Сколько пользователей нужно тесту, чтобы заметить заданный эффект, — отдельный вопрос, он разобран на странице про минимальный детектируемый эффект.
Кто ведёт программу
HBR описывает три способа организовать людей. Центральная команда обслуживает всю компанию и делает хорошие инструменты, но может казаться далёкой от целей продукта. Аналитики, разбросанные по бизнес-единицам, знают свою область, но у них нет карьерных путей и общих инструментов. Центр компетенций — модель Microsoft — держит посередине команду платформы, а аналитиков оставляет в продуктовых командах.
Небольшие компании обычно начинают с центральной команды или стороннего инструмента, а по мере роста объёма переводят аналитиков в команды. Дальше всех зашёл Booking.com: там любой сотрудник может сам вести эксперимент от начала до конца, с защитными механизмами и общим хранилищем результатов, как описывают Рафаэль Лопес Кауфман и коллеги.
Журнал экспериментов превращает набор тестов в программу. Если каждую гипотезу, результат и решение можно найти поиском, команды не повторяют старые тесты, а журнал показывает, какие идеи обычно выигрывают. Идеи попадают в очередь, ранжированные по методу ICE, а каждый результат питает следующую гипотезу в HADI-цикле — недельном цикле, на котором работает наш Growth Lab.
Как применять: Программа экспериментов в маркетинге: что это и как выстроить по шагам
- Согласуйте OEC. Посадите за один стол владельца стратегии и аналитика и выберите одну метрику или взвешенную комбинацию, по которой будут оценивать каждый тест. Она должна меняться за одну-две недели и предсказывать долгосрочную цель. Запишите, почему вы отвергли очевидных кандидатов, например одну только выручку. Результат: определение OEC в одну строку, которое утвердило руководство.
- Наведите порядок в логировании и проведите A/A-тесты. Дайте событиям единые названия во всех продуктах, затем разделите пользователей на две одинаковые группы и проверьте, что система примерно в 95% случаев не находит значимой разницы, — так пишут Кохави и Томке. Результат: доказательство, что конвейер данных не выдумывает эффекты, ещё до первого настоящего теста.
- Задайте защитные метрики и автоматические проверки достоверности. Выпишите метрики, которым ни один тест вредить не должен: выручка на пользователя, время загрузки страницы, доля жалоб. В карточку результатов каждого теста добавьте проверку на перекос выборки (SRM). Заранее решите, что блокирует выкатку. Результат: письменное правило запуска, общее для всех тестов.
- Заведите один бэклог и один ритм разбора. Сложите все идеи тестов в одну очередь: у каждой есть гипотеза, ожидаемое движение OEC и владелец. Ранжируйте очередь простой оценкой вроде ICE и разбирайте результаты раз в неделю. Результат: ровный поток тестов вместо всплесков, зависящих от того, кто громче всех требует.
- Выберите модель команды. Начните с центральной команды или стороннего инструмента, а по мере роста числа тестов переводите аналитиков в продуктовые команды, оставив небольшую центральную группу для платформы и методов. Результат: названные владельцы запуска тестов, разбора результатов и поддержки платформы.
- Ведите журнал экспериментов. Записывайте каждый тест — гипотезу, даты, сегменты, результат и решение — в месте, где можно искать, и раз в квартал просматривайте журнал в поисках закономерностей. Результат: институциональная память, которая не даёт командам повторять старые тесты и показывает, какие идеи обычно выигрывают.
Примеры
Заголовки объявлений в Bing: документально подтверждённый случай
В 2012 году сотрудник Microsoft предложил показывать в Bing более длинные заголовки объявлений. Идея больше шести месяцев лежала в бэклоге с низким приоритетом, пока инженер не провёл простой A/B-тест. Выручка выросла на 12%, то есть больше чем на 100 млн долларов в год в США, по данным Кохави и Томке в Harvard Business Review. Сначала результат вызвал сигнал «слишком хорошо, чтобы быть правдой», и тут помог OEC программы: Bing оценивает тесты по выручке в сопоставлении с показателями пользовательского опыта вроде числа сессий на пользователя, а они не ухудшились. Недорогая платформа для тестов превратила забытую идею в лучший результат по выручке за всю историю Bing.
Платёжное приложение вводит защитные метрики
Иллюстративный пример. Потребительское платёжное приложение с 400 000 активных пользователей в неделю тестирует более короткую регистрацию. OEC — доля новых пользователей, которые за семь дней совершили первый перевод. Защитные метрики — доля заявок, уходящих на проверку на мошенничество, и число обращений в поддержку на 1 000 пользователей. Короткая регистрация увеличивает число первых переводов, но доля проверок на мошенничество вырастает выше согласованного предела, и команда тест не выкатывает. Она повторяет его, вернув один шаг подтверждения личности. Не будь защитной метрики, записанной заранее, рост конверсии выкатили бы, а цену обнаружили бы позже, в возвратных платежах (чарджбэках).
Сервис телемедицины замечает сломанное разделение
Иллюстративный пример. Сайт записи на телеконсультации делит посетителей 50 на 50, чтобы протестировать новую страницу профиля врача. Через неделю карточка результатов показывает 52 400 пользователей в контрольной группе и 50 100 в тестовой. Проверка на перекос выборки (SRM) срабатывает: такой разрыв слишком велик, чтобы быть случайностью. Причина — редирект на новой странице: часть посетителей пропадает до того, как их успевают записать в лог. Команда исправляет редирект и перезапускает тест, а не докладывает о приросте, который получился из-за потери части одной из групп.
Когда применять
Подходит, когда компания запускает или хочет запускать больше нескольких A/B-тестов в месяц в нескольких командах, а результаты начинают противоречить друг другу, цифрам никто не верит или тесты стоят в очереди к аналитику. Лучше всего ложится на цифровые продукты с тысячами пользователей в неделю: маркетплейсы, финтех и потребительские приложения, SaaS, контентные сайты.
Когда не применять
Формальная программа не нужна, если трафика слишком мало, чтобы заметить реалистичные эффекты: B2B-продукт с 300 клиентами узнает больше из интервью и поэтапных запусков. Не подходит она и для решений, которые нельзя разделить между группами: слияния, ребрендинга или смены цены, когда клиенты будут сравнивать впечатления. Для одного теста хватит внимательного аналитика и расчёта размера выборки.
Частые ошибки
- Брать в качестве OEC одну выручку или прибыль. Краткосрочные приёмы вроде добавления рекламы или повышения цен поднимают её, но отпугивают пользователей. Именно об этом предупреждают Кохави, Тан и Сюй.
- Читать OEC раньше, чем пройдены проверки достоверности. Перекос выборки (SRM) в большинстве случаев делает результат недействительным, так что рост в сломанном тесте — шум.
- Писать правило запуска после того, как увидели данные. Решите до старта теста, какая метрика успеха должна вырасти и какие защитные метрики обязаны выдержать.
- Ждать, что большинство тестов выиграет. В Microsoft положительным был примерно каждый третий тест, а в Google и Bing — от 10 до 20%. Программа, которая отчитывается почти одними победами, скорее всего, не проверяет свои результаты.
- Перепрыгивать от нескольких тестов в год сразу к сотням без возможностей платформы, нужных каждой фазе, таких как оповещения и автоматическая остановка: вредные тесты продолжают идти на живых пользователях.
Вопросы и ответы
Что такое программа экспериментов?
Это система, которая позволяет компании запускать много контролируемых экспериментов и доверять их результатам. В неё входят согласованная метрика успеха (OEC), защитные метрики, автоматические проверки качества данных, платформа для экспериментов, бэклог с ритмом разбора и распределённые роли. Стандартный источник — книга Кохави, Тан и Сюй 2020 года Trustworthy Online Controlled Experiments.
Что такое OEC (overall evaluation criterion)?
OEC — количественный показатель, по которому оценивают каждый эксперимент. Его выбирают так, чтобы он менялся за время теста и предсказывал долгосрочный успех. В него можно собрать несколько метрик. OEC Bing сопоставляет выручку с показателями пользовательского опыта, например числом сессий на пользователя. Кохави и Томке советуют пересматривать его раз в год.
Что такое защитные метрики (guardrails) в A/B-тестах?
Это показатели, которые тест не пытается улучшить, но которым не должен навредить: время загрузки страницы, выручка на пользователя, доля жалоб. По опубликованному правилу Spotify изменение выкатывают, только если оно лучше контроля по метрике успеха и не хуже контроля ни по одной защитной метрике.
Что такое перекос выборки (SRM)?
Это расхождение между заданным и фактическим разделением трафика, например 50,2% против 49,8% на 1,6 млн пользователей. Тест хи-квадрат показывает, не слишком ли велико расхождение для случайности. По данным исследователей Microsoft и Booking.com, SRM был примерно у 6% экспериментов Microsoft, и обычно это значит, что результату верить нельзя.
Что такое фазы crawl, walk, run и fly?
Это четыре фазы зрелости из модели Александра Фабияна и коллег 2017 года, которую используют Кохави, Тан и Сюй в своей книге. На фазе crawl строят логирование и вручную запускают первые тесты. На фазе walk появляются метрики и платформа с A/A-тестами. На фазе run программа выходит за примерно 100 тестов в год и получает оповещения. На фазе fly почти каждое изменение тестируется автоматически.
Источники
- Ron Kohavi, Diane Tang, Ya Xu, Trustworthy Online Controlled Experiments: A Practical Guide to A/B Testing, Cambridge University Press, 2020
- Kohavi, Tang, Xu, the book's website, experimentguide.com
- Kohavi, Tang, Xu, Chapter 1: Introduction and Motivation (free PDF)
- Cambridge University Press, Chapter 4: Experimentation Platform and Culture (abstract)
- Cambridge University Press, Chapter 7: Metrics for Experimentation and the Overall Evaluation Criterion (abstract)
- Cambridge University Press, Chapter 8: Institutional Memory and Meta-Analysis (abstract)
- Ron Kohavi, Stefan Thomke, The Surprising Power of Online Experiments, Harvard Business Review, September-October 2017
- Aleksander Fabijan, Pavel Dmitriev, Helena Holmström Olsson, Jan Bosch, The Evolution of Continuous Experimentation in Software Product Development, ICSE 2017
- Aleksander Fabijan et al., Diagnosing Sample Ratio Mismatch in Online Controlled Experiments: A Taxonomy and Rules of Thumb for Practitioners, KDD 2019
- Aleksander Fabijan et al., Three Key Checklists and Remedies for Trustworthy Analysis of Online Controlled Experiments at Scale, ICSE-SEIP 2019
- Nanyu Chen, Min Liu, Ya Xu, Automatic Detection and Diagnosis of Biased Online Experiments, arXiv, 2018
- Pavel Dmitriev, Somit Gupta, Dong Woo Kim, Garnet Vaz, A Dirty Dozen: Twelve Common Metric Interpretation Pitfalls in Online Controlled Experiments, KDD 2017
- Alex Deng, Xiaolin Shi, Data-Driven Metric Development for Online Controlled Experiments: Seven Lessons Learned, KDD 2016
- Somit Gupta, Ronny Kohavi, Diane Tang, Ya Xu et al., Top Challenges from the first Practical Online Controlled Experiments Summit, SIGKDD Explorations 21(1), 2019
- Mårten Schultzberg, Sebastian Ankargren, Mattias Frånberg, Risk-aware product decisions in A/B tests with multiple metrics, Spotify Engineering, 2024
- Tong Xia, Sumit Bhardwaj, Pavel Dmitriev, Aleksander Fabijan, Safe Velocity: A Practical Guide to Software Deployment at Scale using Controlled Rollout, ICSE-SEIP 2019
- Ron Kohavi, Roger Longbotham, Dan Sommerfield, Randal M. Henne, Controlled experiments on the web: survey and practical guide, Data Mining and Knowledge Discovery 18(1), 2009
- Ron Kohavi, Randal M. Henne, Dan Sommerfield, Practical Guide to Controlled Experiments on the Web: Listen to Your Customers not to the HiPPO, KDD 2007
- Ron Kohavi, Roger Longbotham, Online Experiments: Lessons Learned, IEEE Computer, 2007
- ExP Platform (Ron Kohavi), HiPPO FAQ
- Aleksander Fabijan, Pavel Dmitriev, Helena Holmström Olsson, Jan Bosch, The Benefits of Controlled Experimentation at Scale, SEAA 2017
- Stefan Thomke, Building a Culture of Experimentation, Harvard Business Review, March-April 2020
- Raphael Lopez Kaufman, Jegar Pitchforth, Lukas Vermeer, Democratizing online controlled experiments at Booking.com, arXiv, 2017
- Ya Xu et al., From Infrastructure to Culture: A/B Testing Challenges in Large Scale Social Networks, KDD 2015
- Diane Tang, Ashish Agarwal, Deirdre O'Brien, Mike Meyer, Overlapping Experiment Infrastructure: More, Better, Faster Experimentation, KDD 2010, Google Research
Обновлено 15 октября 2026

Маркетинговое агентство или система роста: что нужно на каждом этапе масштабирования
Агентство подходит, пока фаундер сам ведёт большую часть процессов. Когда бизнес начинает копировать себя в новые точки и регионы, нужна система, которая ставит цели, проверяет гипотезы и отвечает за результат.
Агентство медицинского маркетинга: почему работа с клиникой буксует и какую модель используем мы
Большинство агентств отвечают за клик, а за регистратуру не отвечает никто. Как мы строим маркетинг клиники в трёх горизонтах, на каких исследованиях это основано и что дал один год работы.
Тестирование рекламных каналов: почему тест затухает на третьем месяце
Большинство тестов нового рекламного канала заканчиваются не решением. Они заканчиваются, когда кончился бюджет, поменялась атрибуция или все тихо перестали открывать дашборд.