Мультиканальная атрибуция: data-driven модели
Data-driven атрибуция подгоняет модель к путям клиентов, которые купили и не купили, и делит заслугу между точками контакта по оценённому вкладу каждой. Описывает путь лучше фиксированных правил, но причину продаж всё равно не доказывает.
Мультиканальная атрибуция (MTA) делит заслугу за конверсию между несколькими точками контакта. Data-driven атрибуция делает это моделью, подогнанной к путям с покупкой и без неё, и использует значения Шепли или цепи Маркова вместо фиксированных весов. Путь она описывает честнее, чем последний клик, но эксперименты показывают: что реклама вызвала на самом деле, модель может не уловить.
- Автор
- Сюйхуэй Шао и Лэсинь Ли (data-driven MTA, 2011); Брайан Далессандро с коллегами (2012); Ева Андерль с коллегами (марковские графы, 2016); в продукт превратил Google, 2011–2016 в исследованиях; единой даты у продуктов нет
- Уровень
- 301 · Продвинутый
- Подходит
- растущая компания, корпорация
- Время на внедрение
- две-четыре недели, чтобы сравнить модель с одним тестом
- Что понадобится
- данные о путях: упорядоченные точки контакта и для купивших, и для не купивших пользователей · объём конверсий, достаточный для моделирования (Google называет нижней границей для своей модели 200 конверсий в месяц) · один канал, где можно провести холдаут или гео-тест
Мультиканальная атрибуция (MTA) делит заслугу за одну конверсию между несколькими точками контакта в пути клиента. Data-driven атрибуция — вариант, где долю каждого канала определяет подогнанная модель, а не фиксированное правило. Правила вроде последнего клика, линейной модели и модели по позиции разобраны на странице про модели атрибуции. Эта страница продолжает с того места, где та заканчивается: что модель делает иначе и насколько ей можно верить.
Что делает атрибуцию data-driven
Data-driven атрибуция учится и на путях, которые закончились продажей, и на тех, что не закончились. Фиксированное правило отдаёт последнему клику 100%, что бы ни говорили данные. Модель спрашивает, какие точки контакта повышают шанс конверсии, и делит заслугу в этой пропорции. Справка Google описывает это как сравнение путей с конверсией и без неё, причём модель строится отдельно под каждого рекламодателя.
В науке идею оформили раньше, чем она стала продуктом. Шао и Ли представили data-driven мультиканальную атрибуцию на KDD в 2011 году с двумя моделями: бэггинговой логистической регрессией и простой вероятностной моделью. Через год Далессандро с коллегами поставили атрибуцию как задачу причинной оценки и предложили приближения из теории кооперативных игр. Каннан, Райнарц и Верхоф позже подытожили область вокруг одной цели: инкрементальной ценности каждой точки контакта и перетекания эффекта между каналами.
Атрибуция по значению Шепли
Атрибуция по значению Шепли засчитывает каждой точке контакта её средний предельный вклад по всем сочетаниям точек контакта, к которым она могла бы присоединиться. Метод взят из статьи Ллойда Шепли 1953 года о том, как справедливо разделить результат команды между её участниками. В рекламе участники — каналы, результат — конверсии.
Простой случай: медийная реклама добавляет один пункт к шансу конверсии, когда присоединяется к пути с поиском, и три пункта, когда присоединяется к пути с email. Её заслуга по Шепли — предельный прирост, усреднённый по всем таким сочетаниям и порядкам.
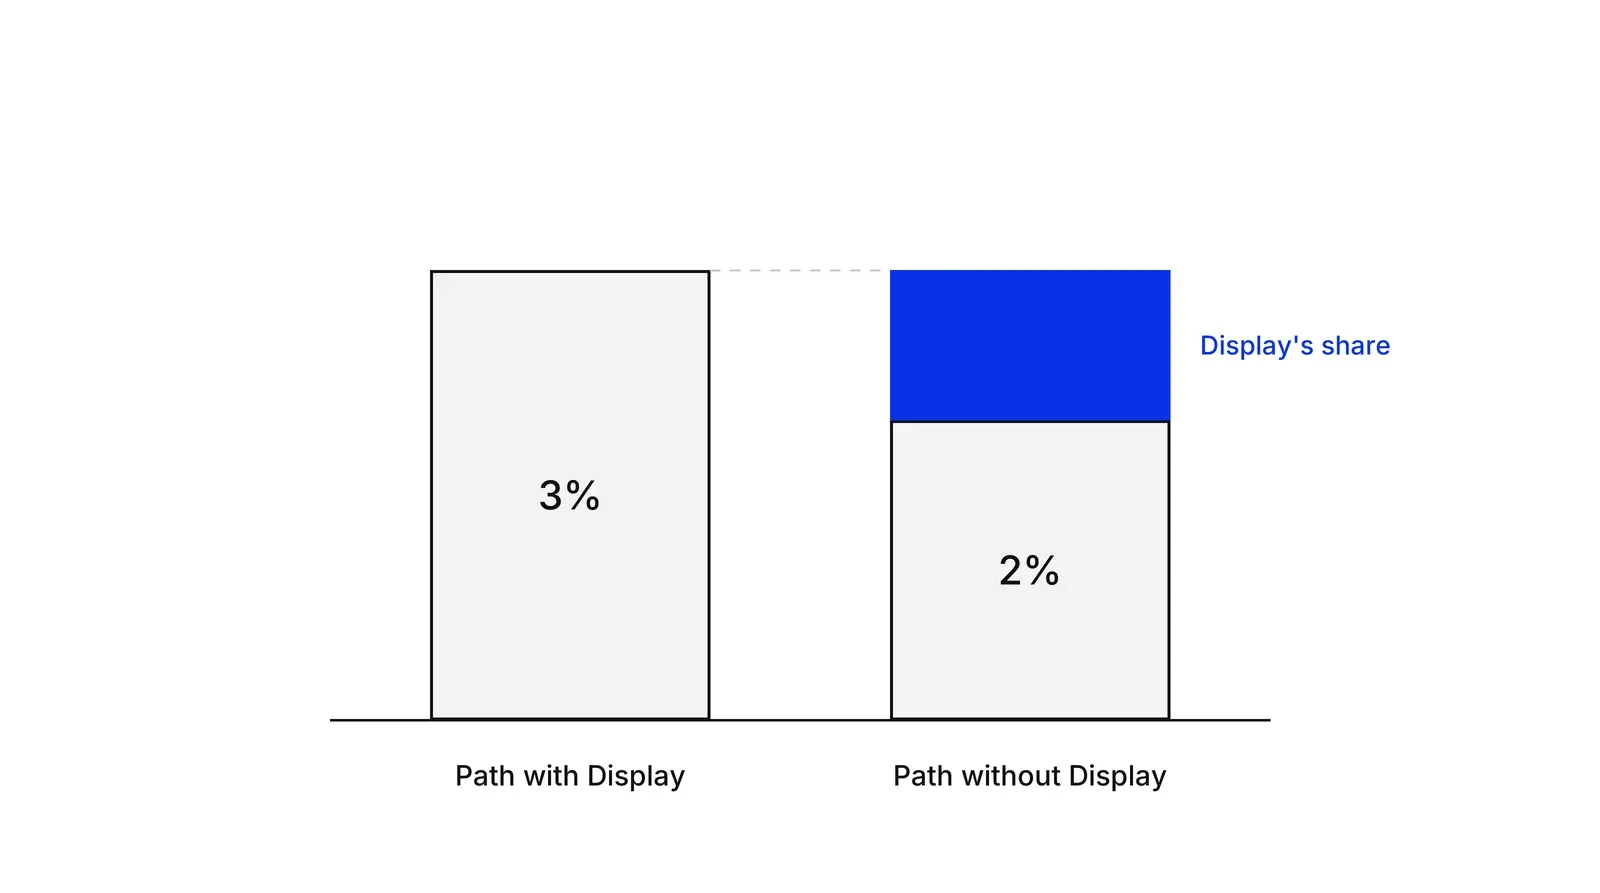
Описание модели Google Analytics 360 состоит из двух шагов: смоделировать вероятность конверсии по пользователям с конверсией и без неё, затем применить алгоритм на основе значения Шепли, чтобы разделить заслугу. В примере путь из органического поиска, медийной рекламы и email даёт вероятность конверсии 3%, а без медийной рекламы — 2%. Порядок важен: медийная реклама перед платным поиском моделируется отдельно от обратной последовательности.
Берман показал в теоретико-игровой модели, что метод на основе значения Шепли повышает прибыль рекламодателя по сравнению с последним касанием: оплата за последнее касание чрезмерно стимулирует показы. Сингал с коллегами пришли к выводу, что классическое значение Шепли для рекламы нужно корректировать, и предложили вариант с контрфактической поправкой.
Атрибуция на цепях Маркова
Атрибуция на цепях Маркова описывает путь клиента как переходы между состояниями, например каналами, которые заканчиваются конверсией или уходом. Андерль с коллегами смоделировали пути как марковские блуждания первого и высших порядков и применили их к четырём большим наборам данных, в каждом из которых было не меньше семи онлайн-каналов. Они обнаружили существенные отличия от последнего клика, а также эффекты переноса и перетекания между каналами.
Обычный способ оценить канал в таких моделях — эффект удаления: убираем канал из графа и смотрим, насколько падает суммарная вероятность конверсии. Заслугу каналам затем распределяют пропорционально эффектам удаления. Открытый пакет ChannelAttribution реализует марковскую модель порядка k и заодно правила первого, последнего и линейного касания.
| Метод | На какой вопрос отвечает | Что нужно | Слабое место |
|---|---|---|---|
| Шепли | Что добавляет каждый контакт по всем сочетаниям? | Модель вероятности конверсии для каждого пути | Число сочетаний быстро растёт с числом каналов |
| Цепь Маркова | Что теряется, если канал исчезнет из графа? | Упорядоченные пути купивших и не купивших | Зависит от выбранного порядка цепи |
| Логистические или нейросетевые модели | Какие контакты предсказывают конверсию? | Много размеченных путей | Предсказание — это не причина |
Новые работы идут по той же логике, но с более тяжёлой техникой. DNAMTA добавляет слои внимания и контрольные переменные по пользователям, чтобы предсказывать конверсии по последовательностям показов, а LiDDA в LinkedIn использует трансформер и подтягивает итоги по каналам к модели маркетингового микса.
Как data-driven атрибуция Google работает на практике
Большинство рекламодателей первой встречают именно модель Google. Справка Google Ads называет две актуальные модели — последний клик и data-driven — и пишет, что data-driven для большинства действий-конверсий стоит по умолчанию. Справка GA4 сообщает, что модель применяет машинное обучение к путям с конверсией и без неё, учитывает время от ключевого события, устройство, число взаимодействий с рекламой, порядок показов и тип креатива, а также сравнивает пользователей, видевших рекламу, с контрольной группой, которой её не показывали. Конверсии могут переатрибутироваться в течение семи дней после события.
Стоит знать два ограничения. Модель видит только те контакты, которые записывает её платформа, и ей нужен объём: Google рекомендует не меньше 200 конверсий и 2000 взаимодействий с рекламой за 30 дней, чтобы модель хорошо подогналась. Ещё один пробел на мобильных создаёт фреймворк Apple App Tracking Transparency: приложениям нужно разрешение пользователя, чтобы отслеживать его в приложениях и на сайтах других компаний.
Совпадают ли эти модели с экспериментами?
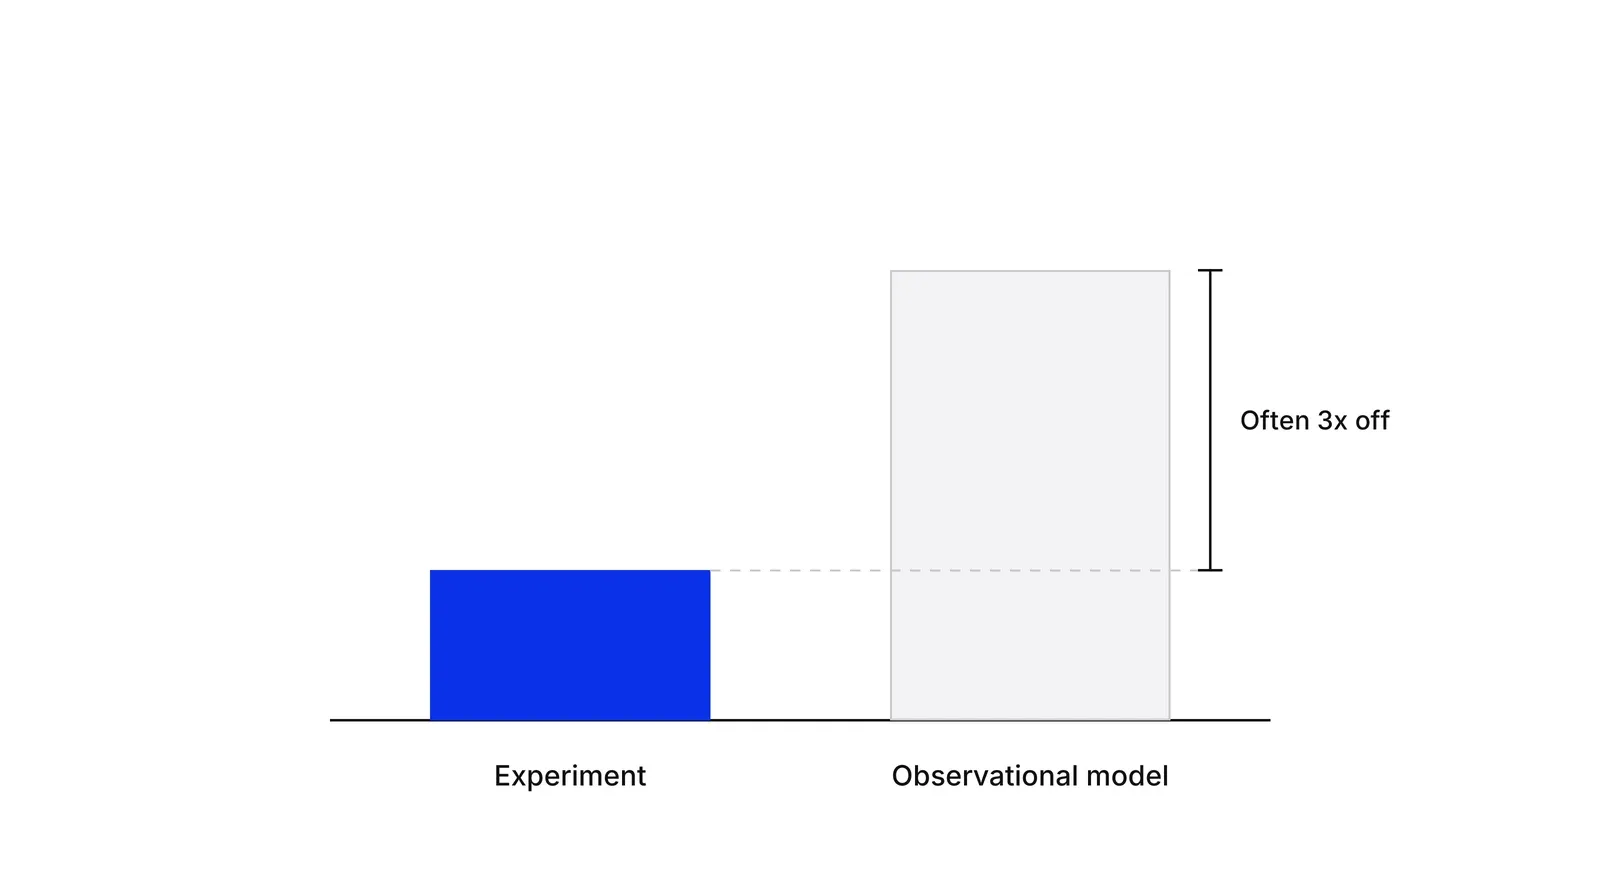
Часто нет. Гордон, Зеттельмайер, Бхаргава и Чапски взяли 15 экспериментов в Facebook (принадлежит компании Meta, признанной экстремистской организацией и запрещённой в России), 500 миллионов наблюдений «пользователь — эксперимент» и 1,6 миллиарда показов рекламы и сверили наблюдательные методы с рандомизированными результатами. В их рабочей статье говорится, что методы в основном завышали прирост, иногда занижали, а в половине исследований ошибались втрое.
Продолжение 2023 года опиралось на 663 эксперимента в Facebook и больше чем 5000 признаков на уровне пользователей. Авторы заключают, что даже с такими данными надёжно оценить причинный эффект рекламной кампании не смогли. Раньше Блейк, Носко и Таделис выяснили в eBay, что реклама по брендовым ключевым словам не дала измеримой краткосрочной выгоды, а Льюис и Рао назвали смещение отбора из-за таргетинга рекламы серьёзной проблемой для наблюдательных методов.
Модель путей находится на наблюдательной стороне этой границы. Описывает путь она лучше фиксированного правила, но заменить тест не может.
Как использовать модель рядом с экспериментами
Считайте модель недельным срезом, а эксперимент — проверкой. Тесты инкрементальности измеряют прирост напрямую. Ghost ads удешевляют их там, где платформа это позволяет, а гео-эксперименты рандомизируют по регионам, как объясняет страница про гео-тесты прироста. Моделирование маркетингового микса охватывает каналы без записанного контакта, а единое измерение показывает, как три слоя соединяются. Логика того, почему это работает, изложена на странице про причинно-следственный анализ. План Growth Lab начинается с такого стека измерения, ещё до того как двигаются бюджеты.
Как применять: Мультиканальная атрибуция: data-driven модели по шагам
- Определите конверсию и точки контакта. Выберите одну конверсию, например оплаченную запись, и перечислите точки контакта, которые попадают в данные: клики по рекламе, показы, письма, визиты на сайт. Отдельно запишите, чего в данных нет, например подкастов и сарафанного радио. Результат: спецификация на одну страницу о том, что модель видит, а что нет.
- Соберите пути купивших и не купивших. Выгрузите упорядоченные цепочки контактов по каждому пользователю, включая тех, кто так и не купил. Модель, которая видит только купивших, не поймёт, что точка контакта добавляет. Результат: таблица путей с признаком конверсии.
- Подгоните одну модель и посмотрите заслугу по каналам. Возьмите встроенную data-driven модель в Google Ads или GA4 либо подгоните модель Маркова или Шепли сами. Сравните её распределение заслуг с последним кликом. Результат: таблица каналов с заслугой по обеим моделям.
- Отметьте каналы, где модель сильнее всего расходится с последним кликом. Большой разрыв указывает на каналы, которые открывают пути или помогают им, а может быть, просто стоят рядом с продажей. Какой из двух вариантов верен, модель не скажет. Результат: короткий список каналов для проверки.
- Проверьте самый большой разрыв экспериментом. Проведите холдаут, ghost ads или гео-тест на канале с наибольшим разрывом и сравните измеренный прирост с заслугой по модели. Результат: один калибровочный коэффициент, заслуга к приросту.
- Модель — для динамики, тест — для решений о бюджете. Оставьте модель в еженедельной отчётности, домножая её на калибровочный коэффициент, а крупные суммы перекладывайте только по результатам тестов. Результат: правило отчётности, которое называет, какое число отвечает на какой вопрос.
Примеры
Платные соцсети, поиск и email: расчётный пример
Иллюстративная арифметика, реальная компания не подразумевается. К путям записи в клинику подогнали модель Маркова: она говорит, что без платной рекламы в соцсетях клиника потеряла бы 40 записей, без поиска — 30, без email — 10. Эффекты удаления в сумме дают 80, поэтому 100 записей делятся как 50, 37,5 и 12,5. Последний клик отдал бы большую часть этих 100 поиску.
Пример Google: прирост, который считает сама модель
В справке Google Analytics путь из органического поиска, медийной рекламы и email конвертируется с вероятностью 3%, а тот же путь без медийной рекламы — 2%. Относительный прирост на 50% при наличии медийной рекламы и есть основание засчитать ей заслугу. Это сравнение моделей на похожих пользователях, а не рандомизированный тест.
15 экспериментов: модели против рандомизации
Гордон, Зеттельмайер, Бхаргава и Чапски сравнили наблюдательные оценки с рандомизированными тестами в 15 кампаниях Facebook. По их рабочей статье, в половине исследований оценка процентного прироста покупок ошибалась втрое. Модели, подогнанные к данным о путях, несут тот же риск.
Когда применять
Data-driven атрибуцию стоит брать, когда вы ведёте несколько каналов с достаточным числом конверсий, последний клик явно занижает заслугу верхней части воронки, а нужен устойчивый недельный взгляд на вклад каналов. Используйте её рядом с тестами, а не вместо них.
Когда не применять
Не используйте её как доказательство, что канал работает, не двигайте с её помощью крупный бюджет без холдаута и не берите при нескольких десятках конверсий в месяц. Каналы, которые не оставляют записанного контакта, такие как подкасты, офлайн-реклама и сарафанное радио, любая модель путей не видит.
Частые ошибки
- Читать data-driven заслугу как инкрементальный прирост, хотя модель лишь перераспределяет продажи, которые уже случились.
- Подгонять модель только по путям с покупкой: тогда она не узнает, какие контакты не дали ничего.
- Сравнивать data-driven заслугу Google с заслугой другой платформы, не проверив, что окна, конверсии и типы контактов совпадают.
- Больше доверять модели из-за её сложности. Гордон с коллегами обнаружили, что богатые данные и глубокое обучение всё равно не воспроизвели результаты экспериментов.
- Бросать тесты, когда модель уже работает. Без них модели не с чем калиброваться.
Вопросы и ответы
Что такое мультиканальная атрибуция?
Мультиканальная атрибуция распределяет заслугу за одну конверсию между несколькими точками контакта в пути клиента. Делить можно по фиксированным правилам, например линейно или по позиции, либо подогнанной моделью, например по значениям Шепли или цепям Маркова. Data-driven атрибуция относится ко второму типу.
Data-driven атрибуция лучше последнего клика?
Обычно она ближе к реальному пути: учитывает пути без конверсии и засчитывает помогающие контакты. Но лучше как описание не значит лучше как оценка причины. Гордон с коллегами выяснили, что наблюдательные методы часто расходятся с результатами экспериментов, поэтому крупные решения проверяйте тестом.
Чем отличается атрибуция по Шепли от атрибуции по Маркову?
Метод Шепли делит заслугу, усредняя предельный вклад точки контакта по сочетаниям точек контакта; он взят из теории кооперативных игр. Метод Маркова представляет путь как переходы между каналами и оценивает канал по тому, насколько падает конверсия, если его убрать. Оба метода зависят от данных о путях, которые в них загрузили.
Сколько данных нужно для data-driven атрибуции Google?
Справка Google Ads рекомендует не меньше 200 конверсий и 2000 взаимодействий с рекламой за 30 дней в поддерживаемых сетях. Допускаются все действия-конверсии независимо от объёма, но при малых объёмах заслуга считается менее точно, а каждая модель строится под одного рекламодателя.
Источники
- Google Ads Help, About data-driven attribution
- Google Ads Help, About attribution models
- Google Analytics Help, Advertising and attribution (GA4)
- Google Analytics Help, Data-Driven Attribution methodology (Universal Analytics 360)
- Xuhui Shao, Lexin Li, Data-driven multi-touch attribution models, ACM SIGKDD 2011
- Brian Dalessandro, Claudia Perlich, Ori Stitelman, Foster Provost, Causally motivated attribution for online advertising, ADKDD 2012
- Eva Anderl, Ingo Becker, Florian von Wangenheim, Jan H. Schumann, Mapping the customer journey: Lessons learned from graph-based online attribution modeling, International Journal of Research in Marketing 33(3), 2016
- Hongshuang (Alice) Li, P. K. Kannan, Attributing Conversions in a Multichannel Online Marketing Environment, Journal of Marketing Research 51(1), 2014
- P. K. Kannan, Werner Reinartz, Peter C. Verhoef, The path to purchase and attribution modeling: Introduction to special section, International Journal of Research in Marketing 33(3), 2016
- Lloyd S. Shapley, A Value for n-Person Games, in Contributions to the Theory of Games II, Princeton University Press, 1953
- Ron Berman, Beyond the Last Touch: Attribution in Online Advertising, Marketing Science 37(5), 2018
- Raghav Singal, Omar Besbes, Antoine Desir, Vineet Goyal, Garud Iyengar, Shapley Meets Uniform: An Axiomatic Framework for Attribution in Online Advertising, Management Science 68(10), 2022
- Brett R. Gordon, Florian Zettelmeyer, Neha Bhargava, Dan Chapsky, A Comparison of Approaches to Advertising Measurement: Evidence from Big Field Experiments at Facebook, Marketing Science 38(2), 2019
- Brett R. Gordon, Florian Zettelmeyer, Neha Bhargava, Dan Chapsky, A Comparison of Approaches to Advertising Measurement, working paper, Kellogg School of Management, 2018
- Brett R. Gordon, Robert Moakler, Florian Zettelmeyer, Close Enough? A Large-Scale Exploration of Non-Experimental Approaches to Advertising Measurement, Marketing Science 42(4), 2023
- Close Enough? arXiv version 2, 2022
- Thomas Blake, Chris Nosko, Steven Tadelis, Consumer Heterogeneity and Paid Search Effectiveness: A Large-Scale Field Experiment, NBER Working Paper 20171, 2014
- Randall A. Lewis, Justin M. Rao, The Unfavorable Economics of Measuring the Returns to Advertising, Quarterly Journal of Economics 130(4), 2015
- Garrett A. Johnson, Randall A. Lewis, Elmar I. Nubbemeyer, Ghost Ads: Improving the Economics of Measuring Online Ad Effectiveness, Journal of Marketing Research 54(6), 2017
- Jon Vaver, Jim Koehler, Measuring Ad Effectiveness Using Geo Experiments, Google Research, 2011
- Ning Li, Sai Kumar Arava, Chen Dong, Zhenyu Yan, Abhishek Pani, Deep Neural Net with Attention for Multi-channel Multi-touch Attribution, arXiv 1809.02230
- LiDDA: Data Driven Attribution at LinkedIn, arXiv 2505.09861
- ChannelAttribution package description, CRAN
- Apple Developer Documentation, App Tracking Transparency
Обновлено 20 октября 2026

Маркетинговое агентство или система роста: что нужно на каждом этапе масштабирования
Агентство подходит, пока фаундер сам ведёт большую часть процессов. Когда бизнес начинает копировать себя в новые точки и регионы, нужна система, которая ставит цели, проверяет гипотезы и отвечает за результат.
Агентство медицинского маркетинга: почему работа с клиникой буксует и какую модель используем мы
Большинство агентств отвечают за клик, а за регистратуру не отвечает никто. Как мы строим маркетинг клиники в трёх горизонтах, на каких исследованиях это основано и что дал один год работы.
Тестирование рекламных каналов: почему тест затухает на третьем месяце
Большинство тестов нового рекламного канала заканчиваются не решением. Они заканчиваются, когда кончился бюджет, поменялась атрибуция или все тихо перестали открывать дашборд.