Техническое SEO: что это и как провести аудит
Техническое SEO — работа, благодаря которой поисковик находит страницы сайта, отрисовывает их, добавляет в индекс и выбирает для каждой правильный URL. Без этого опубликованный контент даже не попадёт в выдачу.
Техническое SEO делает сайт доступным для сканирования, отрисовки и индексации: robots.txt, noindex, canonical, редиректы и коды ответа, XML-карта сайта, hreflang для языковых версий и скорость, которую измеряют метриками Core Web Vitals. Сначала оно отвечает на один вопрос: может ли Google или Яндекс прочитать страницу и сохранить в индексе нужную её версию? Пока ответ «нет», контент и ссылки не работают.
- Автор
- Прикладная дисциплина без единого автора: опирается на документацию поисковых систем и Robots Exclusion Protocol (Мартейн Костер, Martijn Koster), 1994 — robots.txt; в 2022 стандартизован как RFC 9309
- Уровень
- 201 · Инструмент
- Подходит
- стартап, малый и средний бизнес, растущая компания
- Время на внедрение
- один-два дня на первый аудит небольшого сайта; неделя и больше на крупный сайт или сайт на JavaScript
- Что понадобится
- подтверждённый доступ к Google Search Console и Яндекс Вебмастеру · краулер, который обходит сайт так, как это делает робот · разработчик, который может менять шаблоны, заголовки и правила сервера · список страниц, которые приносят деньги или заявки
Техническое SEO — это работа, которая делает сайт читаемым для поисковых систем: робот добирается до каждой страницы, отрисовывает её, сохраняет в индексе и выбирает для неё правильный URL. Автора у дисциплины нет. Она выросла из правил, которые публикуют сами поисковики, а старейшее из них — robots.txt: RFC 9309 связывает его с Мартейном Костером и 1994 годом, а в 2022 году IETF сделал его формальным стандартом. Основатели знакомятся с техническим SEO после редизайна, который съел половину трафика. Маркетологи — когда через три месяца после запуска 40 новых статей висят в Google Search Console со статусом «Просканирована, но пока не проиндексирована».
Как страница попадает с сервера в поисковую выдачу
Страница проходит четыре этапа, и первые три относятся к техническому SEO. В документации Google Search Central описаны три этапа: сканирование, индексирование и показ результатов. Между сканированием и индексированием стоит отрисовка: Googlebot выполняет JavaScript страницы в свежей версии Chrome. Там же сказано, что Google не гарантирует, что просканирует, проиндексирует или покажет любую страницу.
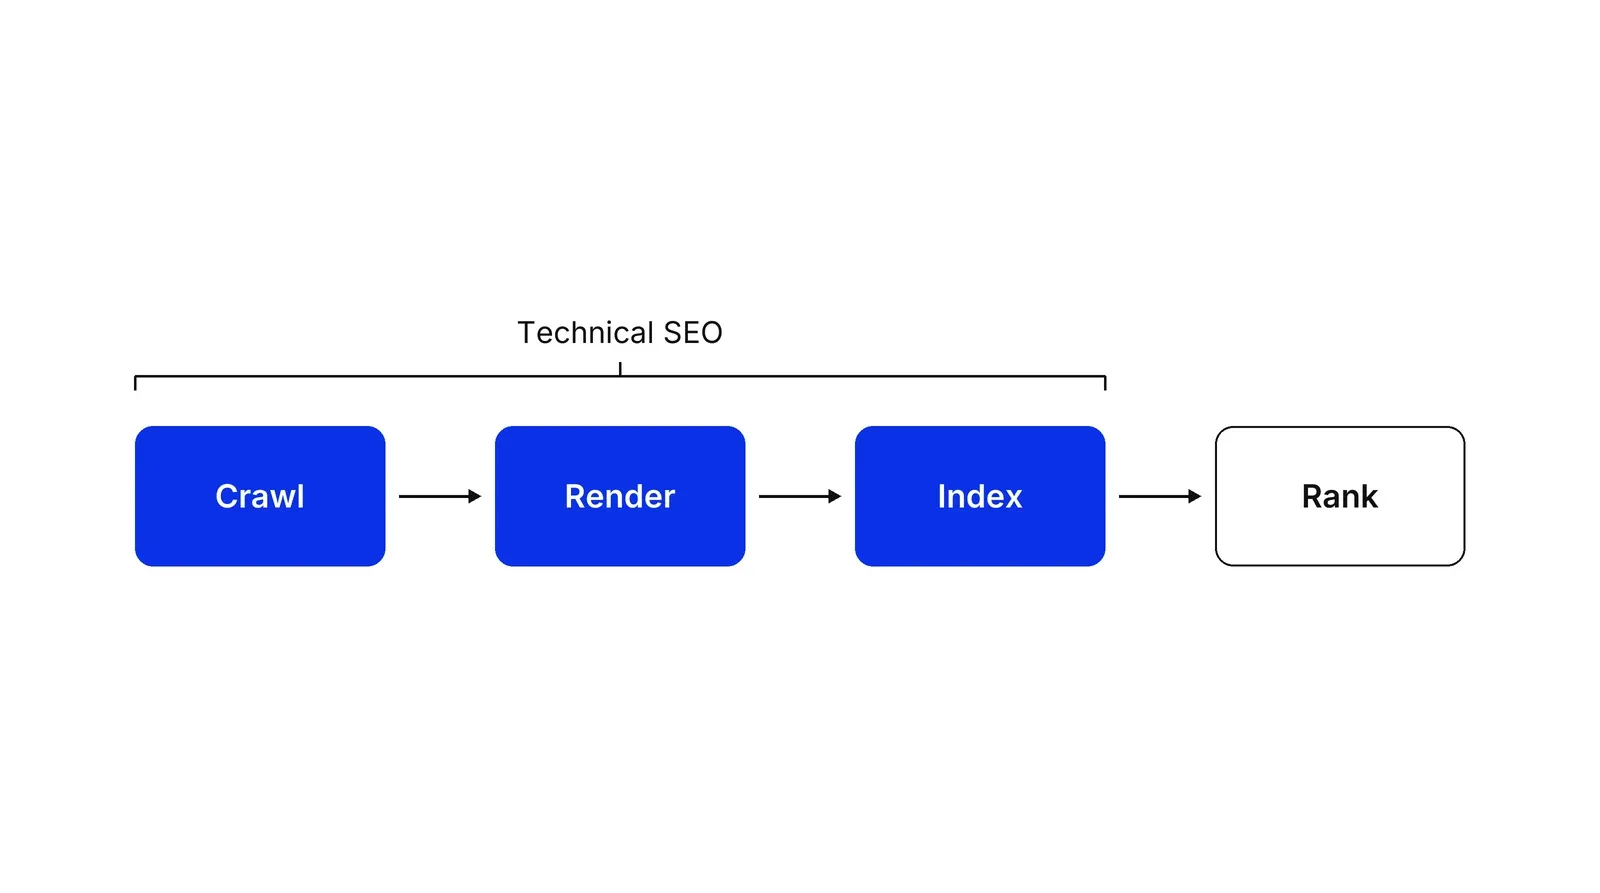
На каждом этапе ломается своё. Сканирование срывается, когда robots.txt закрывает раздел или сервер отвечает ошибками. Отрисовка срывается, когда основной текст появляется только после скриптов, которые робот не запускает. Индексирование срывается, когда поисковик решает, что страница дублирует другой URL или содержит слишком мало контента. Ранжирование — это то место, где порядок определяют контент, ссылки и релевантность, и начинается оно только для страниц, которые дошли до него.
Отчёт «Индексирование страниц» в Search Console показывает, где ваши страницы остановились. Совет из него для аудита: «Не ждите, что каждый URL вашего сайта будет проиндексирован». Цель — чтобы нужные страницы были в индексе, а дублей там не было.
Сканирование: robots.txt, коды ответа и краулинговый бюджет
Сканирование — это когда робот скачивает ваши страницы, а robots.txt — файл, который говорит ему, куда можно заходить. В руководстве Google по robots.txt сказано, что файл управляет трафиком сканеров и что это «не способ скрыть страницу от Google». RFC 9309 говорит то же языком стандартов: эти правила не служат способом авторизации доступа. Он же просит сканеры разбирать не меньше 500 KiB файла и не использовать кэшированную копию дольше 24 часов. По данным Web Almanac 2024, 83,5% настольных сайтов отдают файл robots.txt с ответом 200.
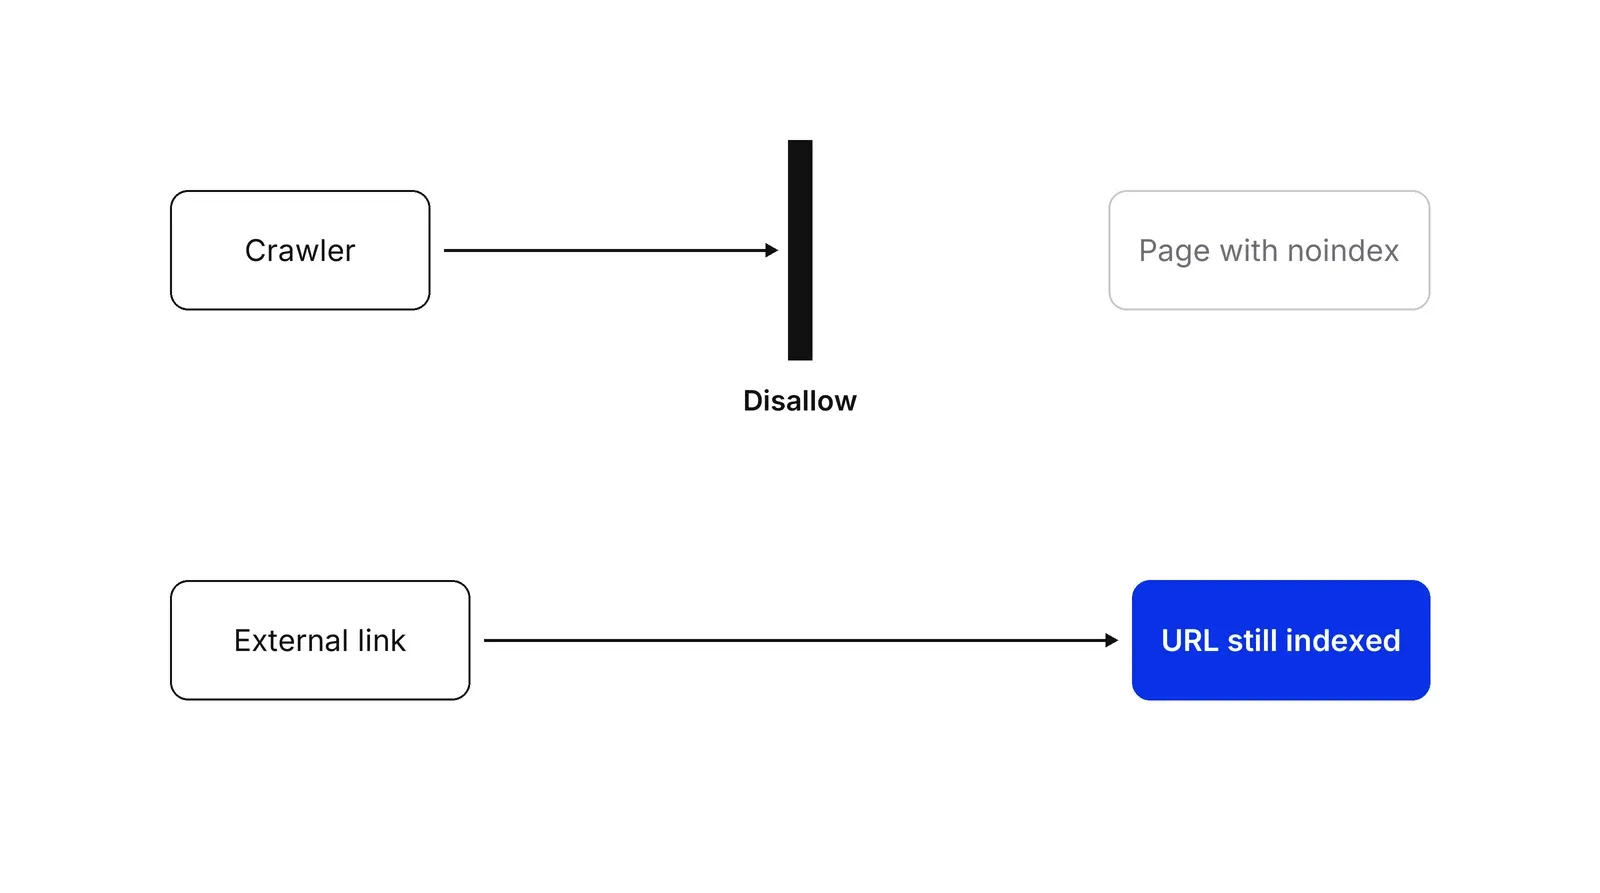
Дороже всего обходится ловушка: страницу закрывают в robots.txt и одновременно ставят на неё noindex. Роботу нельзя загрузить страницу, поэтому noindex он не прочтёт. Если на URL ссылается чужой сайт, адрес всё равно может попасть в индекс, обычно без описания. В руководстве Google по noindex сказано, что страница «не должна быть закрыта в файле robots.txt», иначе правило не сработает, и справка Яндекса по robots.txt даёт ту же инструкцию. Правило применяют широко: Web Almanac 2024 нашёл noindex на 4,7% настольных и 3,9% мобильных страниц.
Коды ответа сообщают роботу, что произошло. Согласно руководству Google по кодам ответа, сканеры проходят до 10 переходов по редиректам, страницы с ответом 4xx со временем выпадают из индекса, а повторяющиеся ошибки 5xx замедляют сканирование и в итоге убирают страницы. Ответ 429 «слишком много запросов» считается ошибкой сервера. Если URL переехал навсегда, используйте постоянный редирект 301 или 308: Google показывает в выдаче целевой адрес постоянного редиректа и исходный — временного.
Краулинговый бюджет важен меньше, чем принято думать. Руководство Google по краулинговому бюджету написано для сайтов примерно с миллионом страниц, которые меняются раз в неделю, или с 10 000 страниц, которые меняются каждый день. Сайту компании из 200 страниц он почти не нужен, и лучше смотреть отчёт «Индексирование страниц» в Google Search Console.
Индексирование: canonical, дубли и карты сайта
Канонический URL — единственный адрес, который поисковик хранит для группы дублей. Фильтры, сортировка, UTM-метки и идентификаторы сессий превращают одну страницу в десятки URL: у категории с 5 фильтрами по 4 значения возможны 3 125 комбинаций. Поисковик должен выбрать один адрес, и на этот выбор можно повлиять. В руководстве Google по canonical сигналы ранжированы по силе: редиректы и rel=“canonical” сильные, включение в карту сайта слабое. Там же предупреждение: «Не используйте robots.txt для выбора канонического адреса».
По данным HTTP Archive Web Almanac 2024, canonical стоит на 69% настольных и 65% мобильных страниц, то есть большинство сайтов этот сигнал уже подают. Согласован ли он с картой сайта и внутренними ссылками — другой вопрос, и именно это проверяет аудит.
XML-карта сайта — это список URL, которые вы хотите видеть в индексе. По руководству Google по картам сайта, в одном файле может быть не больше 50 000 URL или 50 МБ без сжатия, поля priority и changefreq Google игнорирует, а lastmod учитывает, только если даты стабильно точные. Включайте только канонические страницы с ответом 200. Карта, забитая редиректами, приучает поисковик ей не доверять.
Отрисовка и мобильная версия
Отрисовка — это шаг, на котором робот выполняет ваш JavaScript, чтобы увидеть готовую страницу. Google Search ставит страницы в очередь на отрисовку и обрабатывает позже, а его руководство по JavaScript и SEO рекомендует серверный рендеринг или пререндеринг, потому что не все роботы запускают скрипты. Там же сказано, что Google переходит только по ссылкам, оформленным как элементы <a> с атрибутом href.
Яндекс оставляет выбор вам. Настройка отрисовки JavaScript по умолчанию стоит в положении «На усмотрение робота», а если на сайте уже серверный рендеринг, Яндекс советует отключить отрисовку, чтобы разгрузить сервер.
Google Search индексирует мобильную версию сайта, которую сканирует Googlebot Smartphone. Руководство по мобильной индексации требует одинакового контента, структурированных данных, заголовков и описаний на мобильной и настольной версиях.
Языковые версии: hreflang
hreflang — аннотация, которая сообщает поисковикам, какая страница предназначена для какого языка или страны. Google принимает её в HTML, в HTTP-заголовках или в карте сайта, а его руководство по локализации задаёт два правила, на которых ломается большинство настроек: каждая версия должна указывать и на себя, а если две страницы не ссылаются друг на друга, теги игнорируются. По данным Web Almanac 2024, hreflang использует всего около 10% настольных и 9% мобильных сайтов.
Core Web Vitals
Core Web Vitals — три метрики скорости и стабильности, которые измеряют на реальных визитах. Целевые значения web.dev: Largest Contentful Paint в пределах 2,5 секунды, Interaction to Next Paint не больше 200 миллисекунд и Cumulative Layout Shift не больше 0,1; оценка идёт по 75-му процентилю загрузок страницы. INP заменил First Input Delay 12 марта 2024 года.
На странице Google о пользовательском опыте сказано: «Core Web Vitals используются нашими системами ранжирования», и при этом хорошие значения не гарантируют верхних позиций. Web Almanac 2024 насчитал, что все три метрики проходят 54% настольных и 48% мобильных сайтов. Воспринимайте скорость как довод в пользу одной из двух одинаково релевантных страниц и как отдельную проблему конверсии.
Google и Яндекс: где правила различаются
Если на сайт идёт трафик из обеих систем, придётся учесть несколько различий.
| Тема | Яндекс | |
|---|---|---|
| Тег canonical | Сильный сигнал, а не команда | Рекомендация: игнорируется, если указывает на другой домен или образует цепочку |
| Размер robots.txt | Парсеры должны читать не меньше 500 KiB по RFC 9309 | До 500 КБ; если файл больше или с ошибками, сайт считается открытым |
| Параметры URL | Решаются через canonical и robots.txt | Clean-param в robots.txt убирает UTM и параметры сессии |
| hreflang в карте сайта | Поддерживается | Больше не поддерживается; используйте теги в head страницы |
| Быстрый переобход | Проверка URL с суточным лимитом запросов | Инструмент «Переобход страниц», обход по тегу Метрики и IndexNow |
| JavaScript | Ставит в очередь на отрисовку страницы с ответом 200 | Отрисовка — настройка, которую можно выключить |
Яндекс пишет, что после запроса на переобход индексирование может занять от 3 до 7 дней. IndexNow используют также Bing, Naver, Seznam.cz и Yep, сообщает indexnow.org; Google в этом списке нет.
В работе Pushers по Growth Lab технический аудит всегда идёт раньше контент-плана: текст для страниц, которые нельзя проиндексировать, — потраченные впустую деньги.
Как применять: Техническое SEO: что это и как провести аудит по шагам
- Составьте список страниц, которые должны ранжироваться. Выпишите важные типы страниц: услуги, товары или врачи, категории, статьи. Отметьте, сколько страниц каждого типа должно быть, например 300 услуг, 60 врачей и 120 статей. Если у сайта с 300 услугами в индексе 4 000 URL, дубли есть ещё до того, как вы открыли первый отчёт. Результат: целевой список и число URL, которое должны хранить поисковые системы.
- Посмотрите, что поисковики уже видят. Откройте отчёт «Индексирование страниц» в Google Search Console и отчёты об индексировании в Яндекс Вебмастере. Сгруппируйте исключённые URL по причинам: закрыты в robots.txt, noindex, дубль с другим canonical, просканированы, но не проиндексированы, soft 404, ошибки сервера. Проверьте 5–10 самых ценных адресов инструментом проверки URL в Google Search Console. Результат: список расхождений между целевым списком и тем, что в индексе.
- Обойдите сайт краулером, как робот. Запустите краулер, например Screaming Frog SEO Spider, по всему сайту и по карте сайта: один раз как Googlebot Smartphone, второй раз как настольный робот. Зафиксируйте коды ответа, цепочки редиректов, canonical, правила noindex, страницы-сироты без внутренних ссылок и страницы, где основной контент появляется только после выполнения JavaScript. Результат: одна таблица — по строке на каждый URL с найденными на нём проблемами.
- Сначала исправьте доступ и дубли. Откройте в robots.txt важные разделы, перенесите noindex на страницы, которые должны остаться вне поиска, направьте каждый дубль на один canonical-адрес, замените цепочки из двух и более редиректов одним 301, а для удалённых страниц отдавайте 404 или 410. Очистите карту сайта: в ней должны остаться только канонические индексируемые URL с ответом 200. Результат: каждая целевая страница доступна, индексируется и имеет один адрес.
- Исправьте отрисовку, языковые версии и скорость. Убедитесь, что основной текст и ссылки есть в HTML, который отдаёт сервер, либо что обе поисковые системы их отрисовывают. Если есть версии для разных языков или стран, добавьте hreflang со ссылками в обе стороны. Посмотрите полевые данные Core Web Vitals в Chrome UX Report или Google Search Console по основным шаблонам и начните с худшего шаблона. Результат: список задач для разработчиков по шаблонам, упорядоченный по трафику каждого из них.
- Раз в месяц проверяйте заново. После крупных изменений заново отправляйте карту сайта, ключевые URL отправляйте на переобход в Яндекс Вебмастере, а через 30 дней сверяйте оба отчёта об индексировании. Настройте оповещения о всплеске ошибок 5xx и о файле robots.txt, который внезапно закрывает весь сайт. Результат: месячная проверка на одну страницу, которая ловит поломки после релизов.
Примеры
Сайт клиники с дублями от фильтров
Иллюстративный пример. В частной клинике работают 60 врачей. Каталог врачей можно отфильтровать по специальности, району и страховой компании, и каждая комбинация фильтров создаёт новый URL, поэтому краулер находит около 2 400 адресов вместо 60 настоящих страниц, то есть по 40 URL на врача. Команда ставит canonical со всех отфильтрованных вариантов на общий список врачей, добавляет для Яндекса директиву Clean-param для трёх параметров фильтра и UTM-меток и убирает отфильтрованные URL из карты сайта. В карте остаются 60 страниц врачей и страницы услуг — ровно тот набор, который нужен в индексе.
Лендинг финтех-сервиса на одностраничном приложении
Иллюстративный пример. Платёжный стартап собрал маркетинговый сайт как клиентское приложение. Сервер отдаёт почти пустую HTML-оболочку, навигация построена на обработчиках кликов вместо ссылок, а любой несуществующий путь отвечает кодом 200 и сообщением «страница не найдена». Решение: серверный рендеринг маркетинговых страниц, настоящие ссылки a href между ними и честный код 404 для несуществующих путей. Раз HTML теперь приходит целиком, команда выключает в Яндекс Вебмастере отрисовку JavaScript — именно так советует справка Яндекса для сайтов с серверным рендерингом.
Сайт с английской и русской версиями
Иллюстративный пример. SaaS-компания ведёт версии /en/ и /ru/ для 120 страниц. На русских страницах есть теги hreflang, на английских нет, и без обратных ссылок разметка игнорируется. Разработчик добавляет в head каждой версии полный набор ссылок hreflang: страница указывает на себя, на свою пару и на x-default — три тега на страницу, 360 на весь сайт. Выбраны теги в head, а не карта сайта, потому что Яндекс больше не читает языковые версии из карт сайта.
Когда применять
Проводите аудит при запуске или переезде сайта, смене CMS или фронтенд-фреймворка, переходе на новый домен или HTTPS, добавлении языковых версий, а также когда трафик падает, хотя контент не менялся. На любом сайте, который получает из поиска заявки или продажи, раз в месяц проводите короткую проверку на час, а полный аудит делайте до того, как вкладываться в контент или ссылки.
Когда не применять
Не ждите, что техническая работа поднимет слабые страницы: когда страницу просканировали и проиндексировали, позицию определяют релевантность и качество. На сайте-визитке из 10 страниц с чистыми отчётами об индексировании долгий аудит — потерянное время: проверьте индексацию, скорость на мобильных и карту сайта, а силы потратьте на контент. И не гонитесь за идеальной оценкой в сервисе аудита, если Search Console и Яндекс Вебмастер не показывают реальных проблем.
Частые ошибки
- Закрывают страницу в robots.txt, чтобы убрать её из поиска. И Google, и Яндекс могут проиндексировать закрытый URL по ссылкам, а тег noindex робот не увидит на странице, которую ему нельзя загрузить.
- Дают противоречивые сигналы: canonical указывает на один URL, карта сайта перечисляет другой, а внутренние ссылки ведут на третий. Тогда поисковик выбирает за вас.
- Включают в карту сайта URL с редиректом, noindex или ответом 404. В карте должны быть только канонические страницы с ответом 200.
- Ставят noindex, чтобы сэкономить краулинговый бюджет. Google всё равно запрашивает такие страницы; сканирование экономят через robots.txt и сокращение дублей.
- Оценивают скорость по одному лабораторному тесту на быстром ноутбуке. Core Web Vitals оценивают по полевым данным на 75-м процентиле, отдельно для мобильных и настольных устройств.
Вопросы и ответы
Что входит в технический SEO-аудит сайта?
Технический SEO-аудит проверяет, могут ли поисковики сканировать, отрисовывать и индексировать важные страницы. Он охватывает robots.txt, правила noindex, canonical, редиректы и коды ответа, XML-карту сайта, внутренние ссылки, отрисовку JavaScript, hreflang, мобильную версию и Core Web Vitals. На выходе — упорядоченный список задач для разработчиков.
Что должно быть в техническом задании по SEO для разработчиков?
В каждой задаче указаны шаблон или маска URL, текущее поведение, нужное поведение и способ проверки. Например: URL отфильтрованного каталога отдают 200 и не имеют canonical, а должны указывать canonical на основную категорию; проверка — инструментом проверки URL. Задачи упорядочивают по трафику, который приходится на каждый шаблон.
Чем техническое SEO отличается от внутренней оптимизации?
Техническое SEO определяет, можно ли страницу найти, отрисовать и проиндексировать и какой URL её представляет. Внутренняя оптимизация работает с тем, что сказано на проиндексированной странице: заголовки, подзаголовки, текст, изображения и анкоры внутренних ссылок. Если страница закрыта, дублируется или отдаёт неверный код ответа, безупречная внутренняя оптимизация ничего не даст.
Закрывает ли robots.txt страницу от Google и Яндекса?
Нет. robots.txt управляет сканированием, а не индексированием. В Google Search Central сказано, что закрытый URL всё равно может попасть в индекс, если на него ссылаются другие страницы, а в справке Яндекс Вебмастера — что страницы, запрещённые в robots.txt, могут участвовать в поиске. Чтобы страницу не было в поиске, разрешите её сканировать и добавьте метатег noindex или заголовок X-Robots-Tag.
Влияют ли Core Web Vitals на ранжирование?
По словам Google, Core Web Vitals используют его системы ранжирования, но хорошие значения не гарантируют верхних позиций, потому что на первом месте релевантность. Целевые значения: LCP до 2,5 секунды, INP не больше 200 миллисекунд, CLS не больше 0,1 — по реальным визитам на 75-м процентиле.
Источники
- Google Search Central, In-depth guide to how Google Search works
- Google Search Central, SEO Starter Guide
- Google Search Central, Introduction to robots.txt
- Google Search Central, Block search indexing with noindex
- Google Search Central, How to specify a canonical URL
- Google Search Central, Build and submit a sitemap
- Google Search Central, Tell Google about localized versions of your page
- Google Search Central, Understand JavaScript SEO basics
- Google Search Central, Crawl budget management for large sites
- Google Search Central, Understanding Core Web Vitals and Google search results
- Google Search Central, Understanding page experience in Google Search results
- Google Search Central, Mobile-first indexing best practices
- Google Search Central, How HTTP status codes and network errors affect Google Search
- Google Search Central, Redirects and Google Search
- Google Search Console Help, Page indexing report
- Google Search Console Help, URL Inspection tool
- web.dev, Web Vitals
- web.dev, Rick Viscomi, Interaction to Next Paint becomes a Core Web Vital on March 12
- IETF, RFC 9309: Robots Exclusion Protocol (Koster, Illyes, Zeller, Sassman, 2022)
- sitemaps.org, Sitemaps XML format
- Yandex Webmaster Help, Using robots.txt
- Yandex Webmaster Help, Clean-param directive
- Yandex Webmaster Help, Canonical URLs
- Yandex Webmaster Help, Indexing localized pages
- Yandex Webmaster Help, Indexing pages with JavaScript
- Yandex Webmaster Help, IndexNow protocol support
- Yandex Webmaster Help, How do I notify Yandex about new and updated pages
- IndexNow.org, IndexNow protocol
- HTTP Archive, Web Almanac 2024: SEO chapter
Обновлено 15 октября 2026

Маркетинг в финтехе: где реклама упирается в комплаенс, KYC и лицензии
Агентство может собрать кампании. Но проверку рекламных обещаний, отвал на KYC и лицензионные правила разных рынков оно не контролирует, а именно они решают, станет ли лид клиентом.
Аудит маркетинга: чек-лист из 24 вопросов, который мы проходим в первую неделю
24 вопроса в пяти блоках, у каждого — чёткое условие зачёта. По этому чек-листу команда маркетинга оценит свою операционную часть до того, как звать помощь со стороны.
Директор по маркетингу на аутсорсе: что он даёт и что должно работать под ним
Приходящий директор по маркетингу приносит стратегию и опыт. Без отчётности, порядка в CRM и владельца у каждой цифры результатом его работы станет презентация, а не система.