RICE-приоритизация: формула и пример
RICE-скоринг ранжирует идеи для продукта и роста: охват, влияние и уверенность перемножают и делят на трудозатраты, так что очень разные идеи можно сравнить по одному числу.
RICE-скоринг — метод приоритизации, который ранжирует идеи по формуле Reach × Impact × Confidence ÷ Effort. Охват (Reach) — сколько людей затронет идея за выбранный период, Влияние (Impact) оценивает эффект для каждого из них, Уверенность (Confidence) снижает вес догадок, Трудозатраты (Effort) считаются в человеко-месяцах. Метод описал Шон Макбрайд в записи 2016 года в блоге Intercom: так можно сравнивать несхожие проекты по одной шкале.
- Автор
- Шон Макбрайд и продуктовая команда Intercom, 2016
- Уровень
- 201 · Инструмент
- Подходит
- стартап, малый и средний бизнес, растущая компания
- Время на внедрение
- два-три часа, чтобы впервые оценить бэклог из 20–30 идей; потом несколько минут на идею
- Что понадобится
- список идей, записанных как конкретные изменения, а не как темы · одна целевая метрика, по которой оценивается Impact · продуктовая аналитика, чтобы посчитать Reach, и человек, который может оценить трудозатраты
RICE-скоринг — метод приоритизации, который даёт каждой идее одно число: Reach, умноженный на Impact и на Confidence и делённый на Effort. Его описал Шон Макбрайд, продакт-менеджер Intercom, в записи “RICE: Simple prioritization for product managers”. На живой странице сейчас стоит дата 2018 года, но архивный оригинал показывает время публикации 15 марта 2016 года. Макбрайд писал, что его команда не нашла модель оценки, которая последовательно сравнивала бы разные идеи, и в августе предыдущего года начала строить собственную.
Продуктовые команды и команды роста берут этот метод, когда в бэклоге лежит то, что трудно сравнить: тест цены, правка онбординга, новая интеграция. Оценка показывает, сколько ценности каждая идея даёт на единицу работы.
Что измеряют четыре фактора
Каждый фактор отвечает на один вопрос, а Intercom задала для каждого фиксированную единицу или шкалу, чтобы оценки разных идей оставались сопоставимыми.
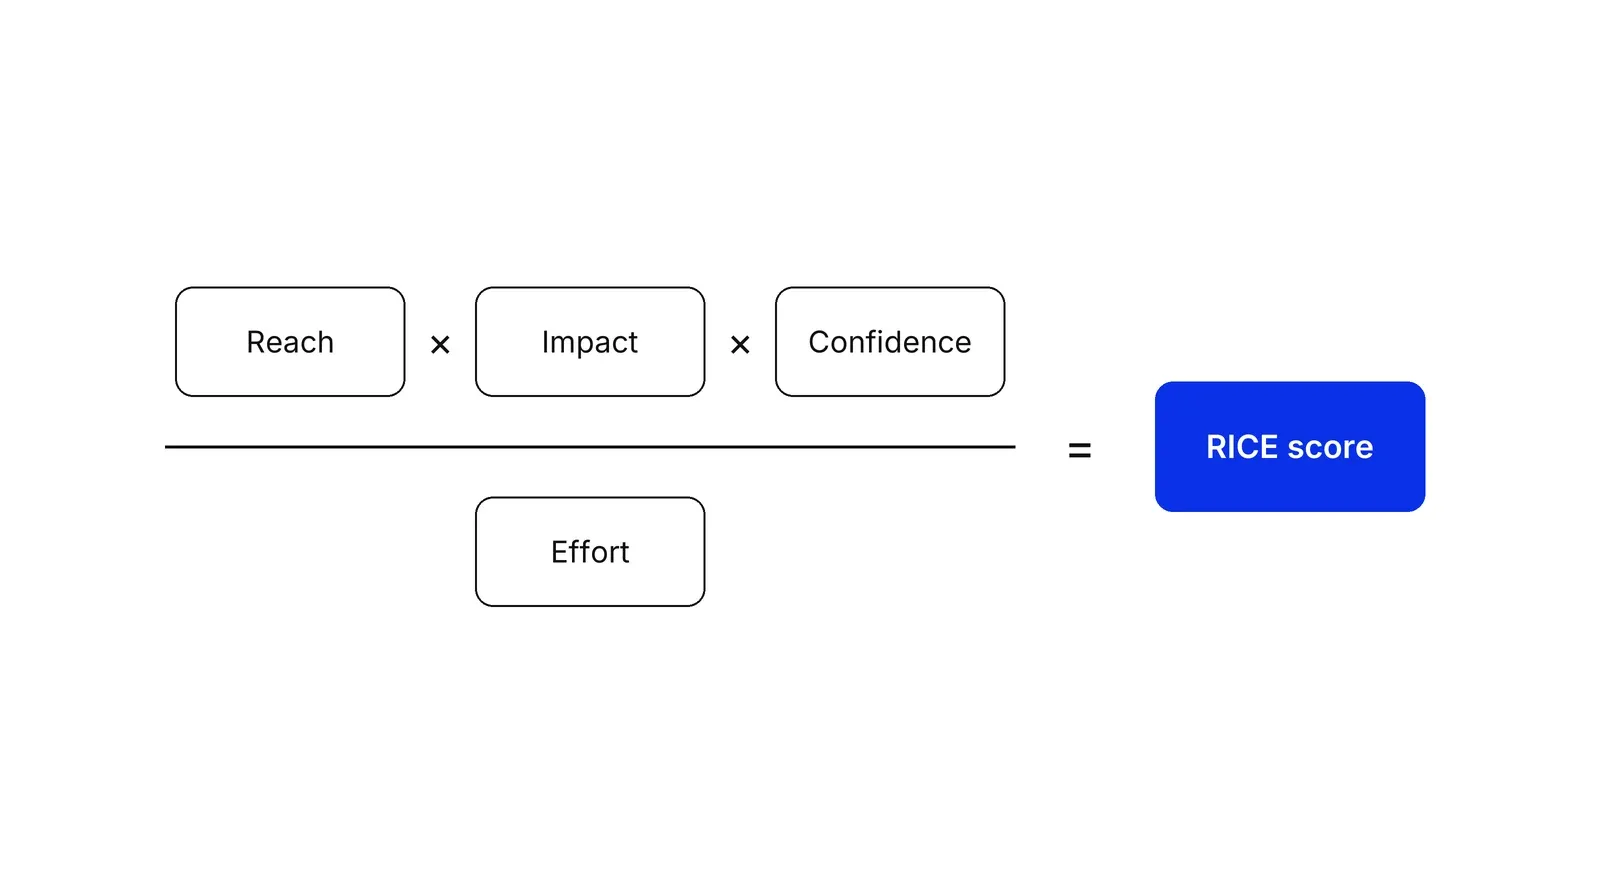
| Фактор | Вопрос | Единица или шкала в записи Intercom |
|---|---|---|
| Reach (охват) | Скольких людей или событий это коснётся за выбранный период? | Число, например клиентов за квартал |
| Impact (влияние) | Насколько это сдвинет цель для каждого, кого охватили? | 3 — огромное, 2 — высокое, 1 — среднее, 0,5 — низкое, 0,25 — минимальное |
| Confidence (уверенность) | Насколько мы уверены в остальных оценках? | 100% — высокая, 80% — средняя, 50% — низкая |
| Effort (трудозатраты) | Сколько работы потребуется? | Человеко-месяцы на продукт, дизайн и разработку |
Именно Reach отличает RICE от прежних способов оценки. Он заставляет команду считать людей по данным аналитики, а не ставить «важности» баллы на ощущение. Всё, что ниже 50% по Confidence, Макбрайд назвал «полной авантюрой» (total moonshot), а глоссарий ProductPlan повторяет совет заняться другими приоритетами.
Как считать RICE: пример расчёта
Возьмём команду роста финтех-приложения с одной целью на квартал: чтобы больше новых пользователей завершали первый перевод. На столе четыре идеи. Числа ниже — иллюстративная арифметика, а не данные реальной компании.
| Идея | Reach (человек за квартал) | Impact | Confidence | Effort (человеко-месяцы) | RICE-оценка |
|---|---|---|---|---|---|
| Более короткий шаг загрузки документов для KYC | 6 000 | 1 | 80% | 2 | 2 400 |
| Более понятная страница тарифов | 2 500 | 0,5 | 80% | 0,5 | 2 000 |
| Бонус за приглашение друга | 1 500 | 2 | 50% | 1 | 1 500 |
| Дашборд с аналитикой трат | 20 000 | 0,25 | 50% | 4 | 625 |
Дашборд охватывает больше всех людей, но оказывается последним. Эффект на каждого пользователя у него мал, доказательств у команды нет, а трудозатраты в восемь раз выше, чем у страницы с тарифами.
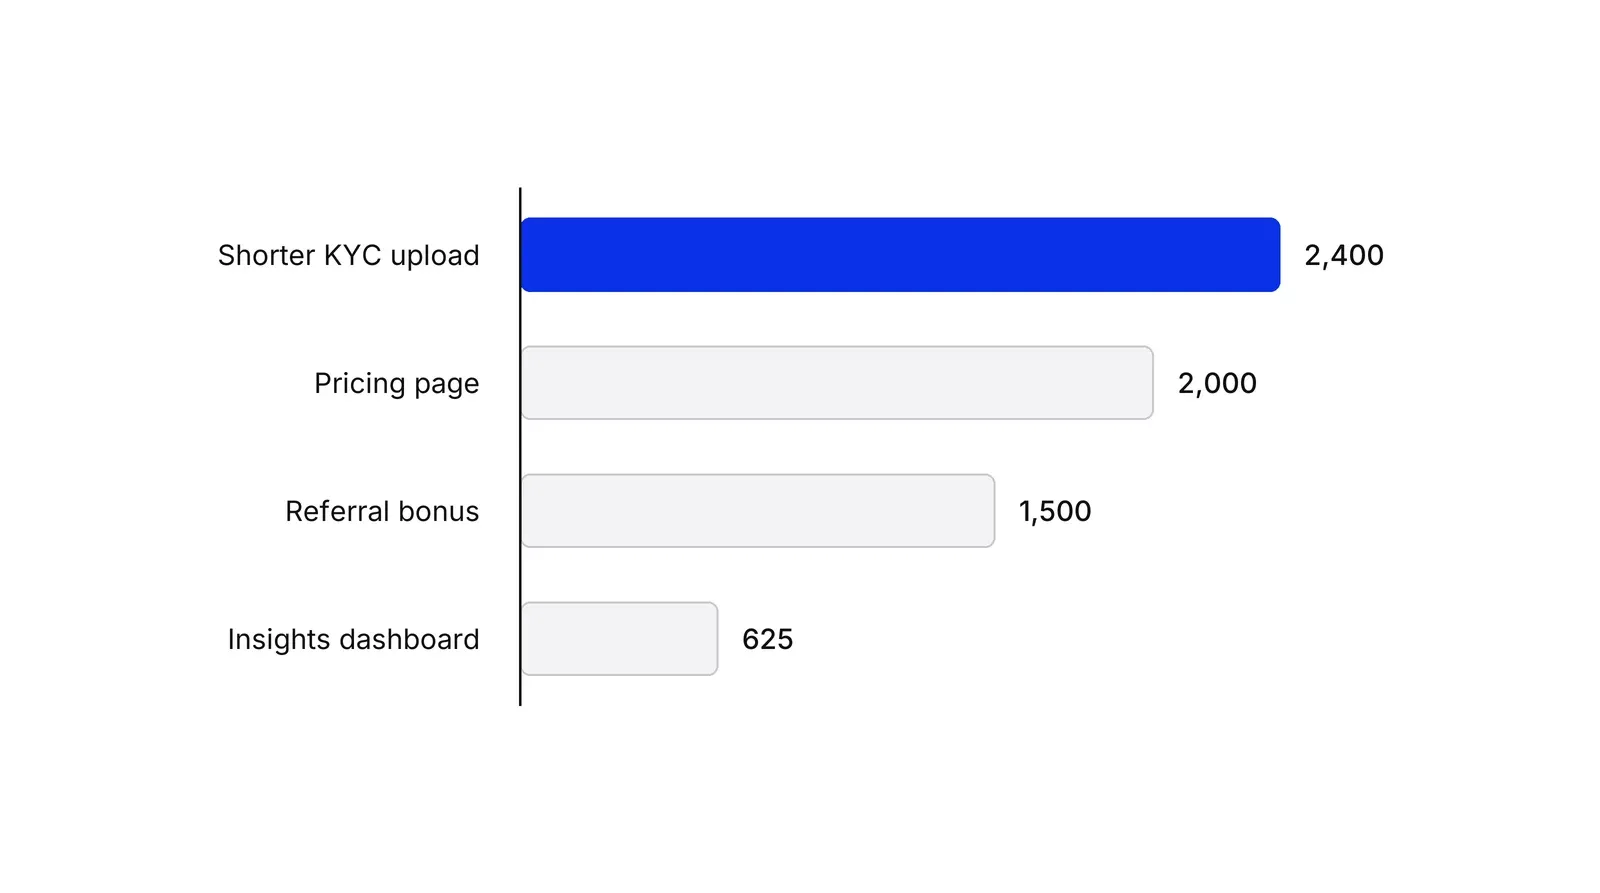
Теперь проверим, насколько шатко первое место. Снизим Confidence у идеи с KYC с 80% до 50%, и её оценка упадёт до 1 500, то есть сравняется с бонусом за приглашение. Одна честная правка в одном входе перетасовывает список, поэтому спорить стоит о входных данных, а не о результате.
RICE и ICE: чем отличаются и что ещё есть
RICE часто путают с ближайшим родственником — ICE. На выступлении в SaaStr 2016 года Шон Эллис описал ICE как оценку идеи теста по влиянию, уверенности и простоте, каждая от 1 до 10. Эллис, соавтор Hacking Growth, с его помощью решал, какие тесты роста запускать следующими. Источники расходятся, складывали ли три оценки изначально или перемножали; сейчас большинство команд перемножает.
| Метод | Формула | Для чего лучше всего | Главная слабость |
|---|---|---|---|
| RICE | Reach × Impact × Confidence ÷ Effort | Смешанные бэклоги продукта и роста, где есть данные аналитики | Считает людей, а не выручку |
| ICE | Impact, Confidence, Ease, каждый от 1 до 10 | Быстрое ранжирование экспериментов роста | Каждый вход — субъективная оценка |
| WSJF | Стоимость задержки ÷ размер работы | Большие программы, где ожидание стоит денег | Стоимость задержки трудно оценить |
| MoSCoW | Четыре корзины под жёсткий срок | Согласование объёма одного релиза | Нет ранжирования внутри корзины |
Weighted Shortest Job First из Scaled Agile Framework делит стоимость задержки на размер работы и приводит совет Дона Рейнертсена: если вы собираетесь количественно оценивать что-то одно, оценивайте стоимость задержки. Приоритизация MoSCoW отвечает на другой вопрос: что можно успеть к жёсткому сроку.
Делить ценность на затраты придумали давно
Логику деления ценности на затраты RICE не изобрёл. Йоахим Карлссон и Кевин Райан в 1997 году опубликовали в IEEE Software подход «стоимость-ценность»: они ранжировали требования к ПО по относительной ценности и относительной стоимости и проверили метод на двух телекоммуникационных проектах. В 1999 году Карл Вигерс предложил табличную модель, которая делит долю ценности каждой функции на взвешенную долю затрат и риска. Он предупреждал: результат — ориентир, и он применим «только к функциям, которые можно обсуждать».
Intercom добавила отдельный счёт Reach и скидку на Confidence. Исследования этих методов указывают и на ограничения. Обзор 2014 года по 73 исследованиям Филипа Ачимугу с коллегами нашёл 49 техник приоритизации и перечислил общие проблемы: они плохо масштабируются, с трудом пересчитывают ранги при изменении требований и не учитывают зависимости между ними. Последняя проблема есть и у RICE, потому что он оценивает каждую идею отдельно.
Почему Confidence и Effort обычно ошибочны
Большинство таблиц RICE завышают Confidence. Почему, показывают данные экспериментов Microsoft: в 2013 году Bing сообщал, что из идей, проверенных в контролируемых экспериментах, «менее трети» сдвинули те метрики, ради которых их придумали. В статье KDD 2013 Рона Кохави с коллегами добавлено, что многие идеи меняют ключевые метрики примерно на 1%, и заранее это плохо оценить. Сюрпризы бывают в обе стороны: Рон Кохави и Стефан Томке рассказывают в Harvard Business Review об изменении заголовка в Bing в 2012 году, которое подняло выручку на 12%, хотя идею сочли малоприоритетной и больше шести месяцев не трогали. Психологи Дон Мур и Пол Хили обнаружили, что избыточная точность, то есть чрезмерная уверенность в собственных убеждениях, — самая устойчивая форма самоуверенности.
Практическое лекарство — Confidence Meter Итамара Гилада: уверенность берётся только из доказательств. Мнения и тренды дают почти ноль, интервью — больше, а данные о реальном использовании из живого теста — больше всего.
С Effort всё наоборот: его обычно занижают. Роджер Бюлер с коллегами показали в 1994 году, что люди занижают время собственной работы: они представляют план и забывают о прошлом опыте. Бент Фливбьерг и Александр Будзир изучили 1 471 ИТ-проект и обнаружили среднее превышение стоимости на 27%, причём примерно у каждого шестого оно превысило 200%. Просите оценку трудозатрат у тех, кто делает работу, и сверяйте её с тем, сколько заняла похожая работа в прошлый раз.
Пользуйтесь оценкой, а исключения оформляйте письменно
В записи Макбрайда сказано, что RICE не должен быть жёстким правилом. Зависимости и обязательные функции могут оправдать работу вне очереди. Ольга Кашпур высказывает похожую мысль в Mind the Product: если два варианта различаются в оценке не больше чем на 20%, прекратите спорить о числе и решайте по суждению. Формулу поддерживают и инструменты: в Jira Product Discovery RICE можно собрать из пользовательских полей и формулы.
В нашей работе по Growth Lab идея из рейтинга становится гипотезой HADI-цикла с датой проверки, а измеренный результат в следующем раунде оценки заменяет предполагаемые Impact и Confidence.
Как применять: RICE-приоритизация: формула и пример по шагам
- Выберите цель и период. Запишите единственную метрику, по которой оцениваются все идеи, например конверсию из пробного периода в оплату, и период, за который считается Reach, обычно квартал. Без общей цели оценки Impact у каждого будут про своё. Результат: одно предложение в шапке таблицы оценок.
- Посчитайте Reach по данным. По каждой идее оцените, скольких людей или событий она коснётся за период, и берите цифры из аналитики, а не по памяти: пользователи, которые доходят до экрана, регистрации, дошедшие до шага, клиенты на тарифе. Результат: столбец реальных чисел в одной единице.
- Оцените Impact и Confidence по фиксированным шкалам. Impact оценивайте по шкале Intercom: 3, 2, 1, 0,5 или 0,25, а Confidence — 100%, 80% или 50%. Рядом с каждой оценкой уверенности запишите, на чём она держится: эксперимент, интервью или просто мнение. Результат: два столбца, которые любой может оспорить вопросом «где доказательства?».
- Оцените Effort в человеко-месяцах. Попросите тех, кто будет делать работу, оценить общее время на продукт, дизайн и разработку: целыми человеко-месяцами и 0,5 для всего, что заметно короче месяца. Результат: столбец затрат в одной единице.
- Посчитайте, отсортируйте и поспорьте с рейтингом. Перемножьте Reach, Impact и Confidence, поделите на Effort и отсортируйте по убыванию. Затем найдите оценки, которые кажутся неправильными, и перепроверьте их входные данные, а зависимости и обязательные функции, которые формула недооценивает, поднимите вручную. Результат: упорядоченный список и письменное объяснение для каждого исключения.
- Пересчитывайте, когда меняются данные. Когда эксперимент завершён, замените предполагаемые Impact и Confidence тем, что вы узнали, а остальной список пересчитывайте раз в квартал. Результат: бэклог, порядок которого отражает свежие данные, а не первые догадки.
Примеры
Маркетинговый квартал стоматологической клиники
Иллюстративный пример. Цель — меньше пустых часов у кресла. Цепочка SMS-напоминаний охватывает 1 200 пациентов, записанных за квартал; Impact 1 по неявкам, Confidence 80%, потому что система записи уже показывает: пациенты, получившие напоминание, пропускают меньше приёмов; Effort 0,5. Оценка: 1 920. Новый лендинг про имплантацию охватывает 900 посетителей, Impact 2, Confidence 50%, Effort 1: оценка 900. Серия видео во ВКонтакте охватывает 5 000 человек за квартал, Impact 0,25, Confidence 50%, Effort 2: оценка около 310. Напоминания идут первыми, хотя у видео самая большая аудитория.
Команда роста B2B SaaS и запрос от крупных клиентов
Иллюстративный пример. Чек-лист в продукте для пробных аккаунтов охватывает 2 000 пробных аккаунтов за квартал; Impact 1, Confidence 80%, Effort 1: оценка 1 600. Единый вход (SSO), о котором просили три крупных потенциальных клиента, охватывает 3 аккаунта; Impact 3, Confidence 100%, Effort 3: оценка 3. RICE считает людей, поэтому хоронит функцию, от которой зависят несколько крупных контрактов. Команда считает SSO обязательным условием корпоративного тарифа и ставит его в план вне рейтинга, записывая причину, — именно это допускает и сама запись Intercom.
Когда применять
Применяйте RICE, когда у команды роста или продукта идей больше, чем ресурсов, идеи разные по природе (тест цены, функция, правка онбординга) и данных аналитики хватает, чтобы посчитать Reach. Метод подходит для квартального планирования и бэклогов экспериментов: общая формула мешает самому громкому участнику диктовать порядок.
Когда не применять
Не используйте его для работы, которую нужно сделать в любом случае: требования закона, исправления безопасности, договорные обязательства. И для задач, которые зависят друг от друга, потому что оценка по каждому пункту этого не видит. RICE вводит в заблуждение и тогда, когда ценность сосредоточена у нескольких крупных клиентов: Reach считает людей, а не выручку. Для решений об объёме работ к жёсткому сроку лучше подходит MoSCoW.
Частые ошибки
- Смешивают единицы в Reach: у одной идеи считают пользователей за квартал, у другой — просмотры страницы за месяц.
- Ставят всем идеям Confidence 80% или 100% на основании мнений, и слабые идеи обгоняют проверенные.
- Дают оценить Effort только автору идеи, из-за чего любимые идеи выглядят дешёвыми.
- Принимают небольшой разрыв между двумя оценками за реальную разницу, хотя каждый вход — грубая догадка.
- Оценивают один раз и не обновляют числа после того, как эксперименты принесли реальные результаты.
Вопросы и ответы
Как рассчитать RICE-оценку?
Умножьте Reach на Impact и на Confidence, затем разделите на Effort. Идея, которая охватывает 2 000 пользователей за квартал, с Impact 1, Confidence 80% и Effort 2 человеко-месяца получает 2 000 × 1 × 0,8 ÷ 2 = 800. Число что-то значит только рядом с другими идеями, оценёнными в тех же единицах и по тем же шкалам.
Чем RICE отличается от ICE?
ICE, который связывают с Шоном Эллисом, оценивает Impact, Confidence и Ease от 1 до 10. RICE делит влияние на Reach, который считается в реальных людях, и Impact на каждого человека, а Ease заменяет на Effort в человеко-месяцах как делитель. RICE требует больше данных, зато его сложнее завысить. ICE быстрее для бэклога экспериментов роста.
Какая RICE-оценка считается хорошей?
Хорошей оценки в абсолютном выражении не существует. RICE относителен: число зависит от вашей единицы Reach, периода и единицы Effort, поэтому 500 может возглавить список одной команды и оказаться последним у другой. Сравнивайте оценки только внутри одного списка, а небольшие разрывы считайте ничьей.
Как приоритизировать бэклог методом RICE?
Договоритесь об одной целевой метрике и периоде, оцените все пункты по одним шкалам, отсортируйте по оценке, затем проверьте верх списка на зависимости и обязательные задачи, которые формула не видит. Пересчитывайте раз в квартал и после каждого эксперимента, заменяя догадки измеренными результатами.
Кто создал фреймворк RICE?
Шон Макбрайд, продакт-менеджер Intercom, опубликовал его в блоге Inside Intercom в марте 2016 года. Он описал систему оценок, которую его команда построила, потому что существующие модели не сравнивали идеи последовательно. На живой странице Intercom сейчас стоит дата 2018 года, но в архивной копии оригинала указано 15 марта 2016 года.
Источники
- Sean McBride, RICE: Simple prioritization for product managers, Inside Intercom
- Internet Archive, original Inside Intercom post on blog.intercom.com (published 15 March 2016), 2017 capture
- Joachim Karlsson, Kevin Ryan, A Cost-Value Approach for Prioritizing Requirements, IEEE Software 14(5), 1997
- Karl E. Wiegers, First Things First: Prioritizing Requirements, Software Development, September 1999
- Philip Achimugu, Ali Selamat, Roliana Ibrahim, Mohd Naz'ri Mahrin, A systematic literature review of software requirements prioritization research, Information and Software Technology 56, 2014
- SaaStr, Sean Ellis: Building a company-wide growth culture, SaaStr Annual 2016 transcript
- Penguin Random House, Hacking Growth by Sean Ellis and Morgan Brown, 2017
- Scaled Agile Framework, Weighted Shortest Job First
- Agile Business Consortium, DSDM Project Framework Handbook, MoSCoW Prioritisation
- Itamar Gilad, The Tool that Will Help You Choose Better Product Ideas (Confidence Meter)
- Bing Search Quality Insights, Ronny Kohavi and Harry Shum, Large Scale Experimentation at Bing, August 2013
- Ron Kohavi, Alex Deng, Brian Frasca, Toby Walker, Ya Xu, Nils Pohlmann, Online Controlled Experiments at Large Scale, KDD 2013
- Harvard Business Review, Ron Kohavi and Stefan Thomke, The Surprising Power of Online Experiments, 2017
- Don A. Moore, Paul J. Healy, The Trouble With Overconfidence, Psychological Review 115(2), 2008
- Roger Buehler, Dale Griffin, Michael Ross, Exploring the Planning Fallacy, Journal of Personality and Social Psychology 67(3), 1994
- Bent Flyvbjerg, Alexander Budzier, Why Your IT Project Might Be Riskier Than You Think, arXiv (Harvard Business Review, 2011)
- Harvard Business Review, Dan Lovallo and Daniel Kahneman, Delusions of Success: How Optimism Undermines Executives' Decisions, 2003
- Atlassian, Jira Product Discovery fields overview
- ProductPlan, RICE Scoring Model
- Mind the Product, Olha Kashpur, ROI is a PM tool, not a finance deliverable, 2026
Обновлено 15 октября 2026

Маркетинговое агентство или система роста: что нужно на каждом этапе масштабирования
Агентство подходит, пока фаундер сам ведёт большую часть процессов. Когда бизнес начинает копировать себя в новые точки и регионы, нужна система, которая ставит цели, проверяет гипотезы и отвечает за результат.
Агентство медицинского маркетинга: почему работа с клиникой буксует и какую модель используем мы
Большинство агентств отвечают за клик, а за регистратуру не отвечает никто. Как мы строим маркетинг клиники в трёх горизонтах, на каких исследованиях это основано и что дал один год работы.
Тестирование рекламных каналов: почему тест затухает на третьем месяце
Большинство тестов нового рекламного канала заканчиваются не решением. Они заканчиваются, когда кончился бюджет, поменялась атрибуция или все тихо перестали открывать дашборд.