Файл llms.txt: что это и пример
llms.txt — предложенный Markdown-файл в корне сайта: в нём коротко описано, о чём сайт, и перечислены чистые страницы, которые стоит прочитать языковой модели.
llms.txt — обычный Markdown-файл в корне сайта: короткое описание сайта и подобранный список ссылок на чистые Markdown-страницы для языковых моделей. Предложил его в сентябре 2024 года Джереми Ховард из Answer.AI. Это инициатива сообщества, а не веб-стандарт; Google говорит, что его Поиск файл не использует и что создание файла не повлияет на видимость ни в плюс, ни в минус.
- Автор
- Джереми Ховард (Answer.AI), 2024
- Уровень
- 401 · Экспертный
- Подходит
- стартап, малый и средний бизнес, растущая компания
- Время на внедрение
- около двух часов для сайта на 50–200 страниц
- Что понадобится
- список из 10–30 страниц, которые модели нужно прочитать в первую очередь · способ отдавать Markdown-копии этих страниц · доступ к корню сайта
llms.txt — обычный Markdown-файл в корне сайта, который объясняет языковой модели, что это за сайт и какие страницы читать первыми. Джереми Ховард из Answer.AI предложил его 3 сентября 2024 года. Предложение ведётся на llmstxt.org и в публичном репозитории. Это соглашение внутри сообщества: ни один орган по стандартизации его не принял.
Что лежит в файле
Порядок элементов в файле фиксирован, обязателен только первый. Спецификация требует заголовок H1 с названием сайта или проекта. Дальше идут необязательные: краткое описание в блоке цитаты, абзацы с подробностями и разделы H2 со списками ссылок, к каждой из которых дана короткая заметка. Раздел с названием Optional отмечает страницы, которые агент может пропустить, если ему нужно меньше контекста.
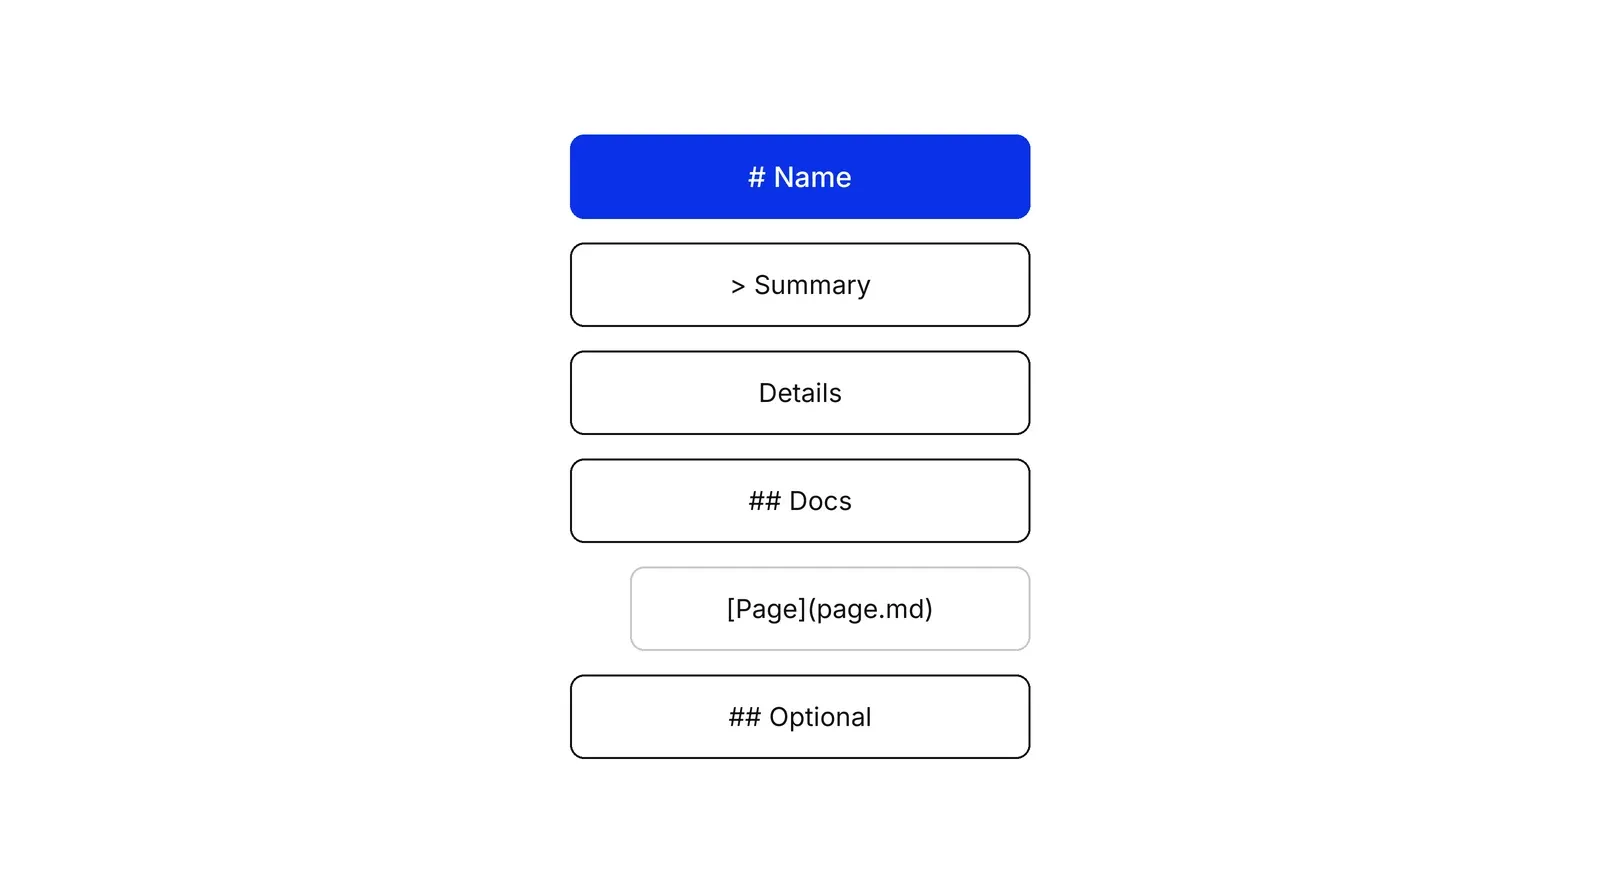
Вот иллюстративный файл для клиники:
# Светлая улыбка

> Семейная стоматологическая клиника в Казани. Цены, виды лечения и правила записи перечислены ниже.

Цены указаны в рублях.

## Лечение
- [Имплантация](/implants.md): этапы, восстановление, диапазон цен
- [Отбеливание](/whitening.md): варианты и замечания по безопасности

## Правила
- [Отмена записи и предоплата](/cancellation.md): правила и штрафы

## Optional
- [Наши врачи](/team.md)
Кроме того, в предложении просят сайты отдавать чистую Markdown-копию полезных страниц по тому же адресу с добавленным .md. На странице предложения (последнее изменение 10 августа 2026 года) описано обнаружение через ссылки rel="alternate" type="text/markdown" и rel="describedby", которые задают либо HTML-элементами link, либо HTTP-заголовками Link:. Реальные файлы идут дальше. Файл документации для разработчиков Anthropic группирует ссылки под заголовками H2 и H3 вроде Root URL, English и Messages, не содержит блока цитаты, каждый URL в нём заканчивается на .md, а полный текст лежит в отдельном llms-full.txt. Файл Stripe тоже начинается с инструкций для агентов по коду, например проверить в реестре пакетов последнюю версию.
Размеры сильно различаются. На 9 октября 2026 года собственный файл llmstxt.org весил 637 байт при 3 строках со ссылками, файл Vercel — около 5 КБ и 25 строк, файл OpenAI — около 6 КБ и 40 строк, файл Cloudflare — 17 КБ и 113 строк, файл Anthropic — 83 КБ и 761 строка, файл Stripe — 92 КБ и 482 строки. Большие файлы работают как индексы для инструментов, а не как страницы для человека.
Файл llms-full.txt на странице предложения не определён. Mintlify с 20 ноября 2024 года стала создавать оба файла для каждого сайта документации. В её записи названы Anthropic, Windsurf и Bolt.new как компании, использующие /llms.txt, и ChatGPT с Perplexity как инструменты, которые могут его использовать; это утверждение самой Mintlify, а не этих компаний. Полный файл складывает всю документацию в один Markdown-документ, так что разработчик может за один раз вставить помощнику по коду всю документацию. Сейчас на странице предложения среди инструментов, создающих файл, перечислены Mintlify, GitBook, Yoast SEO, AIOSEO и Wix. Yoast предлагает его бесплатно в Yoast SEO и не публикует данных о его эффекте.
Чем отличается от robots.txt и sitemap.xml
robots.txt описан в RFC 9309 и сообщает краулерам, какие URL им можно запрашивать; в самом RFC сказано, что эти правила не служат авторизацией доступа. RFC опубликован в сентябре 2022 года, у него четыре автора из Google. Карта сайта, определённая на sitemaps.org, перечисляет URL сайта, с лимитами 50 000 URL и 50 МБ на файл и 2 048 символов на URL. llms.txt — короткий список, который выбирает человек и пишет для чтения моделью.
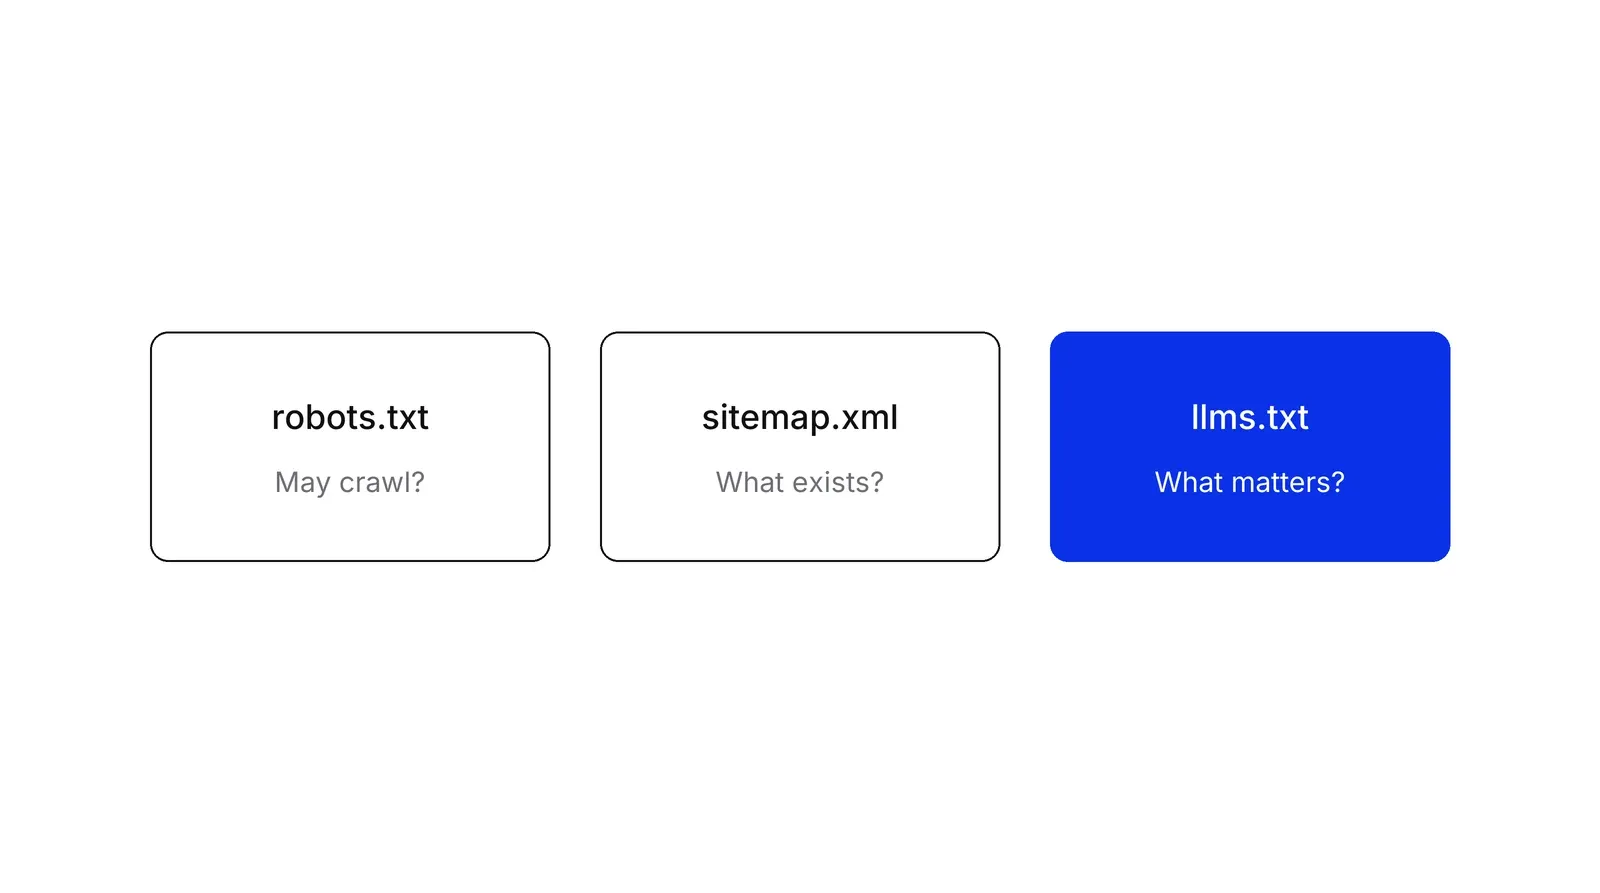
| Файл | На какой вопрос отвечает | Статус | Управляет доступом? |
|---|---|---|---|
| robots.txt | Какие URL краулер может запрашивать? | Стандарт IETF, RFC 9309 | Просит краулеры соблюдать правила |
| sitemap.xml | Какие URL существуют? | Общий протокол | Нет |
| llms.txt | Какие страницы важнее всего? | Предложение сообщества | Нет |
Блокировать ИИ-краулеры — задача robots.txt. OpenAI разделяет GPTBot (обучение), OAI-SearchBot (поиск ChatGPT) и ChatGPT-User (действия по запросу пользователя, к которым правила robots.txt могут не применяться). Anthropic разделяет ClaudeBot, Claude-User и Claude-SearchBot. Обе компании описывают управление через robots.txt.
Читают ли его ИИ-компании и поисковики
В публичных заявлениях, которые разобраны для этой страницы, ни Google, ни OpenAI, ни Anthropic не говорят, что их продукт читает llms.txt, чтобы находить, ранжировать или цитировать сайты. Хронология по датам:
- 17 июня 2025 года. Джон Мюллер из Google написал в Bluesky, что сейчас ни одна ИИ-система не использует llms.txt, и добавил, что по логам сервера чат-боты забирают страницы, но не этот файл (Search Engine Roundtable).
- 2025 год. Search Engine Journal сообщает, что Гэри Иллис (Gary Illyes) и Амир Табоул (Amir Taboul) сказали на мероприятии Search Central Live Deep Dive в Азиатско-Тихоокеанском регионе, что Google такой файл не развивает. Даты в публикации нет, а сведения пересказаны из вторых рук.
- Декабрь 2025 года. Файл llms.txt, который Лидия Инфанте (Lidia Infante) заметила в документации Google Search Central, убрали в течение нескольких часов, говорится в той же публикации. Дейв Смарт (Dave Smart) нашёл похожие файлы на developer.chrome.com и web.dev и предположил, что это автоматическое обновление CMS, а не решение команды Поиска.
- Май 2026 года. Lighthouse 13.3 в Chrome получил проверку llms.txt в экспериментальной категории Agentic Browsing, которая стоит рядом с проверками WebMCP. На странице файл назван необязательным, ошибка 404 не считается провалом, а для проверки категории нужен Chrome 150 или новее.
- 2 июня 2026 года. Search Engine Journal сообщил, что Мюллер назвал пользу файла «пока что чисто умозрительной» на Reddit (Search Engine Journal).
- 15 июня 2026 года. Search Engine Journal сообщил, что в подкасте Google Search Off the Record он сказал: файл, который сайт составил сам о себе, не поможет системе отличать сайты друг от друга, но может помочь агенту, который уже находится на сайте (Search Engine Journal).
- Июль 2026 года. В руководстве Google по генеративным ИИ-функциям, обновлённом 10 июля 2026 года, сказано, что новые машиночитаемые файлы не нужны. Там же добавлено, что создавать llms.txt можно, и это не навредит и не поможет видимости. Версия страницы Google об ИИ-функциях за декабрь 2025 года тоже говорит, что особые файлы и разметка не нужны.
OpenAI и Anthropic публикуют llms.txt для собственной документации для разработчиков, а страница OpenAI о краулерах ссылается на свой файл. Но в документации по краулерам обеих компаний не сказано, что их боты используют этот файл, заходя на чужие сайты.
Измерения с этим согласуются. SE Ranking проверила почти 300 000 доменов в исследовании, опубликованном 7 ноября 2025 года, а Search Engine Journal пересказал его 20 ноября 2025 года. Файл был у 10,13% доменов, и в корреляции Спирмена, в моделях XGBoost и в анализе SHAP он не показал измеримой связи с тем, как часто домен цитируют ИИ-ответы. Без этой переменной модель XGBoost стала точнее. Авторы оговариваются, что результат зависит от использованных данных и моделей.
Итак, llms.txt не фактор ранжирования, и никто не показал, что он влияет на цитирование. Очевидная польза у него гораздо уже: разработчики и агенты по коду, которые загружают документацию намеренно.
Что действительно делает контент читаемым для моделей
Данные указывают на страницы, а не на файл. Анализ Vercel по своей сети, опубликованный 17 декабря 2024 года, показал, что GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot и остальные основные ИИ-краулеры, которые она изучила, не отрисовывали JavaScript. В том месяце Vercel зафиксировала 569 млн запросов GPTBot, 370 млн от Claude, 314 млн от AppleBot и 24,4 млн от PerplexityBot против 4,5 млрд у Googlebot. Краулеры ChatGPT и Claude скачивали файлы JavaScript (11,50% и 23,84% их запросов), но не выполняли их. Текст, который появляется только после выполнения скриптов, ИИ-краулерам не виден, а Gemini от Google пользуется отрисовкой Googlebot. Первое, что стоит исправить: отдавать HTML, отрисованный на сервере, с настоящими заголовками. Это входит в проверки технического SEO.
Cloudflare измерила собственную страницу: примерно 16 180 токенов в HTML и 3 150 в Markdown, то есть на 80% меньше. Заголовок вроде ## About Us стоит в Markdown около 3 токенов, а в HTML — 12–15. С 12 февраля 2026 года Cloudflare превращает страницы в Markdown на сайтах с тарифами Pro, Business и Enterprise, где функция включена, когда клиент присылает заголовок Accept: text/markdown, и добавляет заголовок x-markdown-tokens с оценкой числа токенов. В статье 2023 года «Lost in the Middle» Нельсон Лю (Nelson Liu) с коллегами обнаружили, что точность модели выше всего, когда нужная информация стоит в начале или в конце входных данных. Ставьте ответ первым.
В руководстве Google также сказано, что дробить контент на мелкие куски не нужно и идеальной длины страницы нет, поэтому пишите прежде всего для читателей. В статье про GEO Пранджала Аггарвала (Pranjal Aggarwal) с коллегами, принятой на KDD 2024, сообщается, что изменения контента повышали видимость в ответах генеративных систем на её тестовом наборе до 40%. Авторство и указание источников, о которых речь в разделе про E-E-A-T, работают на ту же цель.
Если вместе с остальной работой над контентом вам нужна проверка готовности к ИИ, начните с практики AI for Real Work.
Как применять: Файл llms.txt: что это и пример по шагам
- Определите, для кого файл. Решите, кому он служит: разработчикам и ИИ-помощникам по коду, которые загружают документацию, или агентам, которые заходят на сайт за ценами и условиями. Результат: описание назначения в одном предложении, по которому решается, какие страницы войдут.
- Выберите страницы, которые отвечают на реальные вопросы. Выпишите страницы, нужные модели для вопросов о продукте, цене, условиях и контактах. Архивы и страницы тегов пропустите. Результат: 10–30 ссылок, сгруппированных под короткими заголовками.
- Сделайте чистую Markdown-копию каждой страницы. Отдавайте каждую страницу из списка по собственному адресу с добавленным .md, без меню, баннеров и скриптов. Результат: каждую страницу из списка можно прочитать, не разбирая HTML.
- Напишите файл. Один заголовок H1 с названием сайта, краткое описание в одну-две фразы в блоке цитаты, затем ссылки под заголовками H2 с парой слов о каждой. Второстепенные страницы отнесите в раздел Optional. Результат: файл, который человек прочтёт за минуту.
- Опубликуйте и проверьте, что файл открывается. Загрузите его так, чтобы он открывался по адресу /llms.txt с кодом 200, и откройте каждую ссылку из списка. Результат: рабочий файл, к которому нет претензий у Lighthouse.
- Поищите признаки того, что файл читают. Найдите в логах сервера запросы к /llms.txt и к .md-страницам, разбейте их по user agent и сравните с названиями краулеров, которые публикуют OpenAI и Anthropic. Результат: ответ по логам на вопрос, читает ли файл хоть кто-то.
Примеры
Сайт документации для разработчиков
Иллюстративный пример. API платёжного сервиса отдаёт свои 300 страниц в Markdown и выносит 25 основных в разделы «Быстрый старт», «Справочник API» и «Вебхуки», а списки изменений кладёт в Optional. Разработчик вставляет ссылку на файл в ИИ-помощника по коду, и тот загружает перечисленные страницы. Для такого сценария предложение и писалось.
Стоматологическая клиника
Иллюстративный пример. Клиника перечисляет виды лечения, диапазоны цен, правила отмены и шаги записи и делает Markdown-копию каждой страницы. В рекомендациях Google нет утверждения, что это помогает ранжированию, поэтому клиника считает файл недорогим дополнением. Важнее сами страницы: цены обычным текстом, квалификация врача и заметная дата проверки.
Справочный центр SaaS-компании
Иллюстративный пример. Софтверная компания с 400 справочными статьями выносит 30 самых посещаемых под заголовки по задачам и не включает старые заметки о релизах. Нужен ли файл дальше, решают логи, которые она проверяет раз в квартал.
Когда применять
Подключайте llms.txt, если разработчики или агенты загружают вашу документацию в модель, если платформа документации создаёт файл бесплатно или если вам нужна одна вручную поддерживаемая карта ключевых страниц.
Когда не применять
Не ждите от него роста позиций или цитирований в ИИ-ответах и не заводите под него отдельный проект. Файл публичный, поэтому закрытых страниц в нём быть не должно. На сайтах, которые меняются каждый день, файл нужно генерировать автоматически, иначе он не нужен.
Частые ошибки
- Считают файл фактором ранжирования. Google пишет, что файл не помогает и не вредит видимости в его генеративных ИИ-функциях.
- Перечисляют все страницы. Карта сайта с описаниями не даёт краулеру ничего сверх обычной карты сайта.
- Ссылаются на HTML-страницы, перегруженные скриптами. В предложении просят чистые Markdown-версии.
- Не следят за актуальностью. Ссылки на удалённые страницы и старые цены скармливают неверные факты всему, что файл всё же читает.
- Пропускают основы. Страницы, текст на которых появляется только после выполнения JavaScript, остаются нечитаемыми для основных ИИ-краулеров, которые изучила Vercel.
Вопросы и ответы
Что такое файл llms.txt?
Это Markdown-документ в корне сайта, обычно /llms.txt: в нём указано название сайта, дано его краткое описание и перечислены самые полезные страницы. Джереми Ховард предложил его на Answer.AI в сентябре 2024 года, чтобы модели получали подобранный путеводитель вместо сырого HTML.
Использует ли Google llms.txt?
Google говорит, что Поиск его не использует. В руководстве по генеративным ИИ-функциям сказано, что создавать файл можно, и он не навредит и не поможет видимости. Джон Мюллер заявлял, что сейчас ни одна ИИ-система его не использует. В Chrome Lighthouse есть необязательная проверка llms.txt.
Что такое llms-full.txt?
Парный файл, который Mintlify начала создавать в ноябре 2024 года. В нём весь текст документации лежит в одном Markdown-файле, чтобы помощник по коду загружал всё сразу. На странице предложения llmstxt.org он не определён, поэтому форматы у разных инструментов различаются.
Чем llms.txt отличается от robots.txt и sitemap.xml?
robots.txt сообщает краулерам, какие URL им можно запрашивать, а sitemap.xml перечисляет существующие URL. llms.txt — короткий список важных страниц с пояснениями, который пишут для чтения моделью. Он ничем не управляет и стандартом не считается, тогда как robots.txt описан в RFC 9309.
Нужен ли генератор llms.txt?
Для небольшого сайта нет, хватит текстового редактора. Для крупных сайтов файл создают и обновляют Mintlify, GitBook и Yoast SEO.
Источники
- Jeremy Howard, The /llms.txt file (llmstxt.org)
- Answer.AI, /llms.txt: a proposal to provide information to help LLMs use websites
- AnswerDotAI, llms-txt repository
- Google Search Central, Guide to optimizing for generative AI features on Google Search
- Google Search Central, AI features and your website
- Chrome for Developers, Lighthouse agentic browsing: llms.txt audit
- Chrome for Developers, Lighthouse agentic browsing category
- Search Engine Roundtable, Google: No AI System Currently Uses LLMs.txt
- Search Engine Journal, Google says llms.txt is purely speculative for now
- Search Engine Journal, Google's Mueller says llms.txt can't help LLMs differentiate sites
- Search Engine Journal, Google's llms.txt guidance depends on which product you ask
- Search Engine Journal, llms.txt shows no clear effect on AI citations
- SE Ranking, LLMs.txt study of nearly 300,000 domains
- Mintlify, Simplifying docs for AI with /llms.txt
- Anthropic, Developer documentation llms.txt
- Stripe, Documentation llms.txt
- Yoast, llms.txt feature in Yoast SEO
- OpenAI, Overview of OpenAI crawlers
- Anthropic, Does Anthropic crawl data from the web
- IETF, RFC 9309: Robots Exclusion Protocol
- sitemaps.org, Sitemap protocol
- Cloudflare, Markdown for Agents
- Vercel, The rise of the AI crawler
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts
- Aggarwal et al., GEO: Generative Engine Optimization (KDD 2024)
Обновлено 15 октября 2026

Маркетинг в финтехе: где реклама упирается в комплаенс, KYC и лицензии
Агентство может собрать кампании. Но проверку рекламных обещаний, отвал на KYC и лицензионные правила разных рынков оно не контролирует, а именно они решают, станет ли лид клиентом.
Аудит маркетинга: чек-лист из 24 вопросов, который мы проходим в первую неделю
24 вопроса в пяти блоках, у каждого — чёткое условие зачёта. По этому чек-листу команда маркетинга оценит свою операционную часть до того, как звать помощь со стороны.
Директор по маркетингу на аутсорсе: что он даёт и что должно работать под ним
Приходящий директор по маркетингу приносит стратегию и опыт. Без отчётности, порядка в CRM и владельца у каждой цифры результатом его работы станет презентация, а не система.