Видимость в нейросетях: что это и как измерить
Доля голоса в AI-ответах — это доля ответов нейросетей, в которых бренд назван или процитирован, по сравнению с конкурентами. Считают её по фиксированному набору промптов и многократным повторным запускам.
Видимость в нейросетях показывает, как часто ИИ-ассистенты называют или цитируют ваш бренд по сравнению с конкурентами. Для замера берут фиксированный набор промптов из вашей категории и прогоняют его много раз. Название заимствовано у рекламной доли голоса, но здесь считают не бюджет, а упоминания в ответах. Ответы меняются от запуска к запуску, поэтому нужны повторные замеры и указание погрешности.
- Автор
- Практика с 2024 года, заимствует рекламную долю голоса (Джеймс Шроер, HBR, 1990; Лес Бине и Питер Филд, IPA), с 2024 года (доля голоса: 1990)
- Уровень
- 401 · Экспертный
- Подходит
- малый и средний бизнес, растущая компания
- Время на внедрение
- один день на набор промптов, затем замер раз в неделю или раз в месяц
- Что понадобится
- список из 3–5 прямых конкурентов с теми написаниями названий, которыми пользуются люди · 20–50 промптов, которые набрали бы реальные покупатели, сгруппированных по ситуациям покупки · доступ к ассистентам, которые вы хотите отслеживать, либо сервис, который их запускает и хранит каждый сырой ответ
Доля голоса в AI-ответах — это доля сгенерированных ответов, в которых бренд назван или процитирован, по фиксированному набору промптов и в сравнении с конкурентами. Так измеряют присутствие бренда в ответах ChatGPT, Claude, Gemini и AI Overviews от Google. Термин новый, а стандартной методики нет. Ниже — способ замера, который выдерживает проверку: он опирается на рекламные исследования, которым не одно десятилетие, и на то, что известно о разбросе ответов языковых моделей.
Откуда взялось название
Классическая доля голоса (SOV) — доля бренда в рекламных расходах его категории. Джеймс Шроер (James Schroer) в статье Harvard Business Review за январь 1990 года описал эффект доли голоса: на большинстве потребительских рынков бюджеты стабильны, и чтобы отвоевать долю, претенденту нужно превзойти по расходам крупнейшего соперника как минимум на 100%.
Доказательства этой идеи собрал IPA, британский институт рекламы. Лес Бине и Питер Филд определили избыточную долю голоса (ESOV) как SOV минус долю рынка (SOM) в работе Effectiveness in Context. По их модели, бренды, у которых SOV выше SOM, обычно растут, а те, у кого ниже, теряют долю. В базе кампаний IPA Databank за 1998–2016 годы офлайн-бренды прибавляли около 0,5 пункта доли рынка на каждые 10 пунктов ESOV, а онлайн-бренды — около 1,3. Авторы отмечают, что данные состоят из заявок на премии, поэтому закономерность наблюдательная, а не экспериментальная. Эту оговорку подробно разбирает страница о правиле 60/40 Бине и Филда.
Ближайший цифровой родственник — доля поиска (share of search). Бине представил её в октябре 2020 года: это доля бренда в органических запросах Google по его категории. Он сообщил, что в трёх категориях она опережала долю рынка — для автомобилей на срок до года, — и назвал её «отнюдь не панацеей». У доли голоса в AI-ответах такой истории нет. Пока никто не показал, что она предсказывает продажи, считайте её мерой видимости.
Что именно считать
Выберите одну единицу и один знаменатель и не меняйте их. Самый чистый вариант — три показателя, у каждого свой знаменатель.
| Показатель | Что считаем | Знаменатель |
|---|---|---|
| Доля упоминаний | Ответы, где назван бренд | Все собранные ответы |
| Доля цитат | Ответы со ссылкой на ваш домен | Все собранные ответы |
| Доля голоса | Упоминания бренда | Упоминания всех отслеживаемых брендов |
Упоминание и цитата — разные события, и у бренда может быть одно без другого.
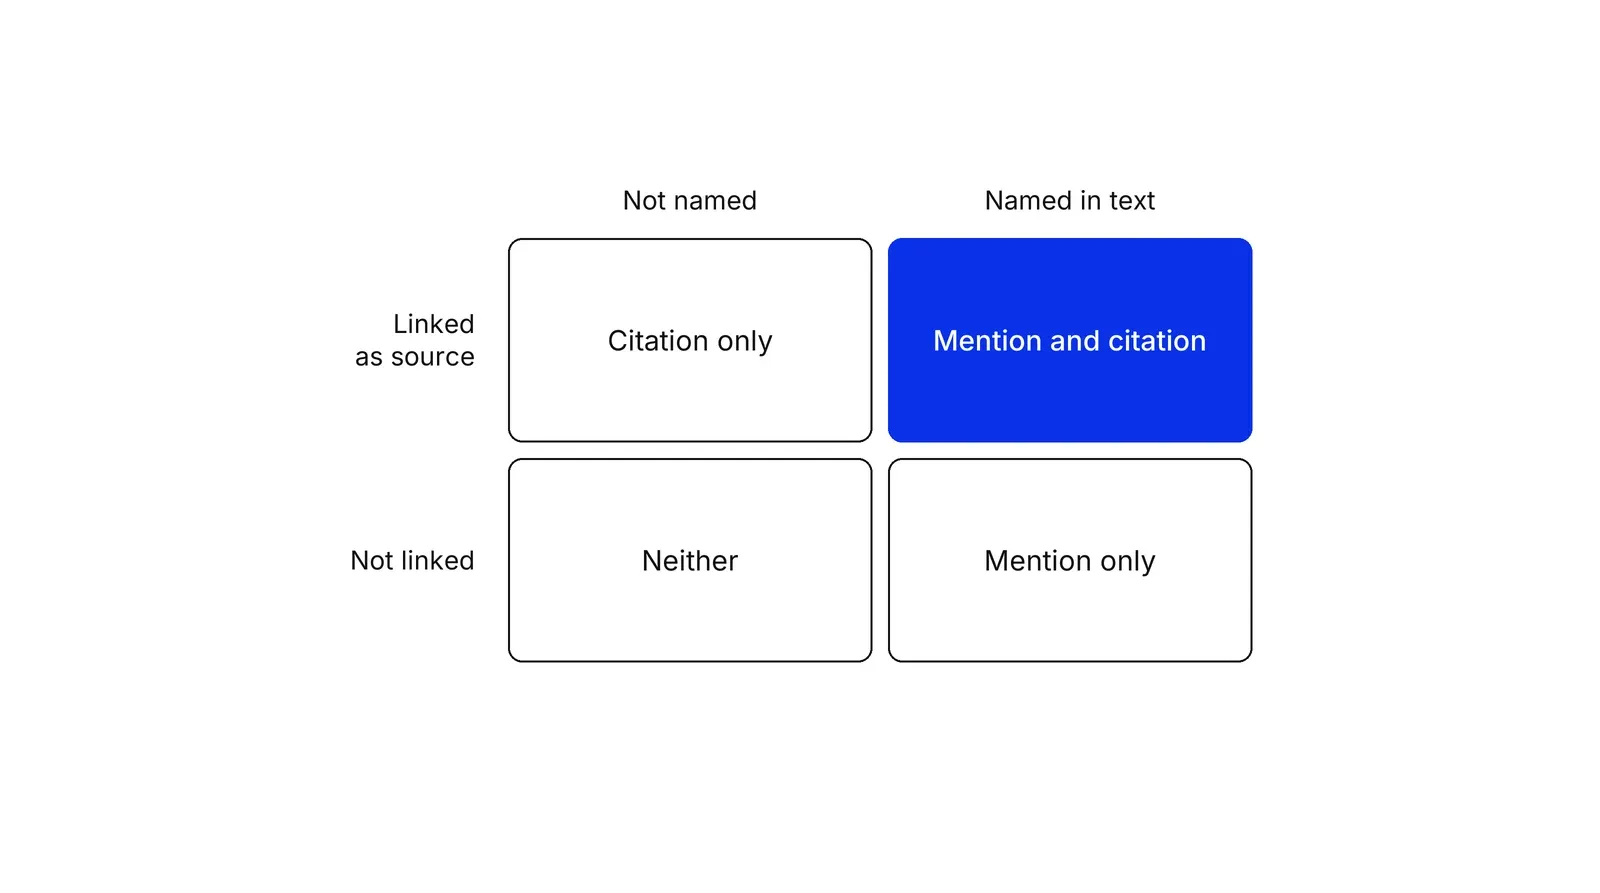
Цитаты собрать проще. Инструмент веб-поиска OpenAI возвращает аннотации url_citation с адресом, заголовком и позицией в тексте, а инструмент веб-поиска Anthropic всегда отдаёт цитаты с адресом, заголовком и выдержкой из источника. Отчёт Generative AI performance в Search Console, описанный в документации Google об ИИ-функциях, показывает показы ссылок в AI Overviews и AI Mode. По руководству самого Google, именно так можно увидеть, как ваш контент работает в этих функциях, а сторонние сервисы заглянуть внутрь систем Google не могут.
Цитата к тому же не гарантирует, что источник подтверждает сказанное. Лю, Чжан и Лян в 2023 году проверили четыре генеративные поисковые системы: 51,5% предложений полностью подтверждались своими цитатами, а 74,5% цитат подтверждали своё предложение. В тесте Tow Center за март 2025 года восемь инструментов работали с фрагментами новостей и более чем на 60% запросов ответили неверно. Записывайте и текст ответа, чтобы видеть, как описан бренд.
Как собрать набор промптов
Собирайте его из ситуаций покупки, а не из ключевых слов. Точки входа в категорию по версии Ehrenberg-Bass Institute — это моменты и сигналы, из-за которых человек вспоминает о категории. Каждая такая точка — семейство промптов: проблема, бюджет, сценарий использования, место. Добавьте формулировки клиентов из звонков продаж и отзывов: промпты, написанные маркетологами, дрейфуют к их собственному словарю. См. страницы про точки входа в категорию и голос клиента.
Формулировка влияет сильнее, чем кажется. В исследовании SparkToro 142 человека с одной и той же потребностью, наушниками, написали промпты со средним семантическим сходством 0,081. Склар с коллегами обнаружили, что у открытых моделей точность меняется до 76 пунктов из-за правок формата, не затрагивающих смысл. Включайте в набор несколько формулировок каждого промпта и помечайте тип: небрендовый, со сравнением или брендовый. Брендовые промпты показывают, помнят ли вас, небрендовые — находят ли вас.
Почему один запуск почти ничего не говорит
Один и тот же промпт даёт разные ответы по трём отдельным причинам.
- Модель. Атил с коллегами запустили пять LLM в детерминированном режиме по 10 раз на восьми задачах. Ни одна модель не выдала одинаковые результаты по всем задачам, а точность между запусками расходилась до 15%. Thinking Machines объяснили значительную часть этого тем, что нагрузка на сервер меняет размер батча; в тесте на 1 000 генераций при температуре 0 они получили 80 различных вариантов.
- Шаг поиска. Google описывает AI Mode как систему, которая запускает несколько связанных поисков по подтемам, поэтому страницы, из которых строится ответ, могут меняться.
- Набор источников у ассистента. Чэнь с коллегами выяснили, что ИИ-поиск чаще опирается на сторонние публикации (earned media), чем на контент самих брендов, а ассистенты различаются тем, насколько чувствительны к формулировкам и к свежести материалов.
SparkToro и Gumshoe.ai попросили около 600 добровольцев запустить 12 промптов 2 961 раз в ChatGPT, Claude и Google. Повтор того же списка брендов оказался событием реже одного на сто, а совпадение порядка — реже одного на тысячу. Видимость бренда по запускам была стабильнее его позиции. Исследование не прошло рецензирование, его авторы говорят, что они не профессиональные исследователи, а Gumshoe продаёт сервис отслеживания, так что читайте его как серьёзное предупреждение, а не как стандарт измерения.
Практический ответ — повторная выборка и интервал. Интервал Уилсона, который Браун, Кай и ДасГупта рекомендуют вместо распространённой формулы Вальда, подходит для малых выборок. Если бренд назван в 6 из 10 запусков, 95-процентный интервал составляет примерно от 31% до 83%. При 100 запусках и истинной доле 50% диапазон сужается примерно до 9,6 пункта в каждую сторону.
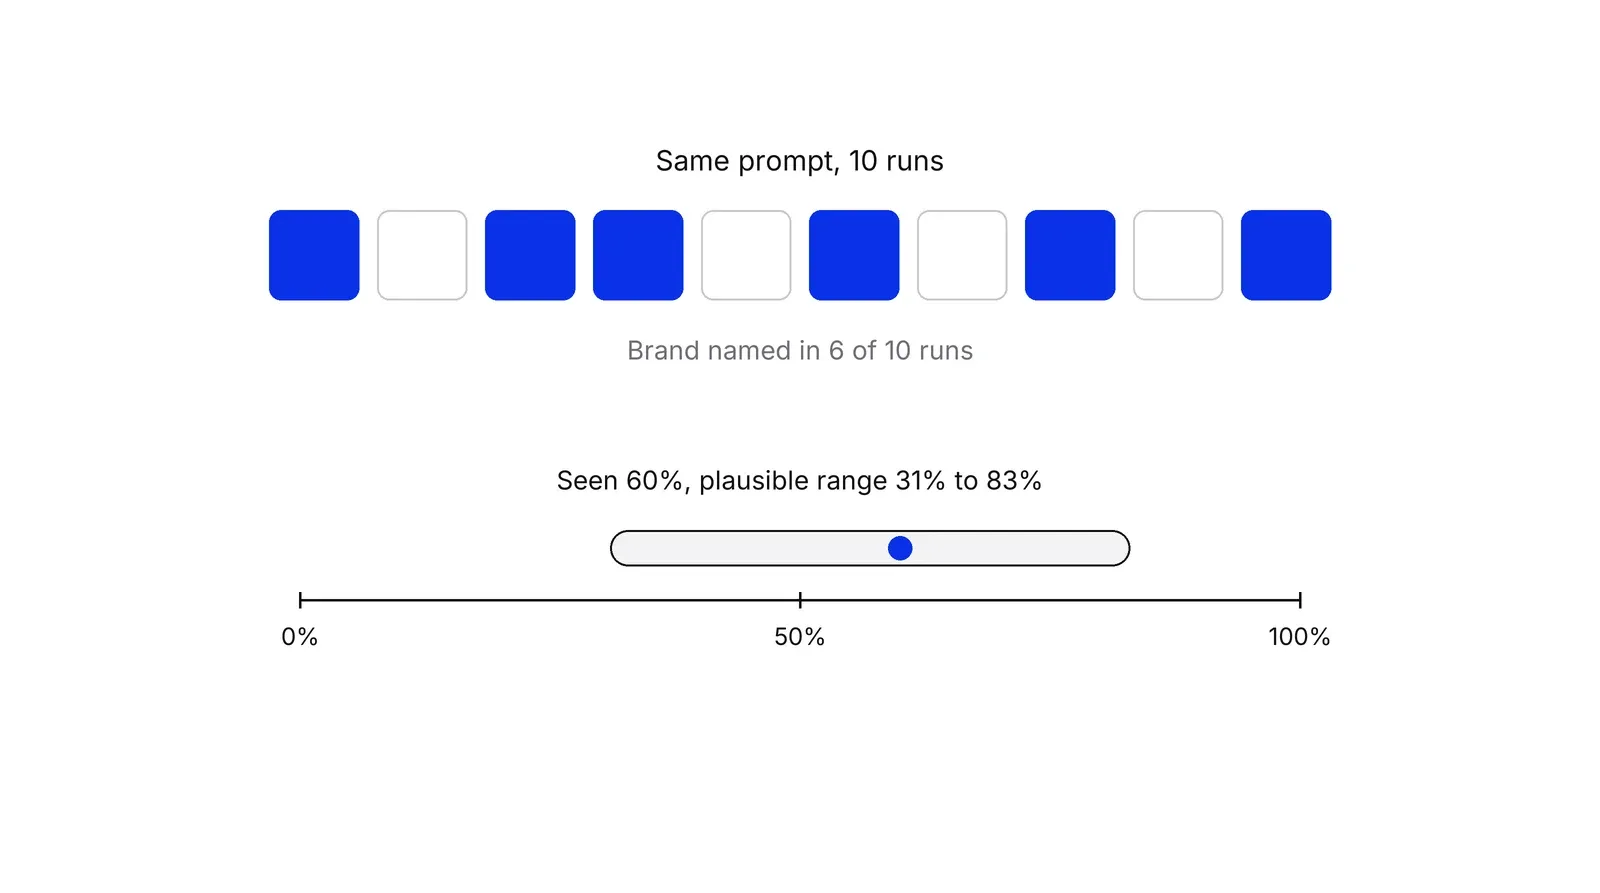
Статья Миллера об ошибках измерения говорит то же о проверке моделей: сообщайте неопределённость, а не голую оценку. Изменение считается реальным, когда интервалы расходятся или сдвиг повторяется в нескольких замерах.
Что заявляют сервисы
Сервисы автоматизируют запуски. Ahrefs пишет, что Brand Radar отслеживает упоминания и цитаты в AI Overviews, AI Mode, Perplexity, Copilot, Gemini и ChatGPT, берёт промпты, по его словам, из реальных поисковых данных и проверяет ежедневно, еженедельно или ежемесячно. Semrush пишет, что его набор инструментов считает AI Visibility Score — как часто бренд упоминается, — и включает долю голоса в отчёты по бренду, но формулу не приводит. Peec AI заявляет, что показывает видимость, позицию и тональность. Profound заявляет, что охватывает аналитику цитат, тональность и оценку видимости по площадкам. Это описания самих вендоров, и мы ни один из сервисов независимо не проверяли. Спросите у каждого, сколько запусков на промпт он делает, выгружает ли сырые ответы и показывает ли интервал, а любой «рейтинг в ИИ» воспринимайте как слабый сигнал, каким его назвал SparkToro.
Важны ли упоминания, если никто не кликает
Клики — только часть картины. По анализу Pew на выборке в 900 взрослых американцев, люди кликали по обычному результату в 8% визитов, когда показывалась ИИ-сводка, и в 15% визитов без неё, а по ссылке внутри сводки — в 1% визитов (Pew Research Center, июль 2025). Названный бренд всё равно влияет на то, кого рассмотрят, а на этом построена логика ментальной и физической доступности. Чтобы страницы цитировали, нужны GEO и контент, написанный для чтения машинами, как в материале про llms.txt и AI-читаемый контент. В руководстве Google сказано, что специальные файлы не нужны и что обычные SEO-практики Google по-прежнему действуют.
План Growth Lab начинается с такой точки отсчёта, чтобы любые траты на контент или PR можно было сравнить с измеренным разрывом: см. Growth Lab.
Как применять: Видимость в нейросетях: что это и как измерить по шагам
- Решите, что считать попаданием. Определите это до замеров. Упоминание — бренд назван в тексте ответа. Цитата — ссылка или карточка источника, ведущая на ваш домен. Фиксируйте оба признака отдельными полями «да/нет» для каждого ответа. Результат: письменное правило разметки, которое два человека применяют одинаково.
- Соберите набор промптов из ситуаций покупки. Пишите промпты от моментов, когда человек начинает искать: проблема, сравнение, бюджет, страна. Формулировки берите из записей звонков отдела продаж, обращений в поддержку и отзывов, добавьте к каждому промпту несколько вариантов. Включите небрендовые промпты, промпты со сравнением конкурентов и брендовые, а в отчёте показывайте их отдельно. Результат: 20–50 промптов, у каждого своя метка типа.
- Зафиксируйте условия запуска. Выберите ассистентов, версии моделей, страну, язык, режим с входом в аккаунт или без него и включён ли веб-поиск. Запишите это и не меняйте от замера к замеру. Результат: лист настроек, который прилагается к каждому набору данных.
- Прогоняйте каждый промпт много раз и сохраняйте сырые ответы. Повторяйте каждый промпт минимум 30–100 раз на каждом ассистенте, растянув запуски на несколько дней: одинаковые запуски дают разные ответы. Сохраняйте полный текст ответа и ссылки, которые в нём процитированы. Результат: таблица, где один ответ — одна строка, пока без выводов.
- Посчитайте долю упоминаний, долю цитат и долю голоса. Для каждого бренда доля упоминаний — это число ответов с его названием, делённое на все собранные ответы. Доля голоса — его упоминания, делённые на упоминания всех отслеживаемых брендов. К каждой доле добавьте доверительный интервал Уилсона. Результат: таблица долей с диапазонами, а не отдельные цифры.
- Сравнивайте замеры и закрывайте разрывы. Считайте изменение реальным, только когда диапазоны перестали пересекаться или сдвиг повторился в нескольких замерах. Посмотрите источники, которые нейросети цитируют там, где вас нет, создайте недостающие страницы и добейтесь недостающих сторонних упоминаний. Результат: короткий список разрывов, привязанных к конкретным промптам.
Примеры
Сеть стоматологических клиник в одном городе
Иллюстративный пример. Сеть отслеживает 30 промптов вроде «лучшая клиника для имплантации зубов в городе» и «сколько стоят виниры», каждый запущен 50 раз на двух ассистентах. Из 3 000 ответов (30 промптов, 50 запусков, два ассистента) сеть названа в 600, то есть доля упоминаний — 20%, а конкурент назван в 1 350, то есть в 45%. Как источник сеть процитирована только в 150 ответах. В списке цитат — страница цен конкурента и два местных справочника, поэтому команда сначала правит собственную страницу с ценами и свои профили в справочниках.
B2B-платёжный провайдер выходит на новый рынок
Иллюстративный пример. Платёжный провайдер отслеживает 40 небрендовых промптов о трансграничных выплатах и делит их на вопросы «что такое» и вопросы «какой провайдер выбрать». В ответах на «какой провайдер» он назван в 8%, а в ответах на «что такое» — в 30%. Разрыв означает, что покупатели видят бренд, пока изучают тему, но не видят, когда выбирают. Команда добавляет страницы сравнения, ищет сторонние обзоры и через четыре недели запускает те же промпты заново.
Когда применять
Применяйте, когда покупатели изучают рынок через ИИ-ассистентов ещё до обращения к вам, когда конкурентов цитируют в ответах, где хотели бы быть вы, или когда нужна точка отсчёта перед вложениями в контент, отзывы или диджитал-PR. Метод подходит категориям, где люди просят рекомендации: услуги, софт, клиники.
Когда не применять
Не берите, если покупатели вашей категории редко пользуются ассистентами, если повторные запуски вам не по карману или если вы собираетесь выдать один скриншот за показатель. Не считайте это рейтингом и не используйте для прогноза доли рынка: опубликованных данных о связи доли голоса в AI-ответах с продажами нет.
Частые ошибки
- Выдают один запуск за результат. Ответы меняются от запуска к запуску, поэтому единичный ответ и позиция в нём — в основном шум.
- Складывают упоминания и цитаты в одну цифру. Бренд могут назвать без ссылки, а ссылка может появиться, хотя в тексте бренда нет.
- Проверяют только брендовые промпты. Если бренд появляется, когда набрано его название, это мало говорит о том, встретят ли его покупатели, которые о нём не знают.
- Меняют настройки между замерами, например модель, страну или веб-поиск, а потом принимают разницу за прогресс.
- Усредняют ассистентов в один балл. Каждый ассистент опирается на свои источники, поэтому считайте их отдельно.
Вопросы и ответы
Что такое доля голоса в AI-ответах?
Это доля ответов нейросетей, в которых ваш бренд назван или процитирован, в сравнении с конкурентами, по фиксированному набору промптов, запущенному много раз. Идея пришла из рекламной доли голоса, но измеряют другое: считают появления в сгенерированных ответах, а не долю рекламных расходов.
Сколько нужно промптов и запусков?
Единого стандарта нет. SparkToro, исследование которого не проходило рецензирование, советует обычно не меньше 60–100 запусков на промпт. При 100 ответах и истинной доле около 50% 95-процентный интервал Уилсона составляет примерно 9,6 пункта в каждую сторону, так что небольшим изменениям между замерами верить нельзя.
Чем упоминание отличается от цитаты?
Упоминание — бренд назван в тексте ответа. Цитата — ссылка или карточка источника на страницу. Они бывают по отдельности. Считайте оба показателя: упоминание влияет на то, что запомнит покупатель, а цитата показывает, какие страницы использовал ассистент.
Это то же самое, что обычная доля голоса?
Нет. Обычная доля голоса — доля бренда в рекламных расходах категории. По данным IPA, собранным Бине и Филдом, доля голоса выше доли рынка связана с ростом. Для AI-ответов такого подтверждения нет, поэтому считайте показатель мерой видимости, а не прогнозом роста.
Можно ли отслеживать видимость в нейросетях сервисом?
Да. Сервисы вроде Ahrefs, Semrush, Profound и Peec запускают промпты и показывают видимость. Об охвате и точности они сообщают сами. Узнайте, сколько запусков на промпт они делают, можно ли выгрузить сырые ответы и показывают ли они интервалы.
Источники
- IPA, Presentation: The long and short of it, Les Binet and Peter Field, 2013
- Les Binet and Peter Field, Effectiveness in Context: a manual for brand building, IPA
- James C. Schroer, Ad Spending: Growing Market Share, Harvard Business Review, January 1990
- IPA, Binet presents fast, cheap, predictive Share of Search metric, October 2020
- Pranjal Aggarwal et al., GEO: Generative Engine Optimization, KDD 2024
- Berk Atil et al., Non-Determinism of Deterministic LLM Settings, 2024
- Evan Miller, Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations, 2024
- Melanie Sclar et al., Quantifying Language Models' Sensitivity to Spurious Features in Prompt Design, ICLR 2024
- Nelson F. Liu, Tianyi Zhang, Percy Liang, Evaluating Verifiability in Generative Search Engines, Findings of EMNLP 2023
- Horace He and Thinking Machines Lab, Defeating Nondeterminism in LLM Inference, September 2025
- Rand Fishkin, SparkToro, New research: AIs are highly inconsistent when recommending brands or products, January 2026
- Search Engine Journal, AI recommendations change with nearly every query, SparkToro finds, January 2026
- Google Search Central, AI features and your website
- Google Search Central, Guide to optimizing for generative AI features on Google Search
- Google, AI Mode in Google Search, March 2025
- Klaudia Jaźwińska and Aisvarya Chandrasekar, Tow Center for Digital Journalism, AI search has a citation problem, Columbia Journalism Review, March 2025
- Pew Research Center, Google users are less likely to click on links when an AI summary appears, July 2025
- OpenAI, Web search tool, API documentation
- Anthropic, Web search tool, API documentation
- Mahe Chen, Xiaoxuan Wang, Kaiwen Chen, Nick Koudas, Generative Engine Optimization: How to Dominate AI Search, 2025
- Lawrence D. Brown, T. Tony Cai, Anirban DasGupta, Interval Estimation for a Binomial Proportion, Statistical Science 16(2), 2001
- Ehrenberg-Bass Institute, Category entry points dissected: how they really contribute to growth
- Ahrefs, Brand Radar (vendor page)
- Semrush, AI Visibility Toolkit (vendor documentation)
- Profound (vendor page)
- Peec AI (vendor page)
Обновлено 15 октября 2026

Маркетинговое агентство или система роста: что нужно на каждом этапе масштабирования
Агентство подходит, пока фаундер сам ведёт большую часть процессов. Когда бизнес начинает копировать себя в новые точки и регионы, нужна система, которая ставит цели, проверяет гипотезы и отвечает за результат.
Агентство медицинского маркетинга: почему работа с клиникой буксует и какую модель используем мы
Большинство агентств отвечают за клик, а за регистратуру не отвечает никто. Как мы строим маркетинг клиники в трёх горизонтах, на каких исследованиях это основано и что дал один год работы.
Тестирование рекламных каналов: почему тест затухает на третьем месяце
Большинство тестов нового рекламного канала заканчиваются не решением. Они заканчиваются, когда кончился бюджет, поменялась атрибуция или все тихо перестали открывать дашборд.